原著:Jacob Austin 等,Google DeepMind,《How to Scale Your Model》。本章原文。原文版本:
173fb0851d7e,MIT 许可。
本章为完整范围的机器辅助中文初译
简介:本章讨论 LLM 训练中的四种主要并行方案:数据并行、全分片数据并行(FSDP)、张量并行和流水线并行,并分别计算它们在什么条件下会受通信限制。
Scaling Book 中文导读 · 上一章:Transformer 数学 · 原著目录
扩展是什么意思?
“模型扩展”的目标是能够增加用于训练或推理的芯片数量,同时实现吞吐量的成比例、线性增加(我们称之为强扩展)。虽然单个芯片上的性能取决于内存带宽和 FLOP 之间的权衡,但集群级别的性能取决于通过将芯片间通信与有用的 FLOP 重叠来隐藏芯片间通信。这并非易事,因为增加芯片数量会增加通信负载,同时减少我们可以用来隐藏它的每台设备的计算量。正如我们在第 3 章:分片矩阵与矩阵乘法中看到的,分片矩阵乘法通常需要昂贵的 AllGather 或 ReduceScatter,这可能会阻止 TPU 执行有用的工作。本节的目标是找出这些通信何时变得“太贵”。
在本节中,我们将讨论四种常见的并行方案:(纯)数据并行、完全分片数据并行(FSDP / ZeRO 分片)、张量并行(也称为模型并行)和(简而言之)管道并行。对于每一个,我们将展示我们产生的通信成本以及在什么时候该成本开始成为我们计算成本的瓶颈。(原注:我们将重点关注通信边界 - 因为虽然内存容量限制很重要,但在预训练期间使用重新实现(激活检查点)和大量芯片时,它们通常不会限制我们。我们在这里也不讨论 MoE 的专家并行性——这大大扩展了设计空间,仅讨论密集 Transformer 的基本情况。)在本节中,你可以只关注芯片间通信成本,因为只要我们有足够大的单芯片批量大小,从 HBM 到 MXU 的数据传输就已经与计算重叠。
我们将使用以下符号来简化本节中的计算。
| 符号 | 含义(模型参数) |
|---|---|
| $D$ | 模型隐藏维度,即残差流的特征维度 $d_{\text{model}}$ |
| $F$ | 前馈网络的中间维度 $d_{\text{ff}}$ |
| $B$ | 全局批量中的 token 总数,不是每台设备上的 token 数 |
| $T$ | 序列长度,即每条序列包含的 token 数 |
| $L$ | 模型的层数 |
| 符号 | 含义(硬件特性) |
|---|---|
| $C$ | 每块芯片的计算吞吐量,单位为 FLOPs/s |
| $W$ | 网络带宽,采用双向带宽口径;常用下标区分 $W_{\text{ici}}$ 与 $W_{\text{dcn}}$ |
| $X$ | 设备网格沿 X 轴的芯片数量 |
| $Y$ | 设备网格沿 Y 轴的芯片数量 |
| $Z$ | 设备网格沿 Z 轴的芯片数量 |
为了简单起见,我们将 Transformer 近似为 MLP 块的堆栈——正如我们在第 4 章:Transformer 数学中看到的那样,对于较大模型,注意力只占 FLOP 的一小部分。我们还将忽略门控 matmul,为每层留下以下简单结构:
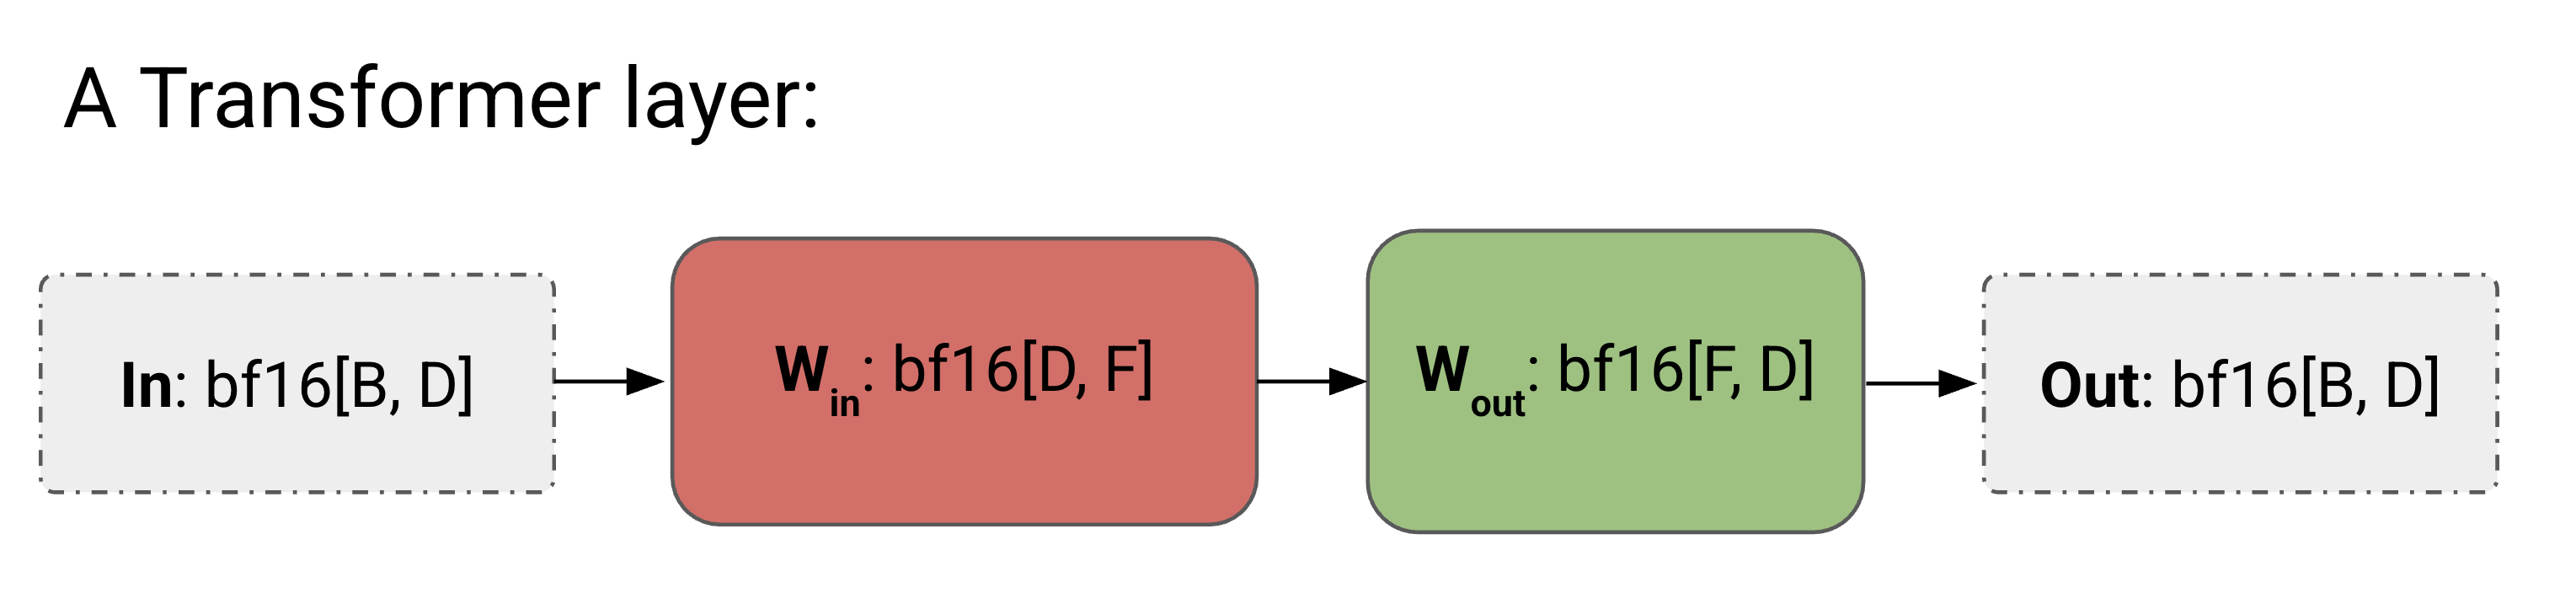
图: 简化的 Transformer 层。我们将每个 FFW 块视为两个矩阵 Win 的堆栈:bf16[D, F](上投影)和Wout: bf16[F, D](下投影),带输入In:bf16[B, D]。
这是我们的小型 Transformer 的完整算法,没有并行性。
前向传播:需要计算Loss[B]
- Tmp[B, F] = In[B, D] *D Win[D, F]
- Out[B, D] = Tmp[B, F] *F Wout[F, D]
- Loss[B] = …
反向传播:需要计算dWout[F, D], dWin[D, F]
- dOut[B, D] = …
- dWout[F, D] = Tmp[B, F] *B dOut[B, D]
- dTmp[B, F] = dOut[B, D] *D Wout[F, D]
- dWin[D, F] = In[B, D] *B dTmp[B, F]
- dIn[B, D] = dTmp[B, F] *F Win[D, F];前一层需要
我们提供这个是为了与添加了通信的算法进行比较。
以下是我们将讨论的 4 种并行方案。每个方案都可以被认为是由上图中 In、Win、Wout 和 Out 的分片唯一定义的。
1.数据并行性: 沿批次分片的激活、参数和优化器状态在每个设备上复制。通信仅发生在反向传播期间。
$$\text{In}[B_X, D] \cdot_D W_\text{in}[D, F] \cdot_F W_\text{out}[F, D] \rightarrow \text{Out}[B_X, D]$$
2.完全分片的数据并行性(FSDP 或 ZeRO-3): 激活按批次分片(如纯数据并行),参数沿同一网格轴分片,并在前向传播中使用之前及时收集。优化器状态也按批次进行分片。减少重复的内存。
$$\text{In}[B_X, D] \cdot_D W_\text{in}[D_X, F] \cdot_F W_\text{out}[F, D_X] \rightarrow \text{Out}[B_X, D]$$
3.张量并行性(也称为威震天分片或模型并行性): 激活沿 D ($d_\text{model}$) 分片,参数沿 F ($d_{ff}$) 分片。每个块之前和之后的 AllGather 和 ReduceScatter 激活。与 FSDP 兼容。
$$\text{In}[B, D_Y] \cdot_D W_\text{in}[D, F_Y] \cdot_F W_\text{out}[F_Y, D] \rightarrow \text{Out}[B, D_Y]$$
4.管道并行性: 权重沿层维度分片,激活沿层维度微批处理和滚动。管道阶段之间的通信很少(仅在单跳上移动激活)。滥用符号:
$$\text{In}[L_Z, B, D][i] \cdot_D W_\text{in}[L_Z, D, F][i] \cdot_F W_\text{out}[L_Z, F, D][i] \rightarrow \text{Out}[L_Z, B, D][i]$$
数据并行性
语法:
$$\text{In}[B_X, D] \cdot_D W_\text{in}[D, F] \cdot_F W_\text{out}[F, D] \rightarrow \text{Out}[B_X, D]$$
当你的模型适合单个芯片时,即使批量大小很小(> 240 个token,以便受计算受限),你应该始终使用简单的数据并行性。只要 TPU 的数量小于我们的批量大小,纯数据并行就会将我们的激活分割到任意数量的 TPU 上。前向传播不涉及通信,但在每个步骤结束时,每个 TPU 都会对其本地梯度执行 AllReduce,以在更新参数之前同步它们。
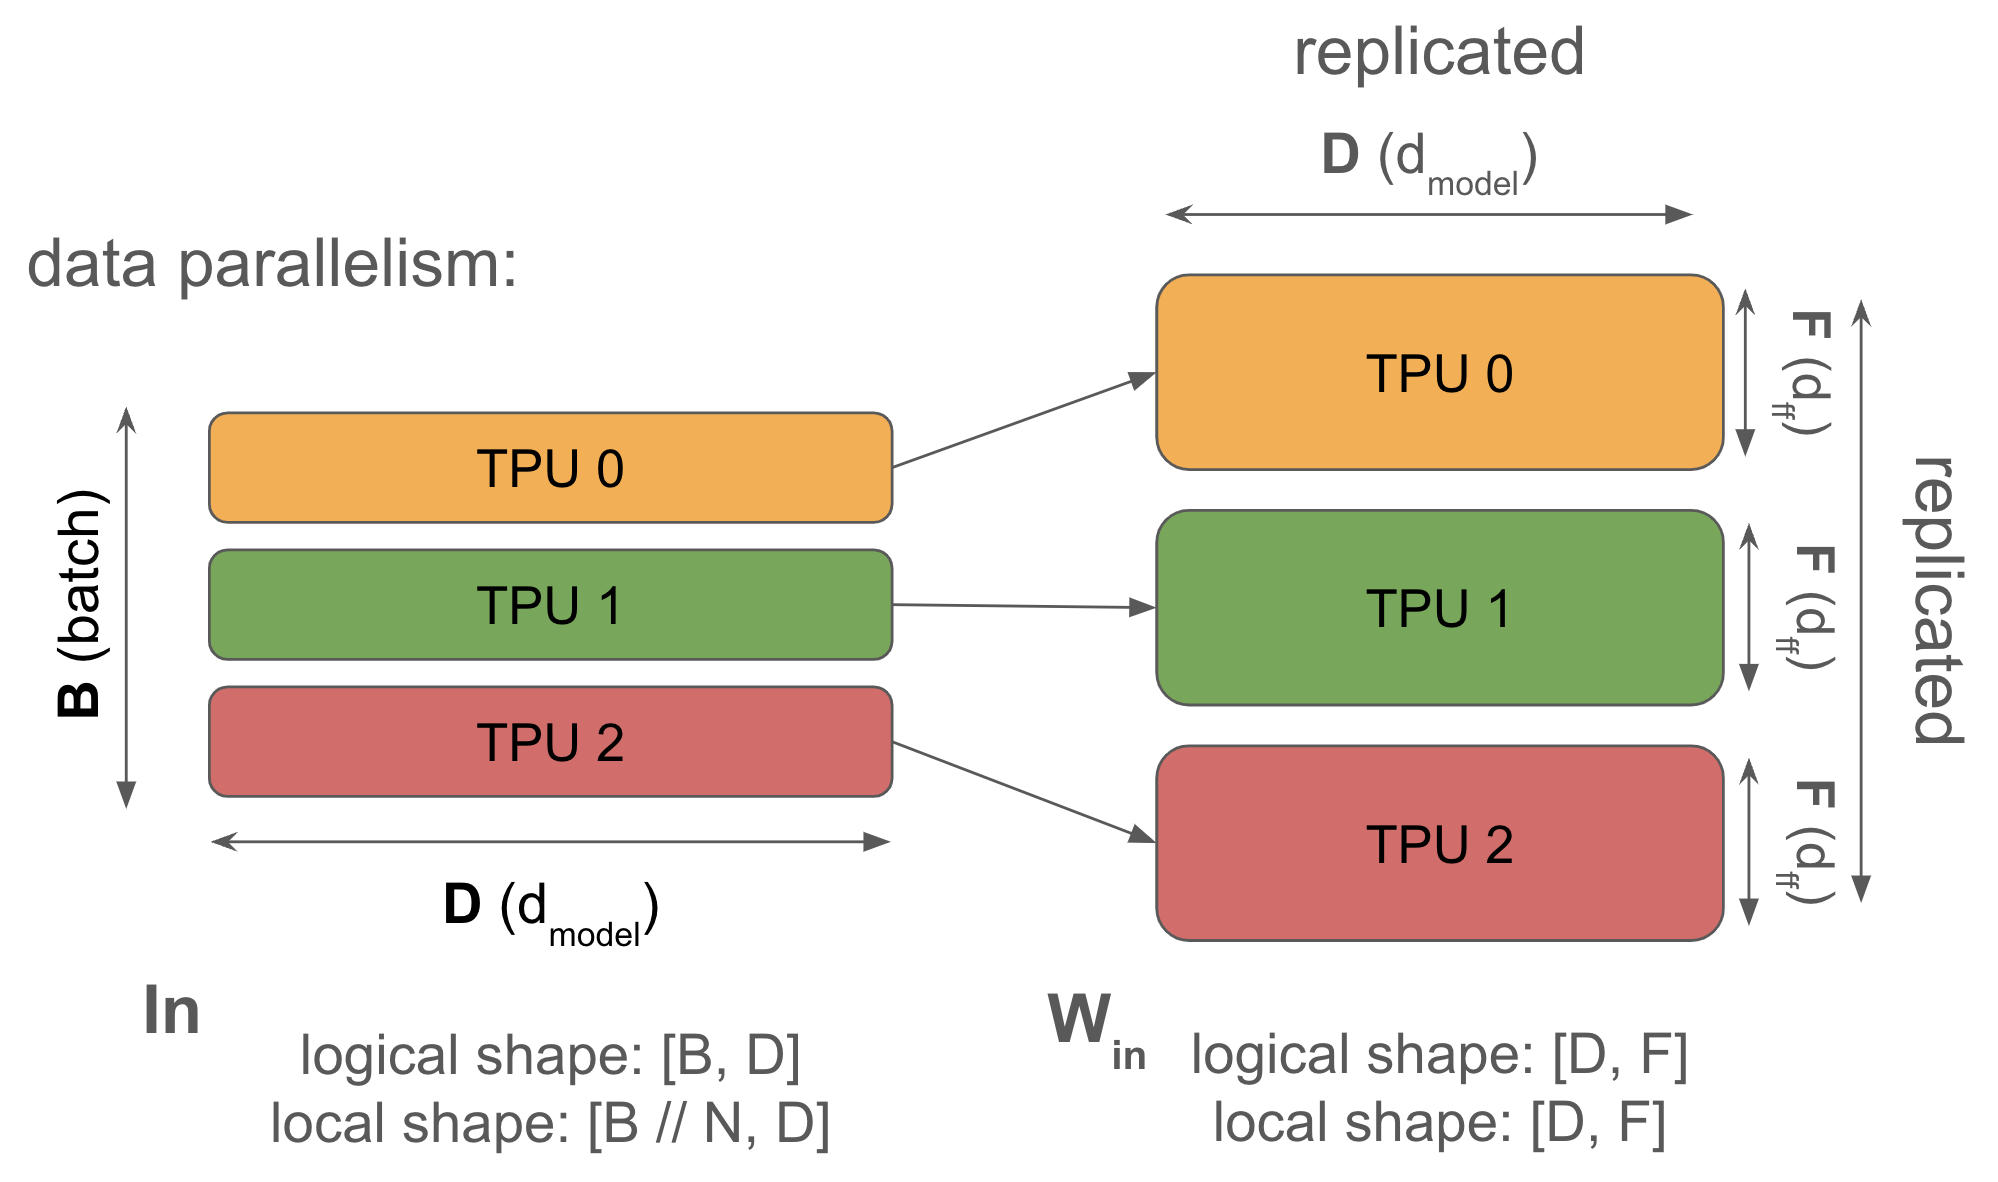
图: 纯数据并行图(前向传播)。我们的激活(左)沿着批次维度完全分片,并且我们的权重完全复制,因此每个 TPU 都有相同的权重副本。这意味着我们权重的总内存增加了 N 倍,但前向传播不需要通信。
这里是前向和反向传播的完整算法。我们滥用符号将 dL/dOut 写为 dOut,纯粹是为了紧凑性。
纯数据并行算法:
前向传播:需要计算Loss[BX]
- Tmp[BX, F] = In[BX, D] *D Win[D, F]
- Out[BX, D] = Tmp[BX, F] *F Wout[F, D]
- Loss[BX] = …
反向传播:需要计算dWout[F, D], dWin[D, F]
- dOut[BX, D] = …
- dWout[F, D] {UX} = Tmp[BX, F] *B dOut[BX, D]
- dWout[F, D] = AllReduce(dWout[F, D] {UX});不在关键路径上,可以异步执行
- dTmp[BX, F] = dOut[BX, D] *D Wout[F, D]
- dWin[D, F] {UX} = In[BX, D] *B dTmp[BX, F]
- dWin[D, F] = AllReduce(dWin[D, F] {UX});不在关键路径上,可以异步执行
- dIn[BX, D] = dTmp[BX, F] *F Win[D, F];前一层需要
我们忽略损失函数的细节,缩写为$\text{Tmp} = W_\text{in} \cdot \text{In}$。请注意,虽然我们的最终损失是平均值 AllReduce(Loss[BX]),但我们只需要在平均权重梯度时计算反向传播上的 AllReduce。
请注意,前向传播没有通信 - 一切都在反向传播中!反向传播还有一个很好的特性,即 AllReduce 不在“关键路径”中,这意味着每个 AllReduce 都可以在方便的时候执行,并且不会阻止你执行后续操作。如果总体通信成本超过我们的总计算成本,那么它仍然会成为我们的瓶颈,但从实现的角度来看,它要宽容得多。我们将看到模型/张量并行性不具有此属性。
为什么采用这种方案?纯数据并行沿批量维度切分激活,降低每块设备的激活内存压力。只要有更多芯片分担批量,整体批量就可以持续增大。训练时激活往往占据主要内存,因此这很有用。
为什么不这样做? 纯数据并行对于减少模型参数或优化器状态的内存压力没有任何作用,这意味着纯数据并行对于大规模的有趣模型很少有用,因为我们的参数和优化器状态不适合单个 TPU。为了给人一种规模感,如果我们使用 bf16 中的参数和 fp32 中的优化器状态与 Adam 进行训练(原注:Adam 存储参数、一阶和二阶累加器。由于参数位于 bfloat16 中,优化器状态位于 float32 中,这为我们提供了每个参数 2 + 8 = 10 字节),可以容纳的最大模型约有 $\text{TPU memory}/10$ 个参数。例如,在具有 96GB HBM 和纯数据并行的 TPU v5p 芯片上,这大约是 90 亿参数。
要点:采用 Adam 和纯数据并行时,可训练模型的参数量上限为 $\text{num_params}=\text{HBM per device}/10$。在 TPU v5p 上,约为 90 亿参数。(原注:这里尚未计入梯度检查点,所以这种配置实际上并不实用;它对应批量只有 1 个 token 时的绝对最低内存需求。)
为了使其在训练期间对真实模型有用,我们需要至少部分地分割模型参数或优化器。
什么时候我们会因通信而成为瓶颈? 正如我们在上面看到的,每层有两个 AllReduce,每个大小为 $2DF$(对于 bf16 权重)。数据并行何时使我们的通信受到限制?
如上表所示,令 $C$ 表示每芯片 FLOPs,$W_{\text{ici}}$ 表示双向网络带宽,$X$ 表示批次分区的分片数量(原注:我们假设此分区是通过 ICI 网格完成的,因此相关网络带宽为 $W_\text{ici}$)。让我们计算执行相关 matmul 所需的时间 $T_\text{math}$ 以及通信时间 $T_\text{comms}$。由于这种并行方案在前向传播中不需要通信,因此我们只需要为反向传播计算这些量。
通信时间:从上一节我们知道,在一维网格中执行 AllReduce 所需的时间仅取决于 AllReduce 数组的总字节数和 ICI 带宽 $W_\text{ici}$;具体来说,AllReduce 时间为 $2 \cdot \text{total bytes} / W_\text{ici}$。由于我们需要对 $W_\text{in}$ 和 $W_\text{out}$ 进行 AllReduce,因此每层有 2 个 AllReduce。 每个 AllReduce 都是一个权重矩阵,即 $DF$ 参数数组,或 $2DF$ 字节。将所有这些放在一起,单层中 AllReduce 的总时间为
$$\begin{align}
T_\text{comms} &= \frac{2 \cdot 2 \cdot 2 \cdot D \cdot F}{W_\text{ici}}. \
\end{align}$$
Matmul 时间: 每层在前向传播中包含两个 matmul,或在反向传播中包含四个 matmul,每层都需要 $2(B/X)DF$ FLOP。因此,对于反向传播中的单个层,我们有
$$\begin{align}
T_\text{math} &= \frac{2 \cdot 2 \cdot 2 \cdot B \cdot D \cdot F}{X \cdot C} \
\end{align}$$
由于我们重叠,每层的总时间是这两个量的最大值:
$$\begin{aligned}
T &\approx \max(\frac{8 \cdot B \cdot D \cdot F}{X \cdot C}, \frac{8 \cdot D \cdot F}{W_\text{ici}}) \
T &\approx 8 \cdot D \cdot F \cdot \max(\frac{B}{X \cdot C}, \frac{1}{W_\text{ici}})
\end{aligned}$$
当 $T_\text{math}/T_\text{comms} > 1$ 时,或者当
$$\begin{align}
\frac{B}{X} > \frac{C}{W_\text{ici}}.
\end{align}$$
结果是,为了保持数据并行性的计算受限,我们需要每设备批量大小 $B/X$ 超过 ICI 操作强度 $C/W_\text{ici}$。这最终是由于计算时间随每个设备的批量大小而变化,而通信时间与该数量无关(因为我们正在传输模型权重)。请注意 $B/X > C/W_\text{ici}$ 条件与单设备计算受限规则 $B > 240$ 的相似之处;在这种情况下,该规则也来自这样一个事实:计算时间随批量大小而变化,而数据传输大小(在 $B \ll F, D$ 机制中)与批量大小无关。
让我们输入一些实数来了解一下规模。对于 TPUv5p、C=4.6e14 和 W=2 * 9e10 用于 ICI 上的 1D 数据并行性,因此 我们每个芯片的批量大小必须至少为 2,550,以避免受到通信受限。由于我们可以在多个轴上进行数据并行,如果我们将 TPUv5p pod 的所有三个轴专用于纯数据并行,我们的带宽 $W_\text{ici}$ 会增加 3 倍,并且可以缩小到每个 TPU 仅 BS=850 或每个 pod 每批 760 万个token(8960 个芯片)! 这告诉我们,纯数据并行很难成为瓶颈!
注意[上下文并行性]:在本节中,$B$ 始终指代总批次大小以token为单位。然而,显然我们的批次是由许多不同的序列组成的,那么这是如何工作的呢?就 MLP 而言,token就是token!它们属于同一序列还是两个不同序列并不重要。因此,我们或多或少可以自由地在批处理和序列维度上进行数据并行:我们称之为上下文并行或序列并行,但你可以将其简单地视为另一种数据并行。注意力比 MLP 更棘手,因为我们做了一些跨序列计算,但这可以通过在注意力期间收集 KV 或 Q 并仔细重叠 FLOP 和通讯(通常使用称为“环注意力”的东西)来处理。在本节中,我们将完全忽略序列维度并假设一定量的批处理或序列并行性。
关于多个网格轴的注意事项: 我们应该快速注意多个轴如何影响可用带宽。当我们针对给定的并行策略使用多个网格轴时,我们可以获得更多的带宽。
- 定义: $M_X$($M_Y$、$M_Z$ 等)是给定并行策略跨越的硬件网格轴的数量。
- 效果(带宽受限): 使用 $M$ 轴提供($\approx M$ 倍)聚合链路带宽,因此集体时间尺度为 $\propto 1/M_X$。
全分片数据并行 (FSDP)
语法:
$$\text{In}[B_X, D] \cdot_D W_\text{in}[D_X, F] \cdot_F W_\text{out}[F, D_X] \rightarrow \text{Out}[B_X, D]$$
完全分片数据并行性(通常称为 FSDP 或 ZeRO 分片)将模型优化器状态和权重拆分到数据并行分片上,并根据需要有效地收集和分散它们。与纯数据并行相比,FSDP 极大地减少了每个设备的内存使用量并节省了反向传播 FLOP,而开销非常小。
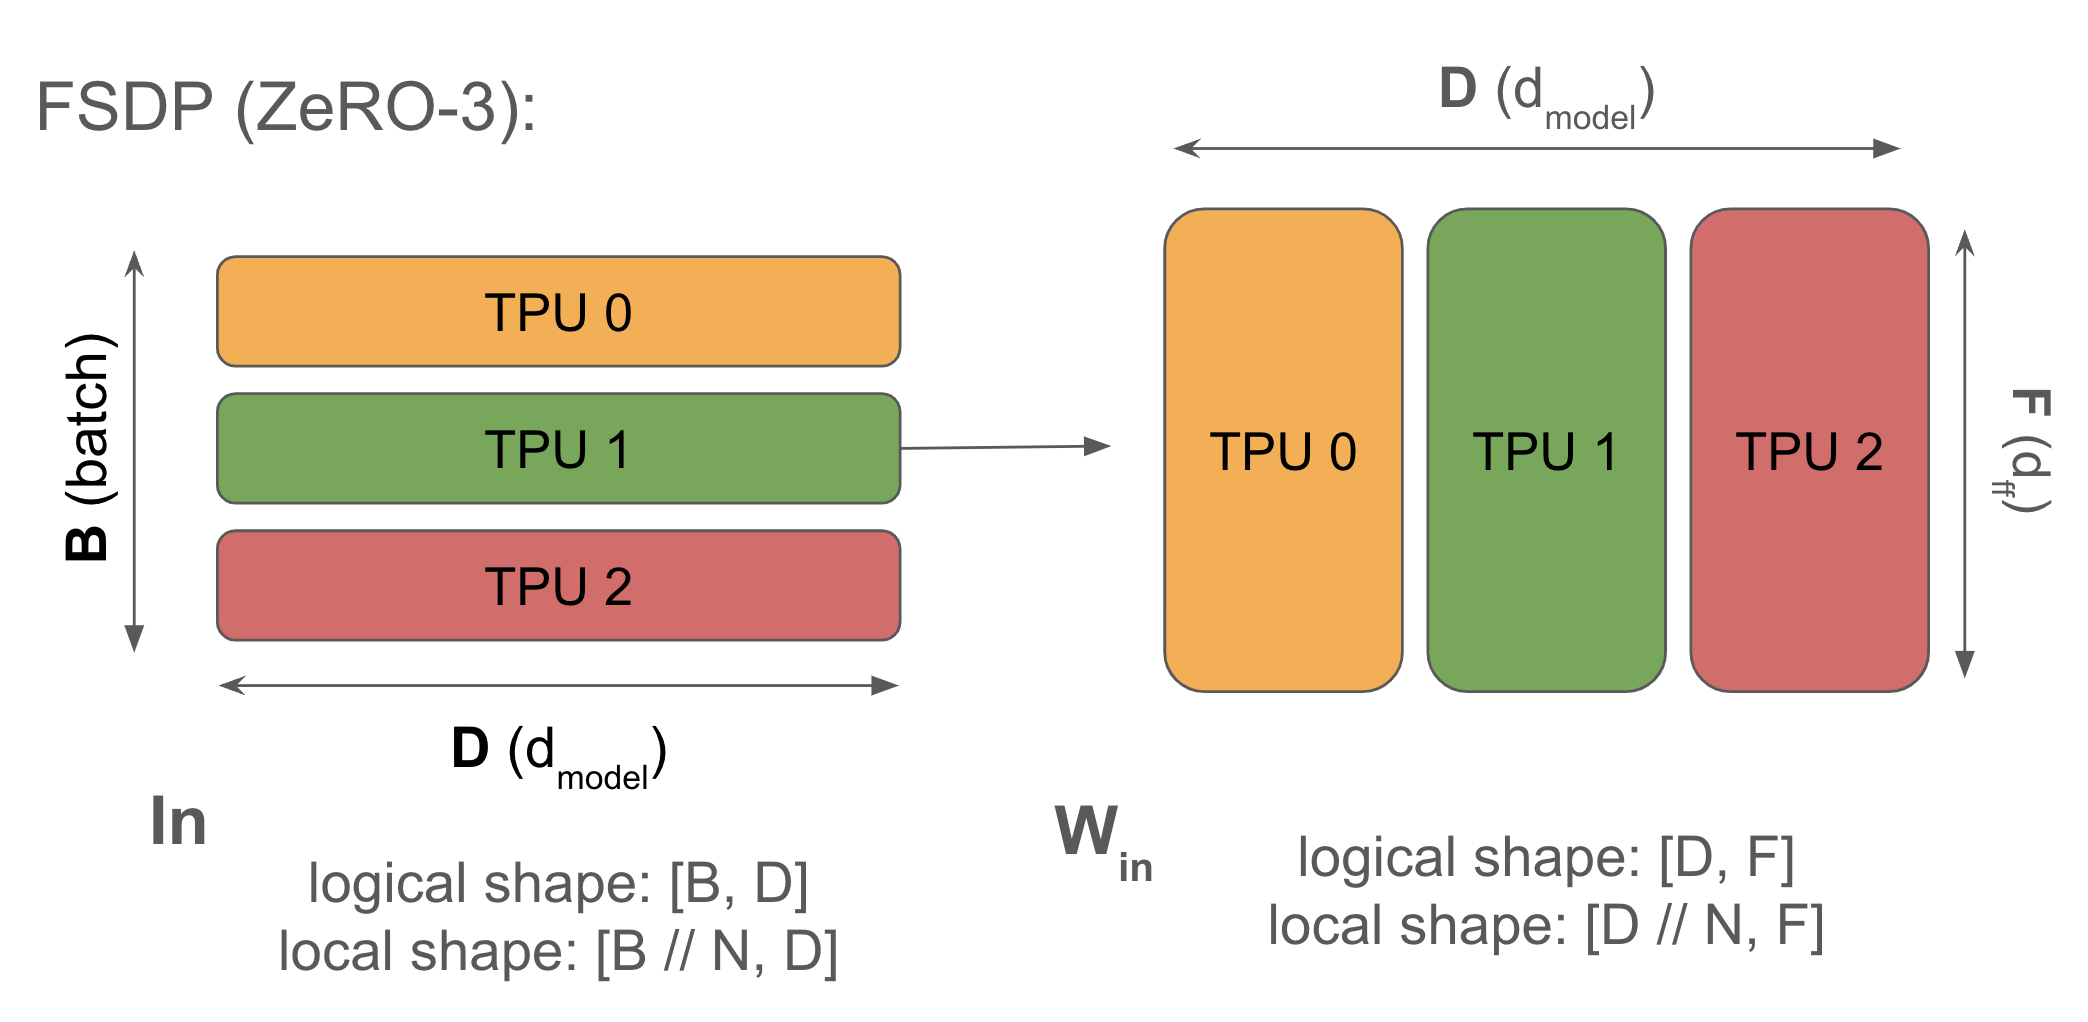
图: FSDP 将 Win 的契约维度和 Wout 的输出维度沿数据维度进行分片。这会减少内存,但(从第 3 节开始)要求我们在执行 matmul 之前收集 W 的权重。请注意,激活(左) 并未沿着收缩维度 进行分片,这迫使我们聚集。 请注意,我们的权重优化器状态同样沿着收缩维度进行分片。
你会记得(来自第 3 章:分片矩阵与矩阵乘法)AllReduce 可以分解为 AllGather 和 ReduceScatter。这意味着,我们可以将权重和优化器状态跨芯片分片,在前向传播过程中在每一层进行 AllGather,并在反向传播过程中在权重上进行 ReduceScatter,而不需要额外的成本,而不是为标准数据并行性执行完整梯度 AllReduce。
这里是FSDP的完整算法。
完全分片数据并行性 (FSDP):
前向传播:需要计算Loss[BX]
- Win[D, F] = AllGather(Win[DX, F]);不在关键路径上,可以在前一层计算时执行
- Tmp[BX, F] = In[BX, D] *D Win[D, F];可以释放 Win[D, F],现在不再需要
- Wout[F, D] = AllGather(Wout[F, DX]);不在关键路径上,可以在前一层计算时执行
- Out[BX, D] = Tmp[BX, F] *F Wout[F, D]
- Loss[BX] = …
反向传播:需要计算dWout[F, DX], dWin[DX,F]
- dOut[BX, D] = …
- dWout[F, D] {UX} = Tmp[BX, F] *B dOut[BX, D]
- dWout[F, DX] = ReduceScatter(dWout[F, D] {UX});不在关键路径上,可以异步执行
- Wout[F, D] = AllGather(Wout[F, DX]);可以提前执行
- dTmp[BX, F] = dOut[BX, D] *D Wout[F, D] (can throw away Wout[F, D] here)
- dWin[D,F] {UX} = In[BX, D] *B dTmp[BX, F]
- dWin[DX, F] = ReduceScatter(dWin[D, F] {UX}) (not on critical path, can be done async)
- Win[D, F] = AllGather(Win[DX, F]);可以提前执行
- dIn[BX, D] = dTmp[BX, F] *F Win[D, F];前一层需要;可以释放 Win[D, F],这里不再需要
这也称为“零冗余优化器”中的“零分片”,因为我们不执行任何不必要的计算或存储任何不必要的状态。 ZeRO-{1,2,3}分别用于指以这种方式对优化器状态、梯度和权重进行分片。由于所有通信成本相同(原注:从技术上讲,FSDP 在前向传播中添加了纯 DP 所没有的通信,但这与反向传播的比例相同,因此它应该对通信屋顶线没有影响。这里的关键是ZeRO-3将反向传播的AllReduce变成了AllGather和ReduceScatter,它们具有相同的总通信量。),我们基本上总是可以进行ZeRO-3分片,它将参数、梯度和优化器状态分片到一组设备上。
我们为什么要这样做? 标准数据并行涉及大量重复工作。每个 TPU AllReduce 完整梯度,然后更新完整优化器状态(所有 TPU 上的工作相同),然后更新参数(再次完全重复)。对于ZeRO分片(对梯度/优化器状态进行分片),你可以ReduceScatter梯度,而不是AllReduce,仅更新优化器状态的分片,更新参数的分片,然后根据前向传播所需的AllGather参数。
我们什么时候会因通信而成为瓶颈? 我们的相对 FLOP 和通信成本与纯数据并行完全相同,因为反向传播中的每个 AllReduce 都变成了 AllGather + ReduceScatter。回想一下,AllReduce 是作为 AllGather 和 ReduceScatter 实现的,每个都有一半的成本。这里我们对前向传播进行建模,因为它与反向传播具有相同的 FLOPs-to-comms 比率:
$$\begin{aligned}
T_\text{math} &= \frac{2 \cdot 2 \cdot B \cdot D \cdot F}{X \cdot C} \
T_\text{comms} &= \frac{2 \cdot 2 \cdot D \cdot F}{W_\text{ici}} \
T &\approx \max\left(\frac{4 \cdot B \cdot D \cdot F}{X \cdot C}, \frac{4 \cdot D \cdot F}{W_\text{ici}}\right) \
T &\approx 4 \cdot D \cdot F \cdot \max\left(\frac{B}{X \cdot C}, \frac{1}{W_\text{ici}}\right)
\end{aligned}$$
因此,与纯数据并行一样,当 $B/X > C/W_\text{ici}$ 时,即当每设备批量大小 $B/X$ 超过“ICI 操作强度”$C/W_\text{ici}$(对于 v5p 为 4.59e14 / 1.8e11 = 2550)时,我们会受到计算受限。这对我们来说非常好,因为这意味着如果每设备批量大小足够大,能够满足纯数据并行的计算受限条件,就可以在不离开计算受限区间的前提下升级到 FSDP,从而节省大量参数和优化器状态内存。尽管我们确实必须在前向传播中添加通信,但这种成本并不重要,因为它只是与前向传播 FLOP 重叠。
要点: 当每个设备的批量大小小于 $2550 / M_X$ 时,FSDP 和纯数据并行都会在 TPUv5 上受到带宽受限,其中 $M_X$ 是网格轴的数量。
例如,DeepSeek-V2(最近唯一发布有关其训练批量大小信息的强大模型之一)使用约 40M token的批量大小。 这将使我们能够在达到带宽受限之前扩展到大约 47,000 个芯片,或大约 5 个 TPUv5 Pod。
对于经过大约 6.3e24 (15e12 * 70e9 * 6) FLOP 训练的 LLaMA-3 70B,我们可以将一批 16M token拆分到大约 16e6 / (2550 / 3) = 18,823 芯片(大约 2 个 8960 个芯片的 Pod)上,每个 4.59e14 FLOP 以 50% 峰值 FLOP 利用率(通常称为 MFU)运行,并且大约需要 17 天的时间来训练。不错!但让我们探讨一下如何做得更好。
关于关键批量大小的注意事项:有些不直观的是,随着总批量大小的减小(芯片数量固定),我们的通信瓶颈变得更加严重。只要我们能够不断增加批量大小,数据并行性和 FSDP 就可以让我们扩展到任意数量的芯片!然而,在实践中,随着批量大小的增加,我们往往会看到训练的回报递减,因为我们的梯度几乎没有噪声。我们有时也会看到训练不稳定。因此,在“无限计算机制”中寻找最佳分片方案的游戏通常从由缩放定律确定的固定批量大小和已知(大量)芯片开始,然后旨在找到一种分区,使我们能够在如此多的芯片上适应小批量大小。
张量并行性
语法:
$$\text{In}[B, D_Y] \cdot_D W_\text{in}[D, F_Y] \cdot_F W_\text{out}[F_Y, D] \rightarrow \text{Out}[B, D_Y]$$
本章使用 $Y$ 表示张量并行轴,以便后面与 FSDP 结合。
在完全分片的数据并行 AllReduce 中,我们跨芯片移动权重。我们还可以对模型的前馈维度进行分片,并在层中移动激活——这称为“一维模型并行性”或 Megatron 分片。这可以解锁每个 Pod 更小的有效批量大小。下图展示了以这种方式分片的单个矩阵示例:
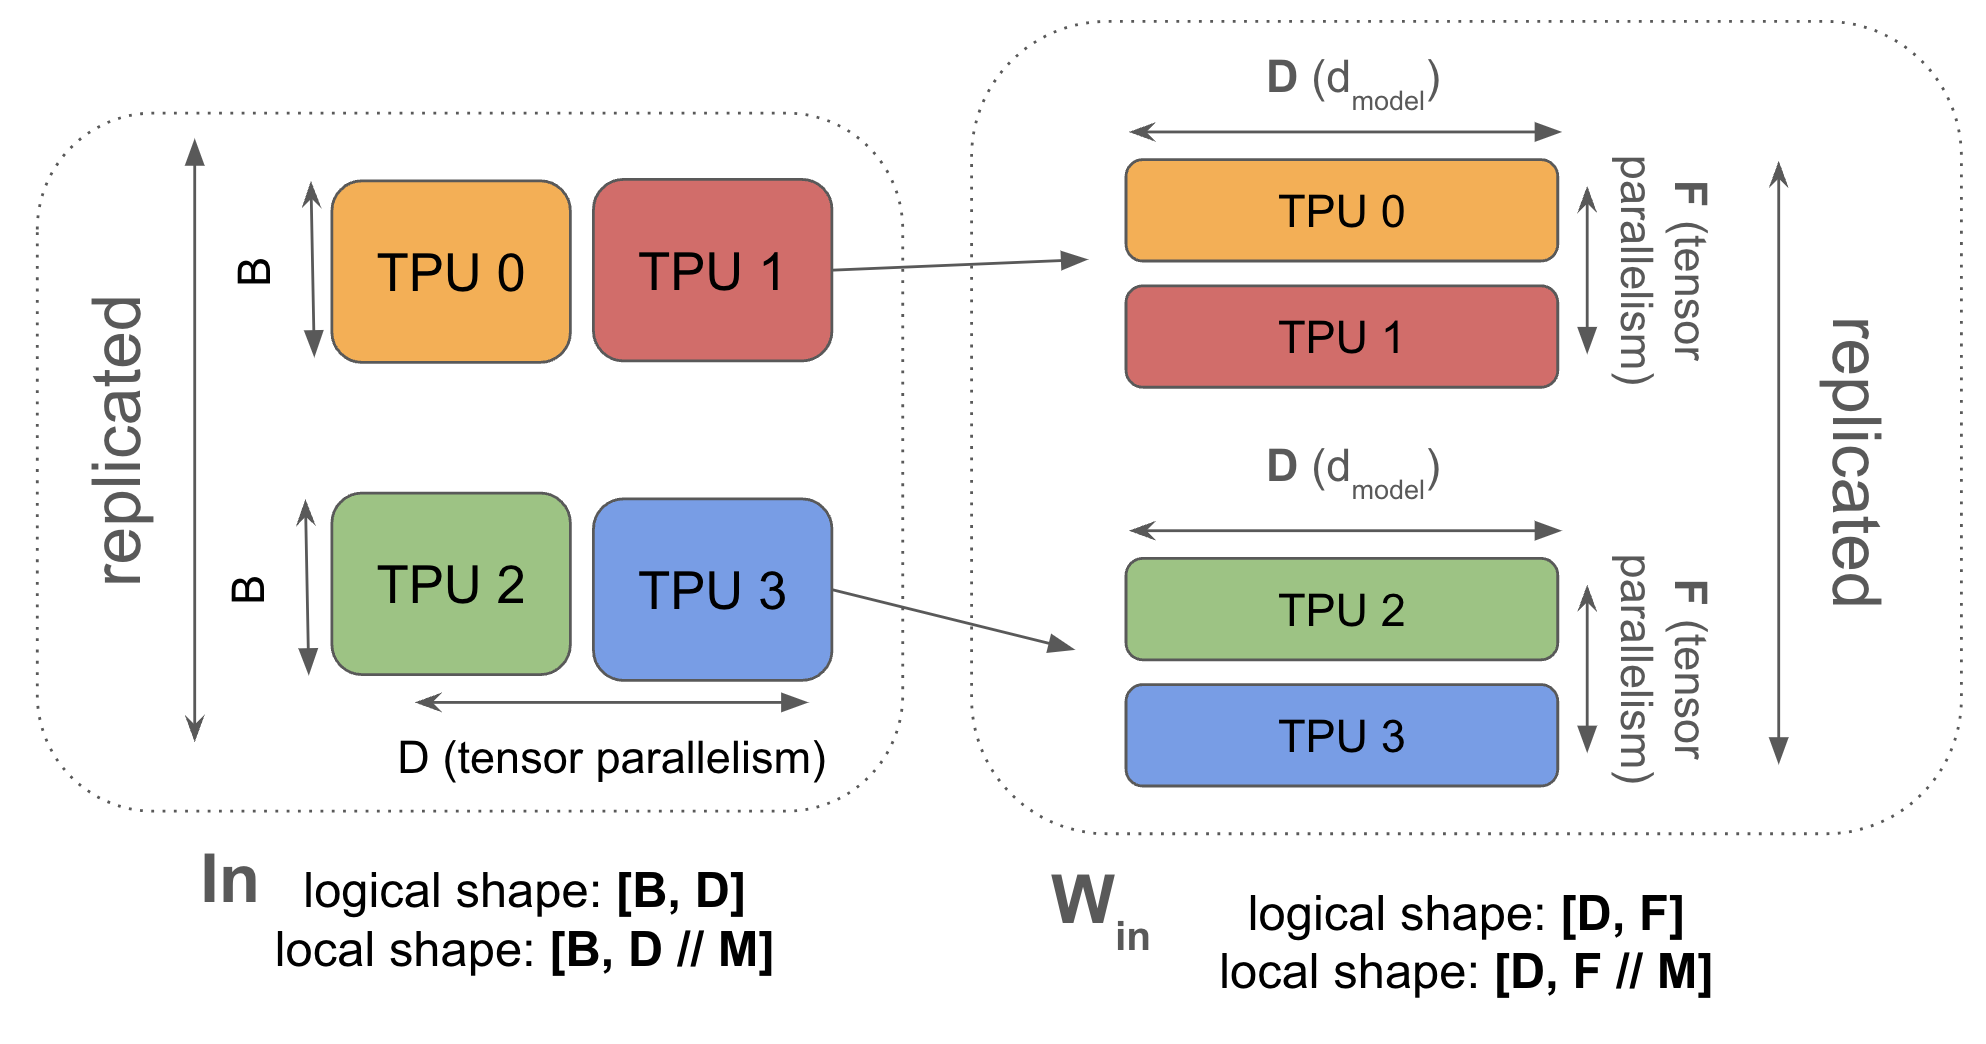
图: 基本张量并行性的示例。由于我们仅在 Y 上对激活进行分片(与在 FSDP 中对 X 进行分片不同),因此我们在 X 上复制激活。使用我们的标准语法,这是 A[B, DY] * B[D,FY] - > C[B,FY]。因为我们只在收缩维度之一上进行分片,所以我们通常在 matmul 之前 AllGather 激活 A。
如前所述,在[B,DY]*D Win[D, FY] *F Wout[FY,D] -> Out[B, DY] 意味着我们必须在第一个 matmul 之前收集激活值。当激活值小于权重时,这比 ZeRO 分片更便宜。 这通常仅在添加一定量的 ZeRO 分片(这会减少聚集的大小)时才成立。这是我们倾向于混合使用 ZeRO 分片和张量并行的原因之一。
这是张量并行的算法!
张量并行度:
前向传播:需要计算Loss[B]
- In[B, D] = AllGather(In[B, DY]) (on critical path)
- Tmp[B, FY] = In[B, D] *D Win[D, FY] (not sharded along contracting, so no comms)
- Out[B, D] {UY} = Tmp[B, FY] *F Wout[FY, D]
- Out[B, DY] = ReduceScatter(Out[B, D] {UY}) (on critical path)
- Loss[B] = …
反向传播:需要计算 dWout[FY, D], dWin[D, FY]
- dOut[B, DY] = …
- dOut[B, D] = AllGather(dOut[B, DY]) (on critical path)
- dWout[FY, D] = Tmp[B, FY] *B dOut[B, D]
- dTmp[B, FY] = dOut[B, D] *D Wout[FY, D] (can throw away dOut[B, D] here)
- In[B, D] = AllGather(In[B, DY]) (this can be skipped by sharing with (1) from the forward pass)
- dWin[D, FY] = In[B, D] *B dTmp[B, FY]
- dIn[B, D] {UY} = dTmp[B, FY] *F Win[D, FY] (needed for previous layers)
- dIn[B, DY] = ReduceScatter(dIn[B, D] {UY}) (on critical path)
张量并行的一个好处是它可以与 Transformer 前向传播中的两个矩阵很好地交互。天真地,我们会在两个矩阵之后分别执行 AllReduce。但这里我们首先做 In[B, DY] * Win[D, FY] -> Tmp[B, FY] 然后 **Tmp[B, FY] * Wout[FY,D] -> 输出[B,DY]**。这意味着我们在开始时 AllGather In ,在最后 ReduceScatter Out ,而不是执行 AllReduce。
这有多昂贵? 我们只对前向传播进行建模 - 反向传播只是这里每个操作的转置。在一维张量并行中,我们在第一个 matmul 之前 AllGather 激活,并在第二个 matmul 之后减少它们的激活,一次发送两个字节 (bf16)。让我们弄清楚什么时候我们会遇到沟通瓶颈。
$$\begin{align}
T_\text{math} & = \frac{4 \cdot B \cdot D \cdot F}{Y \cdot C} \
T_\text{comms} & =
\frac{2 \cdot 2 \cdot (B \cdot D)}{W_\text{ici}}\
\textnormal{T} & \approx \max \left(\frac{4 \cdot B \cdot D \cdot F}{Y \cdot C}, \frac{2 \cdot 2 \cdot (B \cdot D)}{W_\text{ici}}\right)
\end{align}$$
注意到我们希望计算成本大于通信成本,我们得到:
$$\begin{align}
\frac{4 \cdot B \cdot D \cdot F}{Y \cdot C} > \frac{2 \cdot 2 \cdot (B \cdot D)}{W_\text{ici}}
\end{align}$$
$$\begin{align}
\frac{F}{Y \cdot C} > \frac{1}{W_\text{ici}}
\end{align}$$
$$\begin{align}
F > Y \cdot \frac{C}{W_\text{ici}}
\end{align}$$
因此,例如,对于 TPUv5p,bf16 中的 $C / W_{ici} = 2550$,因此我们只能进行最多 $Y < F / 2550$ 的张量并行。当我们有多个 ICI 轴时,我们的 $T_\text{comms}$ 会减少 $M_Y$ 倍,因此我们得到 $Y < M_Y \cdot F / 2550$。
要点:当 $Y > M_Y \cdot F / 2550$ 时,张量并行性将成为通信受限。对于大多数模型来说,这是在 8 到 16 路张量并行度之间。
请注意,这并不取决于计算精度。例如,对于 int8,在 TPU v5p 上,$C_\text{int8}/W_\text{ici}$ 是 $5100$ 而不是 $2550$,但通信量也减半,因此两个因素相互抵消。
让我们考虑一些例子:
对于 $D=8192$、$F\approx 30{,}000$ 的 LLaMA 3 70B,在 TPU v5p 上可以轻松进行 8 路张量并行,但 16 路张量并行会受到通信限制。8 路模型分片要求 $F$ 至少约为 20K。
对于 Gemma 7B,$F\approx 50\text{k}$,大约到 19 路张量并行时才会受到通信限制。这意味着可以采用 16 路,并且仍然获得较好的性能。
结合 FSDP 和张量并行性
语法:
$$\text{In}[B_X, D_Y] \cdot_D W_\text{in}[D_X, F_Y] \cdot_F W_\text{out}[F_Y, D_X] \rightarrow \text{Out}[B_X, D_Y]$$
FSDP 和张量并行性的好处是它们可以结合起来。通过沿两个轴分片 Win 和 **Wout**,我们既节省了内存又节省了计算量。因为我们沿着 X 对 B 进行分片,所以我们减少了模型并行 AllGathers 的大小,并且因为我们沿着 Y 对 F 进行了分片,所以我们减少了 FSDP 的通信开销。这意味着两者的结合可以使我们获得比上面看到的更低的有效批量大小。
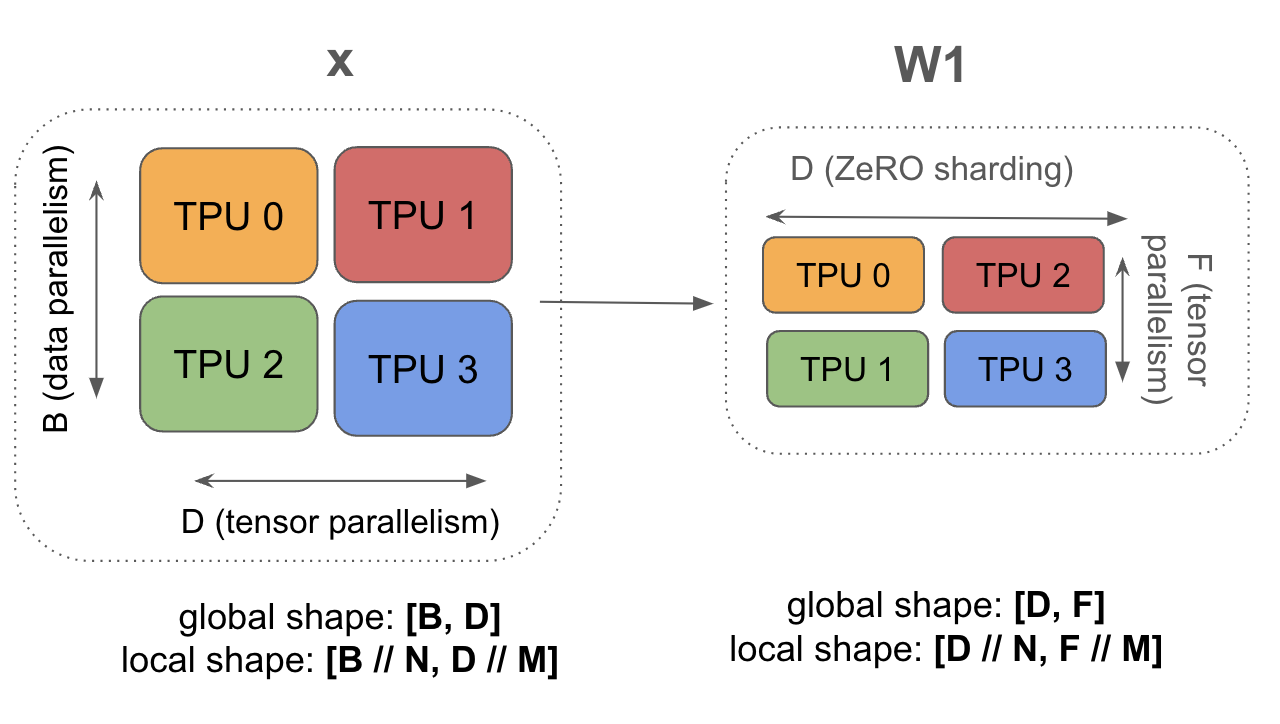
图:结合FSDP和张量并行性的图。与其他情况不同,模型参数没有重复。
这里是混合 FSDP + 张量并行的完整算法。虽然我们有很多沟通,但我们所有的 AllGathers 和 ReduceScatters 都较小,因为我们对激活进行了批量分片,并且张量对权重进行了更多分片!
前向传播:需要计算Loss[B]
- In[BX, D] = AllGatherY(In[BX, DY]) (on critical path)
- Win[D, FY] = AllGatherX(Win[DX, FY]) (can be done ahead of time)
- Tmp[BX, FY] = In[BX, D] *D Win[D, FY]
- Wout[FY, D] = AllGatherX(Wout[FY, DX]) (can be done ahead of time)
- Out[BX, D] {UY} = Tmp[BX, FY] *F Wout[FY, D]
- Out[BX, DY] = ReduceScatterY(Out[BX, D] {UY}) (on critical path)
- Loss[BX] = …
反向传播:需要计算dWout[FY, DX], dWin[DX,FY]
- dOut[BX, DY] = …
- dOut[BX, D] = AllGatherY(dOut[BX, DY]) (on critical path)
- dWout[FY, D] {UX} = Tmp[BX, FY] *B dOut[BX, D]
- dWout[FY, DX] = ReduceScatterX(dWout[FY, D] {UX})
- Wout[FY, D] = AllGatherX(Wout[FY, DX]) (can be done ahead of time)
- dTmp[BX, FY] = dOut[BX, D] *D Wout[FY, D] (can throw away dOut[B, D] here)
- In[BX, D] = AllGatherY(In[BX, DY]) (not on critical path + this can be shared with (2) from the previous layer)
- dWin[D, FY] {UX} = In[BX, D] *B dTmp[BX, FY]
- dWin[DX, FY] = ReduceScatterX(dWin[D, FY] {UX})
- Win[D, FY] = AllGatherX(Win[DX, FY]) (can be done ahead of time)
- dIn[BX, D] {UY} = dTmp[BX, FY] *F Win[D, FY] (needed for previous layers)
- dIn[BX, DY] = ReduceScatterY(dIn[BX, D] {UY}) (on critical path)
FSDP 和 TP 的正确组合是什么? 一个简单但关键的格言是 FSDP 移动权重,张量并行性移动激活。这意味着随着我们的批量大小缩小(特别是当我们进行更多的数据并行处理时),张量并行性变得更便宜,因为我们每个分片的激活更小。
- 张量并行执行 $\mathbf{AllGather}_Y([B_X, D_Y])$,它随着 $X$ 的增长而缩小。
- FSDP 执行 $\mathbf{AllGather}_X([D_X, F_Y])$,它随着 $Y$ 的增长而缩小。
因此,通过将两者结合起来,我们可以进一步降低每个副本的最小批量大小。我们可以用与上述相同的方式计算最佳的 FSDP 和 TP 数量:
令 $X$ 为专用于 FSDP 的芯片数量,$Y$ 为专用于张量并行性的芯片数量。令 $N$ 为切片中的芯片总数,其中 $N=XY$。令 $M_X$ 和 $M_Y$ 分别为 FSDP 和 TP 跨越的网格轴数量(它们的总和应大致为 3)。这里只对前向传播建模,因为它对应每 FLOP 最大的通信量。将上面算法中的通信相加,可以得到
$$T_\text{FSDP comms}(B, X, Y) = \frac{2\cdot 2\cdot D \cdot F}{Y \cdot W_\text{ici} \cdot M_X}$$
$$T_\text{TP comms}(B, X, Y) = \frac{2 \cdot 2 \cdot B \cdot D}{X \cdot W_\text{ici} \cdot M_Y}$$
同样,我们的总 FLOP 时间是
$$T_\text{math} = \frac{2\cdot 2 \cdot B \cdot D \cdot F}{N \cdot C}.$$
为了简化分析,我们做两个假设:首先,我们允许$X$和$Y$取非整数值(只要它们是正数并且满足$XY=N$);其次,我们假设 $X$ 和 $Y$ 轴上的通信可以彼此完全重叠。在第二个假设下,总通信时间为
$$T_\text{comms} = \max\left(T_\text{FSDP comms}, T_\text{TP comms}\right)$$
在询问在什么条件下我们将受到计算受限之前,我们先找到 $X$ 和 $Y$ 的最佳值,以最大限度地减少总通信量。由于我们的 FLOP 独立于 $X$ 和 $Y$,因此最佳设置就是那些简单地最小化通信的设置。为此,我们将上面的 $T_\text{comms}$ 写为 $X$ 和 $N$(它是固定的,因为它是我们系统中的芯片数量),而不是 $X$ 和 $Y$:
$$T_\text{comms} (X) = \frac{4D}{W_\text{ici}} \max\left(\frac{F \cdot X}{N \cdot M_X}, \frac{B}{X \cdot M_Y}\right)$$
由于 $T_\text{FSDP comms}$ 在 $X$ 中单调递增,而 $T_\text{TP comms}$ 在 $X$ 中单调递减,因此当 $T_\text{FSDP comms} = T_\text{TP comms}$ 时必须最小化最大值,这发生在
$$\begin{align*}
\frac{FX_{opt}}{M_X} = \frac{BN}{X_{opt} M_Y} \rightarrow \
X_{opt} = \sqrt{\frac{B}{F} \frac{M_X}{M_Y} N}
\end{align*}$$
这个超级有用!这告诉我们,对于给定的 $B$、$F$ 和 $N$,最佳的 FSDP 量是多少。让我们感受一下规模。 代入实际值,即 $N = 64$(对应于 4x4x4 芯片阵列)、$B=48,000$、$F=32768$,大致得出 $X\approx 13.9$。因此,我们选择 $X$ 为 16,$Y$ 为 4,接近我们计算出的最佳值。
要点:一般来说,在训练期间,FSDP 的最佳规模是 $X_{opt}=\sqrt{\frac{B}{F}\frac{M_X}{M_Y}N}$。
现在让我们回到我们一直在问的所有并行策略的问题: 在什么条件下我们将受到计算受限? 由于我们可以重叠 FLOP 和通信,因此当我们遇到计算受限时
$$\max\left(T_\text{FSDP comms}, T_\text{TP comms}\right) < T_\text{math}$$
通过让 ICI 算术强度 $\alpha \equiv C / W_\text{ici}$,我们可以简化:
$$\max\left(\frac{F}{Y \cdot M_X}, \frac{B}{X \cdot M_Y}\right) < \frac{B \cdot F}{N \cdot \alpha}$$
由于我们计算了 $X_{opt}$ 以使 LHS 最大值相等,因此我们可以将其插入任一侧(注意 $Y_{opt} = N/X_{opt}$),即
$$\frac{F}{N \cdot W_\text{ici} \cdot M_X} \sqrt{\frac{B}{F} \frac{M_X}{M_Y} N} < \frac{B \cdot F}{N \cdot C}$$
进一步简化,我们发现
$$ \sqrt{\frac{B\cdot F}{M_X \cdot M_Y \cdot N}} < \frac{B \cdot F}{N \cdot \alpha},$$
其中左侧与通信时间成正比,右侧与计算时间成正比。请注意,虽然计算时间随批量大小线性缩放(无论并行性如何),但通信时间随批量大小的平方根缩放。因此,计算与通信时间的比率也按批量大小的平方根缩放:
$$ \frac{T_\text{math}}{T_\text{comms}} = \frac{\sqrt{BF}\sqrt{M_X M_Y}}{\alpha \sqrt{N}}. $$
为了确保这个比率大于 1,这样我们就受到计算受限,我们需要
$$ \frac{B}{N} > \frac{\alpha^2}{M_X M_Y F}$$
要获得近似数字,请再次插入 $F=32,768$、$\alpha=2550$ 和 $M_X M_Y=2$(因为它必须适用于 3D 网格)。这大致给出了 $B/N > 99$。与纯数据并行(或 FSDP)情况相比,这大约为我们赢得了八倍,在纯数据并行(或 FSDP)情况下,假设使用 3D 网格,我们计算出 $B/N$ 必须超过大约 $850$ 才能达到计算极限。
要点:将张量并行与 FSDP 相结合,可以把 $B/N$ 降至 $2550^2/(2F)$。这使我们能够处理每个芯片少至 100 个 token 的批次,大约只有单独使用 FSDP 时的八分之一。
下面我们绘制了混合 FSDP + TP 的 FLOP 与通信时间的比率,并将其与代表性 4x4x4 芯片阵列上的仅张量并行 (TP) 和仅数据并行 (FSDP) 进行比较。虽然纯 FSDP 并行性在非常大的批量大小中占主导地位,但在批量大小与芯片数量之比约为 100 到 850 之间的情况下,需要混合 FSDP + TP 策略才能受计算受限。
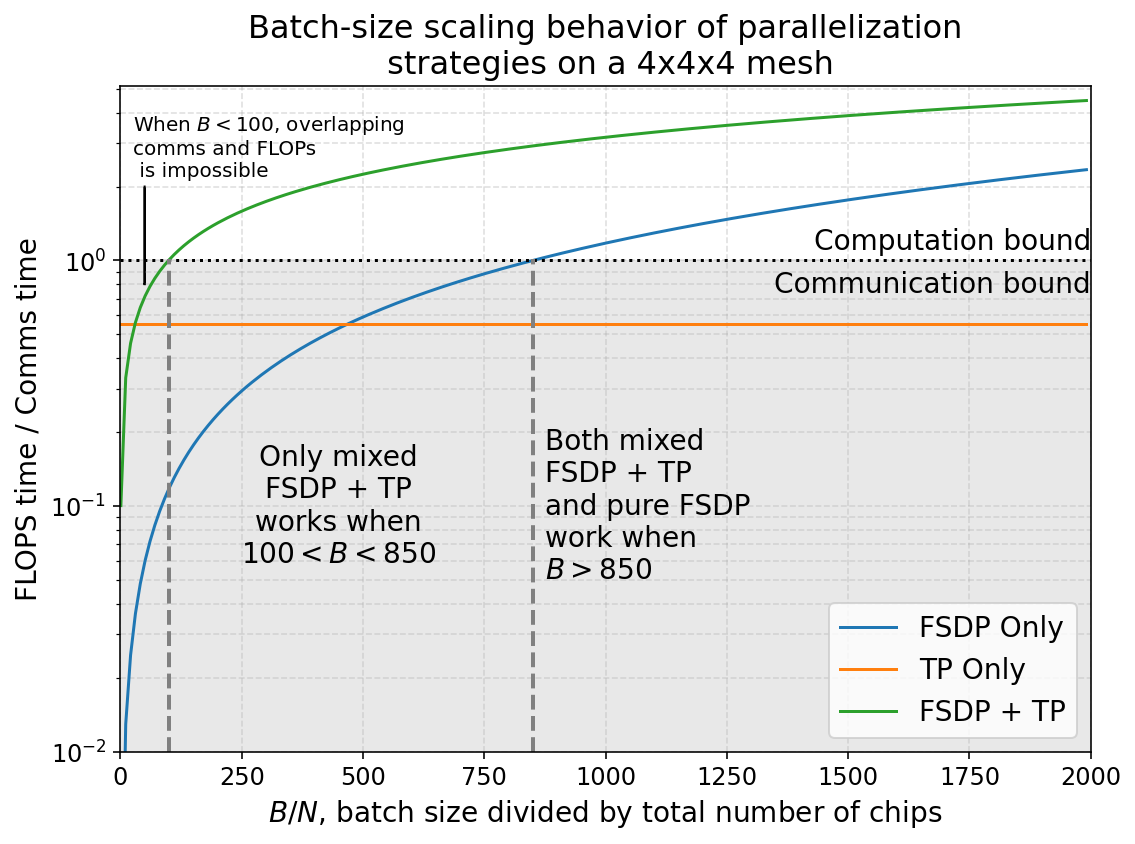
图: 在 F=30k 的 TPUv5p 4x4x4 切片上实现最佳混合 FSDP/TP 的 FLOP 与通信时间的比率。正如预期的那样,张量并行度与批量大小具有固定的比率; $\sqrt{B}$ 为理想混合 FSDP + TP 秤,$B$ 为 FSDP 秤。然而,在中等批量大小的情况下,只有 FSDP + TP 的比率大于 1。
这是 TPU v5p 16x16x16 的另一个示例,显示了不同分片方案的 FLOP 和通信时间作为批量大小的函数。
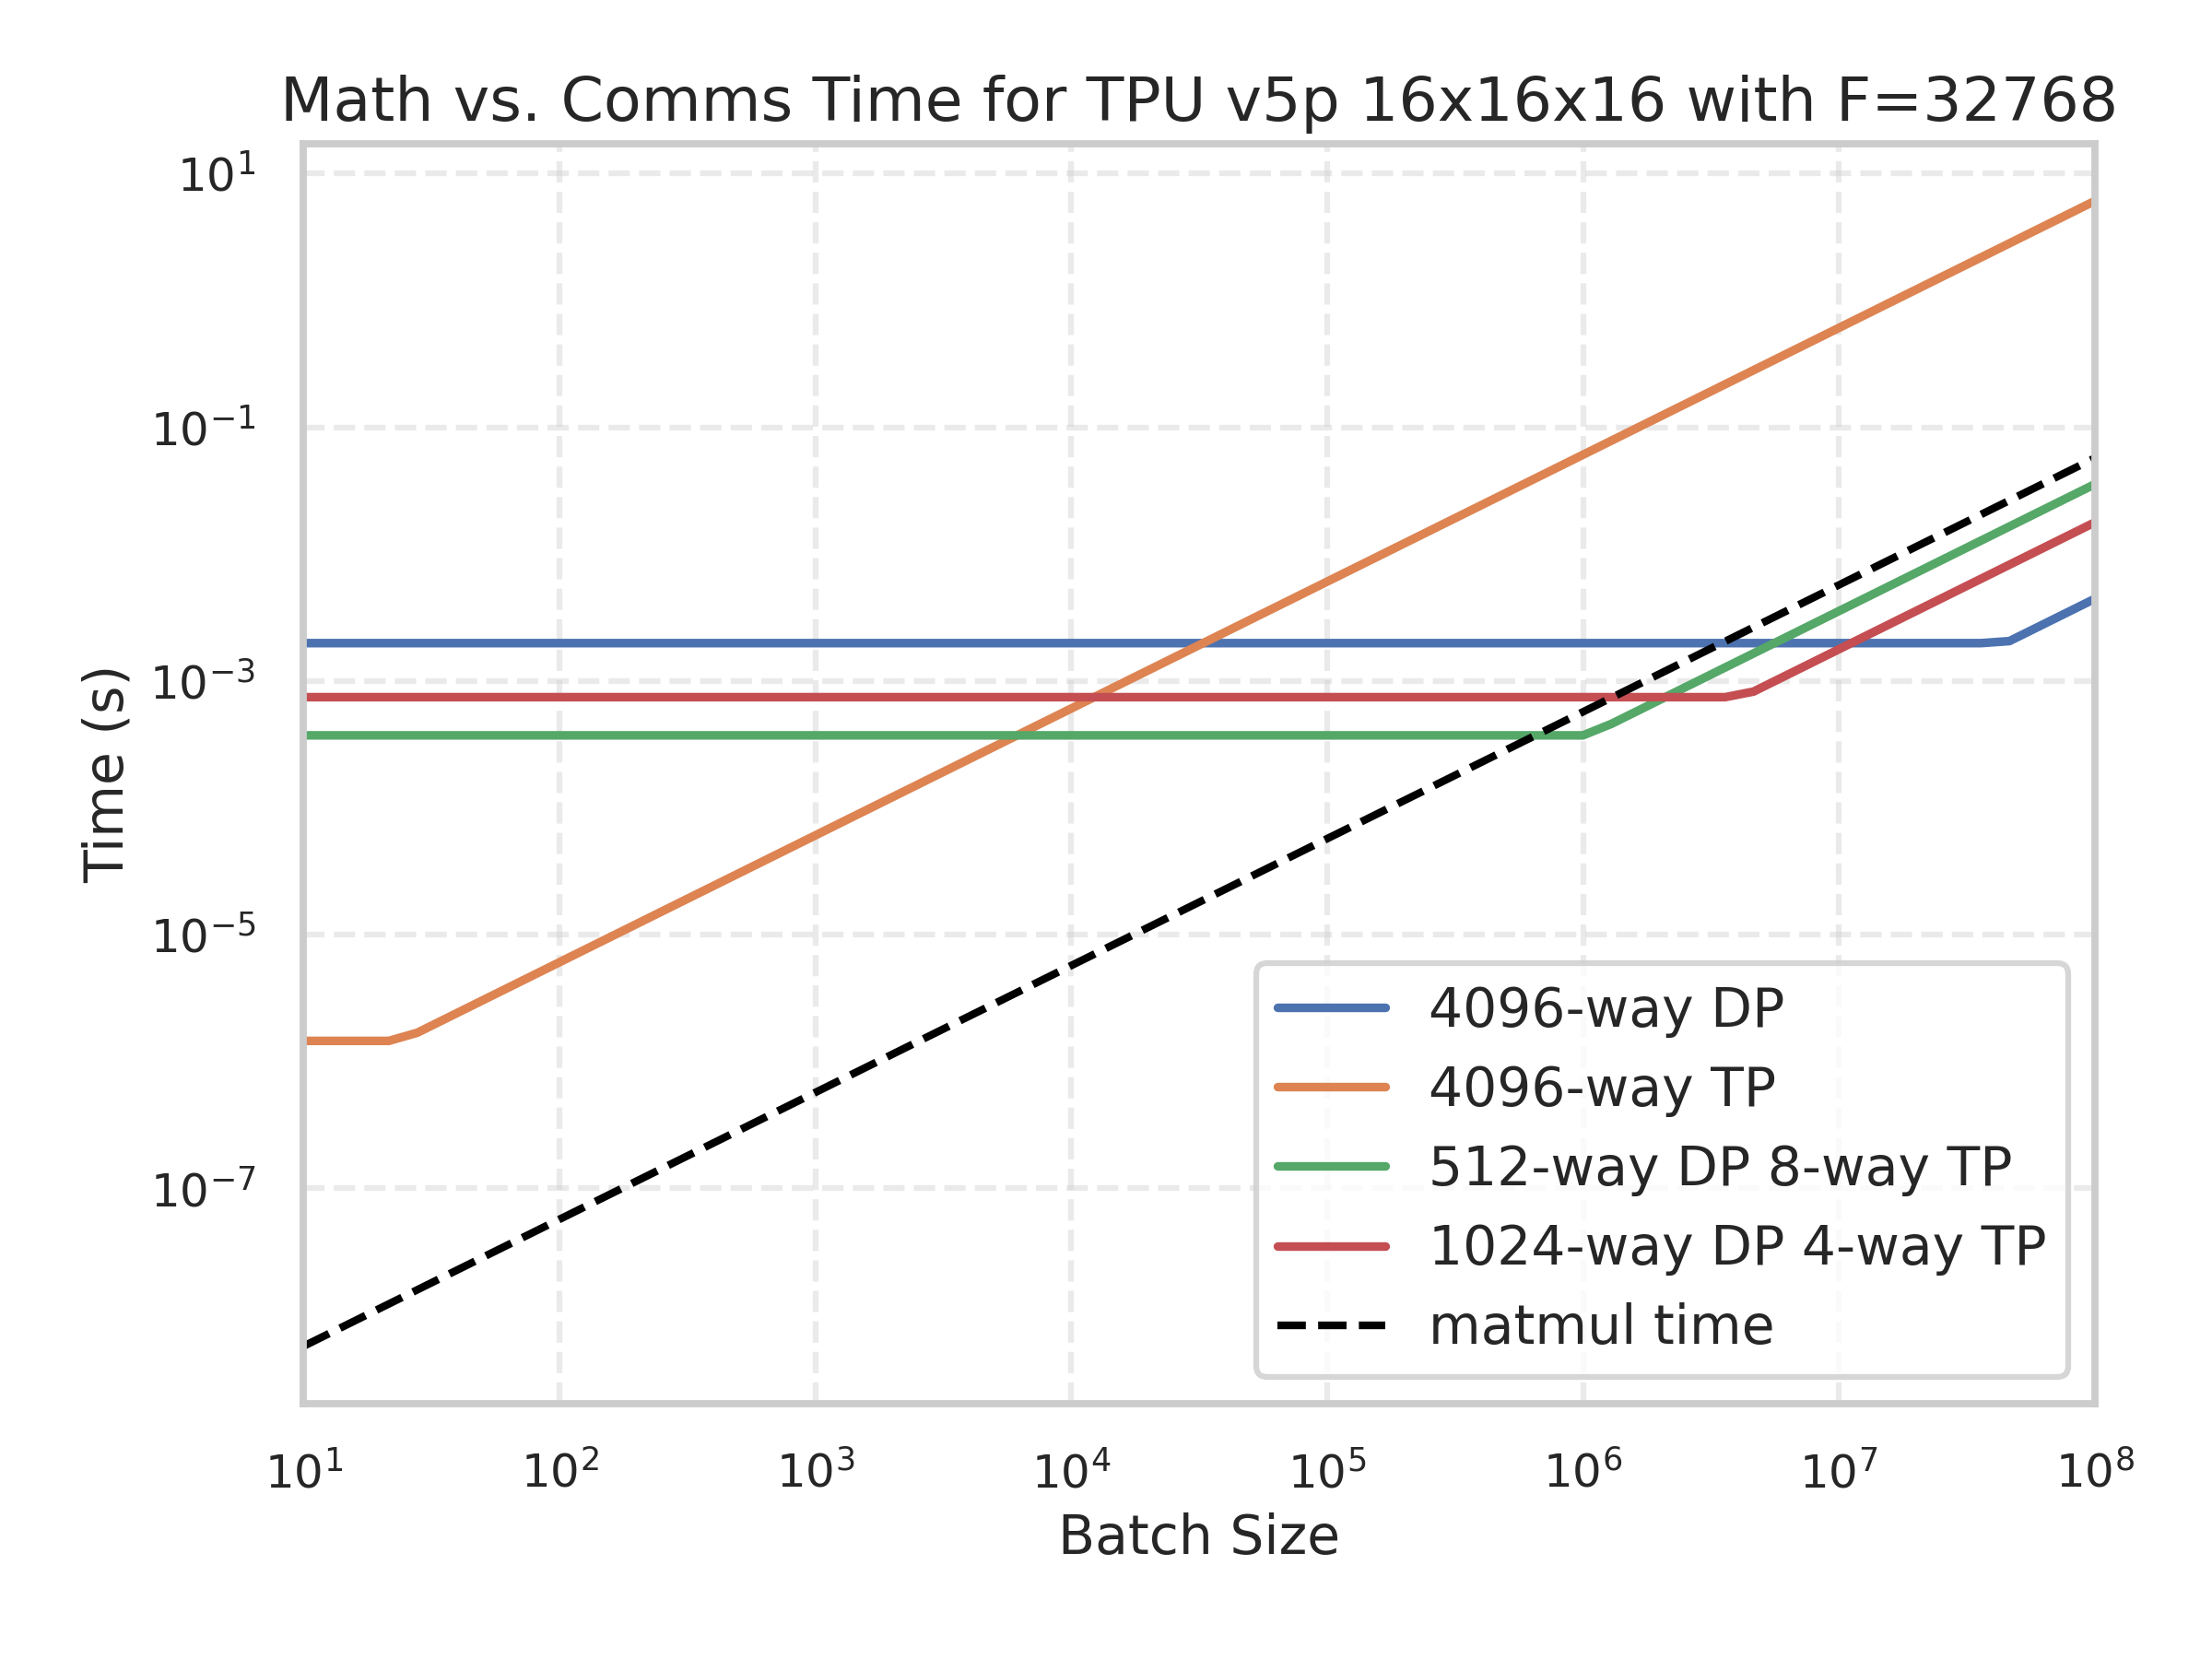
图: 不同并行方案的通信所花费的时间。黑色虚线是矩阵乘法 FLOP 所花费的时间,因此这条线上方的任何曲线都是受通信受限的。我们注意到,所有策略在批量大小 6e5 以下时都会受到通信受限,这与我们预期的 4096 * 2550^2 / (2 * 8192 * 4) = 4e5 一致。
黑色曲线是模型 FLOP 所花费的时间,这意味着低于所有通信成本的任何批量大小都严格受到通信受限。你会注意到黑色曲线与绿色曲线相交于大约 4e5 处,正如预测的那样。
这是一个交互式动画,显示了不同批量大小的总计算时间和通信时间:
图:在 TPU v5p 16×16×16 上,前向 MLP 的计算时间和通信时间随批量大小的变化($D=8192$,$F=32768$)。使用的是上面推导的 $T_\text{FSDP comms}$、$T_\text{TP comms}$ 和 $T_\text{math}$。拖动滑块可改变 FSDP 与 TP 的分配;阴影区域内的批量均受通信受限。
你会注意到这通常与上述内容一致:最佳分割(FSDP = 512 和 TP = 8)在大约 4e5 的批处理大小之上变得受计算受限,而具有更多张量并行性的每个分割在所有批处理大小上都保持通信受限。张量并行度较低的分割需要更大的批次。
流水线
你可能会注意到,我们在前面的部分中根本避免讨论管道。流水线是 GPU 并行性的主要策略,但在 TPU 上不太重要。简而言之,流水线训练涉及将模型的各层拆分到多个设备上,并在前向和反向传播过程中在管道阶段之间传递激活。该算法类似于:
- 使用在层维度上分片的权重初始化 TPU 0 上的数据($W_\text{in}[L_Z, D_X, F_Y]$ 用于使用 FSDP 和张量并行性进行流水线操作)。
- 在 TPU 0 上执行第一层,然后将生成的激活复制到 TPU 1,并重复直到到达最后一个 TPU。
- 计算损失函数及其导数 $\partial L / \partial x_L$。
- 对于最后一个管道阶段,计算导数 $\partial L / \partial W_L$ 和 $\partial L / \partial x_{L-1}$,然后将 $\partial L / \partial x_{L-1}$ 复制到前一个管道阶段并重复,直到达到 TPU 0。
这里是一些(工作的)Python伪代码
此伪代码应在 Cloud TPU VM 上运行。虽然它不是很高效或不现实,但它可以让你了解数据是如何跨设备传播的。
batch_size = 32
d_model = 128
d_ff = 4 * d_model

num_layers = len(jax.devices())

key = jax.random.PRNGKey(0)

# Pretend each layer is just a single matmul.
x = jax.random.normal(key, (batch_size, d_model))
weights = jax.random.normal(key, (num_layers, d_model, d_model))

def layer_fn(x, weight):
  return x @ weight

# Assume we have num_layers == num_pipeline_stages
intermediates = [x]
for i in range(num_layers):
  x = layer_fn(x, weights[i])
  intermediates.append(x)

  if i != num_layers - 1:
    x = jax.device_put(x, jax.devices()[i+1])

def loss_fn(batch):
  return jnp.mean(batch ** 2)  # make up some fake loss function

loss, dx = jax.value_and_grad(loss_fn)(x)

for i in range(num_layers - 1, -1, -1):
  _, f_vjp = jax.vjp(layer_fn, intermediates[i], weights[i])
  dx, dw = f_vjp(dx)  # compute the jvp dx @ J(L)(x[i], W[i])
  weights[i] = weights[i] - 0.01 * dw  # update our weights

  if i != 0:
    dx = jax.device_put(dx, jax.devices()[i-1])
为什么这是一个好主意? 流水线之所以伟大,有很多原因:它在流水线阶段之间的通信成本较低,这意味着即使使用低带宽互连,你也可以训练非常大的模型。这对于 GPU 通常非常有用,因为它们不像 TPU 那样通过 ICI 密集连接。
为什么这很困难/烦人? 你可能已经在上面的伪代码中注意到 TPU 0 几乎总是空闲的!它只在管道的第一步和最后一步上工作。空闲期称为管道泡沫,处理起来非常烦人。通常,我们首先尝试通过微批处理来缓解这一问题,微批处理通过管道发送多个小批次,从而使 TPU 0 至少在总步骤时间的较大部分中得到利用。
第二种方法是仔细重叠前向 matmul $W_i @ x_i$、后向 $dx$ matmul $W_i @ \partial L / \partial x_{i+1}$ 和 $dW$ matmul $\partial L / \partial x_{i+1} @ x_i$。由于其中每一个都需要一些 FLOP,我们可以将它们重叠以隐藏气泡。下图来自 DeepSeek-V3 论文,展示了其“无气泡”流水线调度:
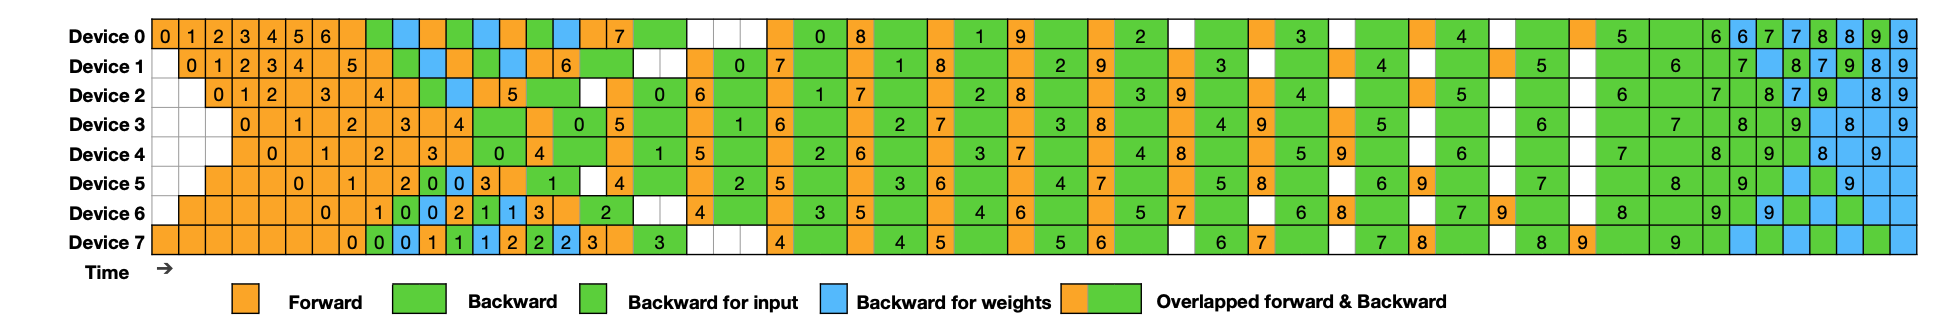
图:DeepSeek v3 的流水线调度,来自其近期论文。橙色表示前向矩阵乘法,绿色表示 dL/dx 矩阵乘法,蓝色表示 dL/dW 矩阵乘法。优先执行反向传播中的 dL/dx 乘法,就可以避免计算能力闲置。
TPU 的紧密互连 Pod 较大,对流水线的依赖相对较小,因此这里不再深入展开。不过,理解流水线的主要瓶颈仍然是很好的练习。
跨 Pod 扩展
这里讨论的最大 TPU 切片是 TPU v5p SuperPod,包含 8960 块芯片、2240 台主机。超过这个规模,就需要跨越数据中心网络(DCN)的边界。每台 TPU 主机配有一张或多张网卡(NIC),通过以太网连接其他 TPU v5p Pod。第 2 章:理解 TPU提到,每台主机约有 200Gbps(25GB/s)的全双工 DCN 带宽,折合每块 TPU 约 6.25GB/s 的全双工出口带宽。
跨越单个 Pod 时,通常在 ICI 域内使用某种模型并行或 FSDP,而在多个 Pod 之间采用纯数据并行。设目标 TPU 总数为 $N$,每个 ICI 互连切片内的 TPU 数为 $M$。要在 DCN 上执行 AllReduce,可以让这些 Pod 组成一个环做归约,反向传播时便得到:
$$T_\text{math} = \frac{2 \cdot 2 \cdot 2 \cdot BDF}{N \cdot C}$$
$$T_\text{comms} = \frac{2 \cdot 2 \cdot 2 \cdot DF}{M \cdot W_\text{dcn}}$$
通信带宽随 $M$ 增长。这一点与 ICI 不同:ICI 域变大时,参与的网卡也会增加,总 DCN 带宽随之增大。化简后可以发现,下列条件成立时,有 $T_\text{math} > T_\text{comms}$:
$$\frac{B}{\text{slice}} > \frac{C}{W_\text{dcn}}$$
对于 TPU v5p,$\frac{C}{W_\text{dcn}}$ 约为 4.59e14 / 6.25e9 = 73,440。这告诉我们,为了有效地扩展 DCN,每个 ICI 域需要有一个最小批量大小才能传出每个节点。
这有多大问题? 举一个具体的例子,假设我们想要在 TPU v5p 上使用 2M token的 BS 训练 LLaMA-3 70B。 LLaMA-3 70B 的编号为 $F\approx 30,000$。从以上几节,我们知道以下几点:
- 我们可以做到张量并行度达到 $Y = M_Y \cdot F / 2550 \approx 11 \cdot M_Y$。
- 只要$B / N > 2550 / M_X$我们就可以做FSDP。这意味着,如果我们想要使用 BS=2M 和 3 轴数据并行性进行训练,我们最多只能使用 $\approx 2400$ 芯片,大约是 TPU v5p pod 的四分之一。
- 当我们结合 FSDP + 张量并行性时,当我们拥有 $B / N < 2550^2 / (2 \cdot 30000) = 108$ 时,就会成为通信受限,因此这让我们可以扩展到大约 18k 芯片!然而,TPU v5p pod 的最大尺寸为 8k 芯片,因此超出此范围我们必须使用 DCN。
总而言之,我们有一个很好的方法来进行 BS=1M 的训练,大致使用 X (FSDP) = 1024 和 Y (TP) = 8,但是当 BS=2M 时,我们需要使用 DCN。如上所述,我们的 DCN 算术强度为 $\text{73,440}$,因此我们只需确保每个 ICI 域的批量大小大于此值。这对我们来说是微不足道的,因为使用 2 个 pod,每个 pod 的 BS 为 1M,每个 TPU 的批量大小为 111,这非常好(可能有点接近,但理论上是合理的)。
要点: 只要我们的每个 Pod 批量大小至少为 73k 个token,使用纯数据并行在多个 TPU Pod 之间进行扩展就相当简单。
TPU 法学硕士培训要点
增加并行性或减少批量大小都会使我们更加受通信受限,因为它们减少了每个芯片执行的计算量。
在合理的上下文长度(~32k)内,我们可以将 Transformer 建模为 MLP 块的堆栈,并通过它们如何分割每层的两个/三个主矩阵相乘来定义每个并行方案。
在训练过程中,我们考虑了 4 种主要的并行方案,每种方案都有自己的带宽和计算要求(数据并行、FSDP、张量并行和混合 FSDP + 张量并行)。
| 策略 | 描述 |
|---|---|
| 数据并行性 | 激活是批量分片的,其他一切都是完全复制的,我们在反向传播期间全部减少梯度。 |
| FSDP | 激活、权重和优化器被批量分片,权重在使用前收集,梯度被减少分散。 |
| 张量并行(又名模型并行) | 激活沿着 $d_\text{model}$ 分片,权重沿着 $d_\text{ff}$ 分片,激活在 Win 之前收集,结果在 Wout 之后执行 ReduceScatter。 |
| 混合 FSDP + 张量并行 | 在上述两者中,FSDP 收集模型分片权重。 |
以下是每种方法的“公式”:
$$\small
\begin{array}{cc}
\text{Strategy} & \text{Formula}\
\hline
\text{DP} & \text{In}[B_X, D] \cdot_D W_\text{in}[D, F] \cdot_F W_\text{out}[F, D] \rightarrow \text{Out}[B_X, D] \
\text{FSDP} & \text{In}[B_X, D] \cdot_D W_\text{in}[D_X, F] \cdot_F W_\text{out}[F, D_X] \rightarrow \text{Out}[B_X, D] \
\text{TP} & \text{In}[B, D_Y] \cdot_D W_\text{in}[D, F_Y] \cdot_F W_\text{out}[F_Y, D] \rightarrow \text{Out}[B, D_Y] \
\text{TP + FSDP} & \text{In}[B_X, D_Y] \cdot_D W_\text{in}[D_X, F_Y] \cdot_F W_\text{out}[F_Y, D_X] \rightarrow \text{Out}[B_X, D_Y] \
\hline
\end{array}$$
- 每种策略都可能根据单设备的计算与通信比例进入网络瓶颈。下表给出每层的计算与通信量,其中 $X$ 表示 FSDP 规模,$Y$ 表示张量并行规模。
$$
\small
\begin{array}{ccc}
\text{Strategy} & \text{Compute per layer} & \text{Comms per layer} \
& \text{(ignoring gating einsum)} & \text{(bytes, forward + backward pass)}\
\hline
\text{DP} & 4BDF/X + 8BDF/X & 0 + 8DF \
\text{FSDP} & 4BDF/X + 8BDF/X & 4DF + 8DF \
\text{TP} & 4BDF/Y + 8BDF/Y & 4BD + 4BD \
\text{FSDP + TP} & 4BDF/(XY) + 8BDF/(XY) & (4BD/X + 4DF/Y) + (8BD/X + 8DF/Y) \
\hline
\end{array}$$
纯数据并行很少有用,因为模型及其优化器状态使用字节 = 10x 参数计数。这意味着我们很少能在内存中容纳超过数十亿个参数。
当 $\text{batch size per shard}<C/W$ 时,数据并行和 FSDP 会受到通信限制。对于 ICI,该阈值为 2,550;对于 DCN,该阈值约为 71,000。使用更多并行轴可以提高可用聚合带宽。
当 $\lvert Y\rvert>F/2550$ 时,张量并行会受到通信限制。对于大多数模型来说,这大约对应 8~16 路并行。这与批量大小无关。
混合 FSDP 与张量并行允许我们将单芯片批量大小降至 $2550^2/(2F)\approx 100$。
在成为 DCN 绑定之前,跨 Pod 的数据并行性要求每个 Pod 的最小批量大小约为 71,000。
基本上,如果你的批量较大或模型较小,事情就很简单。你可以跨 DCN 进行数据并行或 FSDP + 数据并行。中间部分是事情变得有趣的地方。
工作中的一些问题
让我们使用 LLaMA-2 13B 作为本节的基本模型。以下是型号详细信息:
| 超参数 | 价值 |
|---|---|
| L | 40 |
| D | 5,120 |
| F | 13824 |
| N | 40 |
| K | 40 |
| H | 128 |
| V | 32,000 |
LLaMA-2 具有独立的嵌入和输出矩阵以及门控 MLP 模块。
问题 1: LLaMA-2 13B 有多少个参数(我知道这很傻,但算一下)?请注意,与第 4 章:Transformer 数学中一样,LLaMA-3 有 3 个大 FFW 矩阵,两个上投影和一个下投影。我们忽略了本节中的两个“门控”einsum 矩阵,但它们的行为与本节中的 Win 相同。
答案:
- FFW 参数:$3LDF$ =
8.5e9 - 注意力参数:$4DNHL$ =
4.2e9 - 词表参数:$2VD$ =
0.33e9 - 总计:
8.5e9 + 4.2e9 + 0.33e9 = 13.0e9,正如预期的那样!
问题 2: 假设我们正在使用 BS=16M token并使用 Adam 进行训练。暂时忽略并行性,模型的参数、优化器状态和激活使用了多少总内存? 假设我们将参数存储在 bf16 中,将优化器状态存储在 fp32 中,并且每层检查点激活三次(在三个大 FFW matmuls 之后)。
答案:
用于参数 (bf16) 和两个优化器状态(fp32,第一和第二矩累加器)的总内存为 (2 + 4 + 4) * 13e9 ~ 130GB。前两个 matmul 之后的激活形状为 $BF$,最后一个 matmul 之后的激活形状为 $BD$(根据上面的 Transformer 图),因此 bf16 的总内存为 $2 \cdot L \cdot (BD + 2 * BF) = 2LB \cdot (D + 2F)$ 或 2 * 40 * 16e6 * 5,120 * (1 + 2 * 2.7) ~ 4.2e13 = 42TB,因为 B=16e6。所有其他激活或多或少都可以忽略不计。
问题 3: 假设我们想要在 TPUv5p 16x16x16 切片上训练 32k 序列长度和 3M token的总批量大小。假设我们想要使用 bfloat16 权重和 float32 优化器,如上所述。
- 我们可以使用纯数据并行吗?为什么或为什么不呢?
- 我们可以使用纯粹的 FSDP 而不受通讯限制吗?为什么或为什么不呢?使用纯 FSDP,每个设备将使用多少内存(假设我们仅在 3 个大 FFW 矩阵之后进行梯度检查点)。
- 我们可以使用混合 FSDP + 张量并行吗?为什么或为什么不呢?如果是这样,$X$ 和 $Y$ 应该是什么?每个设备将存储多少内存?仅使用 Roofline FLOP 估计并忽略注意力,在 40% MFU 下每个训练步骤需要多长时间?
答案:
首先,让我们写下一些数字。序列长度为 32k,批量大小为 3M,序列批量大小为 96。在 TPU v5p 16x16x16 切片上,我们有 HBM 393TB。
我们不能使用纯粹的数据并行性,因为它会在每个芯片上复制参数和优化器状态,这些参数和优化器状态已经约为 130GB(从第二季度开始),这比我们每个芯片 (96GB) 的 HBM 还要多。
让我们从纯粹的内存开始。在第二季度将 BS=16M 替换为 3M,我们得到
~7.86e12检查点激活总数,并且在 1.3e11 优化器状态下,这使我们几乎完全达到 8e12 = 8TB。 TPUv5p 切片总共具有393TB的 HBM,因此我们安全地处于 HBM 限制之下。接下来让我们看看我们是否会受到通信或计算的限制。凭借 4096 个芯片和 3 个并行轴,我们可以实现850 * 4096 = 3.48Mtoken的最小批量大小。这略高于我们的 3M 批量大小。所以我们实际上是受通讯束缚的,这很可悲。因此,一般答案是不,我们无法在不受通信受限的情况下单独进行 FSDP。现在我们知道我们最关心的是通讯绑定,所以让我们插入一些数字。首先,我们从上面知道,混合 FSDP + 张量并行性的每芯片批量大小需要高于 $2550^2 / 2F = 235$。这意味着理论上我们可以做到这一点!让我们算一下每一个有多少。
我们有规则 $X_{opt} = \sqrt{(B / F) \cdot (M_X / M_Y) \cdot N}$,所以这里有 sqrt(3e6 * 2 * 4096 / 13824) = 1333,这意味着我们将执行大约 1024 路 DP 和 4 路 TP。每个 TPU 内存将如 (2) 中所示,步骤时间将为 6 * 3e6 * 13e9 / (4096 * 4.6e14 * 0.4) = 300ms。
第 5 章到此结束!原著第 6 章将把这些方法应用到真实的 LLaMA 模型。
附录
附录 A:导出反向传播通信
上面,我们将 Transformer 层前向传播简化为 Out[B, D] = In[B, D] *D Win[D, F] *F Wout[F,D]。我们如何获得反向传播所需的通信?
这很自然地遵循上一节中单个 matmul Y = X * A 的规则:
$$\frac{dL}{dA} = \frac{dL}{dY}\frac{dY}{dA} = X^T \left(\frac{dL}{dY}\right)$$
$$\frac{dL}{dX} = \frac{dL}{dY}\frac{dY}{dX} = \left(\frac{dL}{dY}\right) A^T$$
使用它,我们得到以下公式(让 Tmp[B, F] 代表 In[B, D] * Win[D, F]):
- dWout[F, D] = Tmp[B, F] *B dOut[B, D]
- dTmp[B, F] = dOut[B, D] *D Wout[F, D]
- dWin[D, F] = In[B, D] *B dTmp[B, F]
- dIn[B, D] = dTmp[B, F] *F Win[D, F]
请注意,这些公式是数学陈述,没有提及分片。反向传播的工作是计算这四个量。因此,为了计算出必要的通信,我们只需对上面四个方程(Tmp、dOut、Wout、Win)中要进行矩阵运算的所有量进行分片,这些量由我们的并行化方案指定,再使用分片 matmul 规则判断需要执行哪些通信。请注意,dOut 的分片方式与 Out 相同。
译文与许可:本章是基于固定版本
173fb0851d7e654872f0327aff2e17607cf24106的机器辅助中文初译,并非逐句人工精校。原文与配图基于 MIT License 发布。Copyright (c) 2022 Maruan Al-Shedivat;Copyright (c) 2025 Google LLC。完整许可见 MIT License。