原著:Jacob Austin 等,Google DeepMind,《How to Scale Your Model》。本章原文。原文版本:
173fb0851d7e,MIT 许可。
本章为完整范围的机器辅助中文初译
原文章节简介(中译):本章简要回顾 Transformer 架构,重点说明如何计算 FLOPs、字节数以及其他关心的数量。
Scaling Book 中文导读 · 上一章:分片矩阵与矩阵乘法 · 原著目录
计数点
让我们从以下形状的向量 $x$、$y$ 和矩阵 $A$、$B$ 开始:
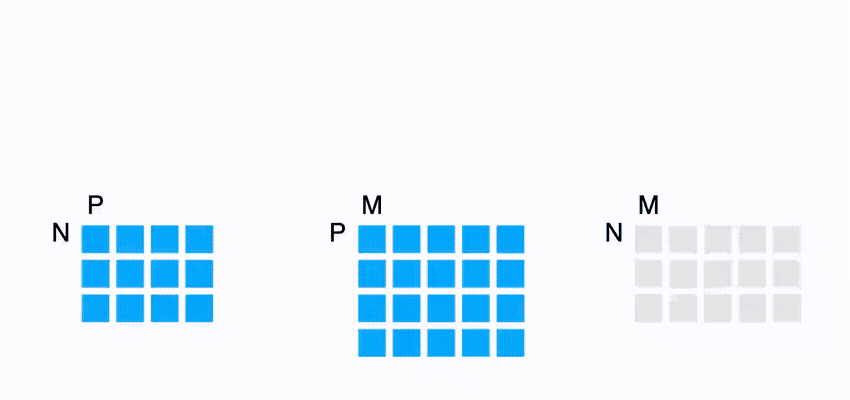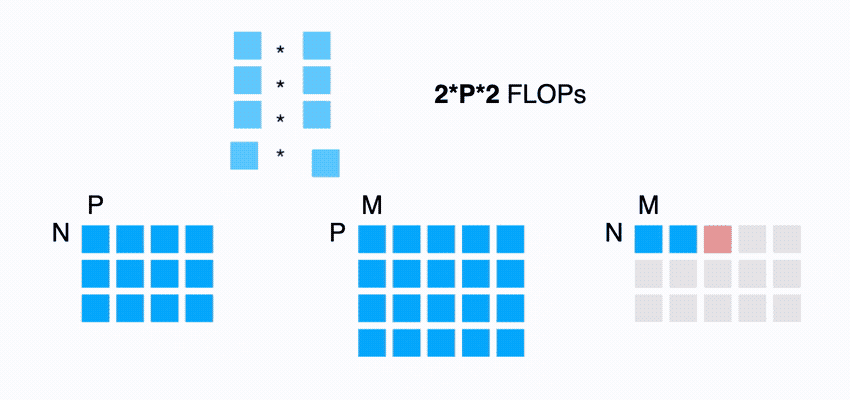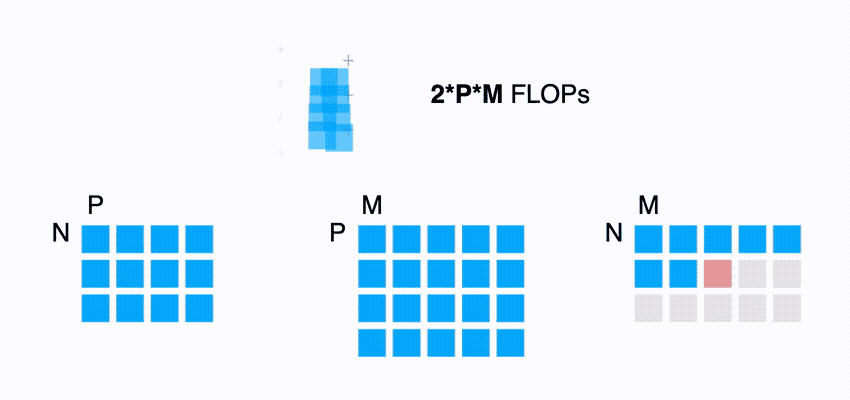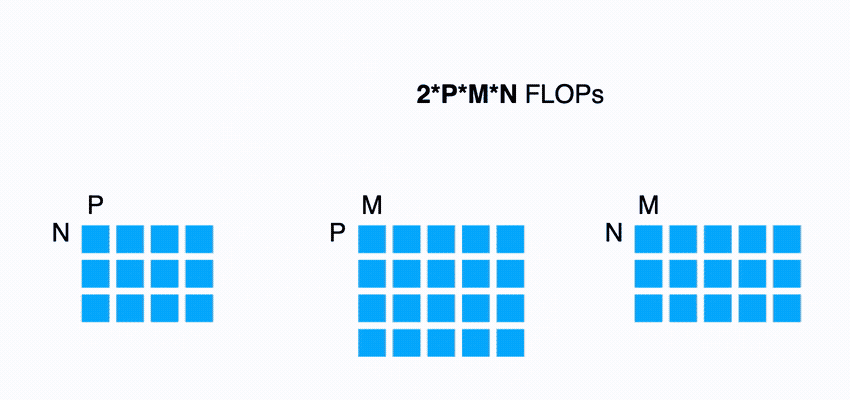
$$ \def \red#1{\textcolor{red}{#1}} \def \green#1{\textcolor{green}{#1}} \def \blue#1{\textcolor{blue}{#1}} \def \purple#1{\textcolor{purple}{#1}} \def \orange#1{\textcolor{orange}{#1}} \def \gray#1{\textcolor{gray}{#1}} \begin{array}{cc} \textrm{array} & \textrm{shape} \\ \hline x & \textrm{[P]} \\ y & \textrm{[P]} \\ A & \textrm{[N P]} \\ B & \textrm{[P M]} \\ \hline \end{array} $$- $x \cdot y$ 的点积需要 $P$ adds 和 _multiplies_,或 $2P$ 浮点运算总计。
- 对于 $2NP$ FLOP,矩阵向量积 $Ax$ 沿着 $A$ 的行进行 $N$ 点积。
- 矩阵-矩阵乘积 $AB$ 对 $B$ 的每个 $M$ 列进行矩阵-向量乘积,总计 $2NPM$ FLOP。
- 一般来说,如果我们有两个高维数组 $C$ 和 $D$,其中一些维度是 CONTRACTING,一些维度是 BATCHING(例如$C[\blue{GH}IJ\red{KL}], D[\blue{GH}MN\red{KL}]$),则此收缩的 FLOP 成本是所有 $C$ 和 $D$ 维度的乘积的两倍,其中批量和收缩维度仅计算一次(例如 $2\blue{GH}IJMN\red{KL}$)。请注意,只有当某个维度同时出现在两个被乘数中时,该维度才是批处理。 (另请注意,如果没有收缩维度,则因子 2 将不适用,并且这只是一个元素乘积。)(原注:Contracting 维度是在操作过程中求和的轴(它们出现在两个输入中,但不在输出中),就像矩阵乘法中的内部维度一样。 Batching 尺寸是出现在两个输入中的共享轴,并且不改变地传送到输出;它们索引独立的子问题,并且不会在 FLOP 计数中相乘。用 Einsum 术语来说:输入和输出上出现的标签都是批处理的;两个输入上都存在但输出中不存在的标签正在收缩。)
$$
\begin{array}{ccc}
\textrm{Operation} & \textrm{FLOPs} & \textrm{Data} \
\hline
x \cdot y & 2P & 2P \
A x & 2NP & NP + P \
AB & 2NPM & NP + PM \
[c_0,…,c_N] \cdot [d_0,…,d_N] &
2 \prod c_i \times \prod_{\substack{d_j \notin \blue{BATCH} \ d_j \notin \red{CONTRACT}}} d_j
&
\prod c_i + \prod d_j \
\hline
\end{array}
$$
请注意,对于矩阵-矩阵乘法,计算按三次方缩放 $O(N^3)$,而数据传输仅按二次方缩放 $O(N^2)$ — 这意味着当我们扩大 matmul 大小时,它会更容易达到计算饱和极限。这是极其不寻常的,并且在很大程度上解释了为什么我们使用以矩阵乘法为主的架构——它们适合扩展!
前向与反向传播的浮点运算量(FLOPs)
在训练过程中,我们并不特别关心给定矩阵乘法的结果;我们真的很关心它的衍生品。事实证明,计算该导数的成本比仅进行 matmul 本身的成本高出约 3 倍。
如果我们想象 B 只是较大网络中的一个矩阵,而 A 是我们的输入激活,其中 C = A B,则损失 L 相对于 B 的导数由链式法则给出:
$$\frac{\partial L}{\partial B} = \frac{\partial L}{\partial C}\frac{\partial C}{\partial B} = A^T \left(\frac{\partial L}{\partial C}\right)$$
这需要 $2NPM$ FLOP 次来计算(因为它在 $N$ 维度上收缩)。同样,关于A的损失的导数是
$$\frac{\partial L}{\partial A} = \frac{\partial L}{\partial C}\frac{\partial C}{\partial A} = \left(\frac{\partial L}{\partial C}\right) B^T$$
这又是 $2NPM$ FLOP,因为 dL/dC 是大小为 $[N, M]$ 的矩阵。虽然这个数量不是导数。一个参数,它用于计算网络前几层的导数(例如,就像上面的 dL/dC 用于计算 dL/dB 一样)。
将这些加起来,我们看到在训练期间,我们总共有 6NPM FLOP,而推理期间为 2NPM:前向传播中为 2NPM,反向传播中为 4NPM。由于 PM 是矩阵中参数的数量,因此这是训练期间 Transformer FLOP 著名的 $6 * \text{num parameters} * \text{num tokens}$ 近似的最简单形式:每个token需要 $6 * \text{num parameters}$ FLOP。下面我们将展示一个更正确的推导。
Transformer 的参数量与计算量核算
Transformer 是未来——至少,它已经是当下的主流架构。几年前,它还只是众多模型架构之一;但今天,深入了解它的各个细节很有价值。这里不再重新介绍 Transformer 架构;需要回顾的话,可以参考这篇博客和原始 Transformer 论文。
这是 Transformer 解码器架构的基本图:
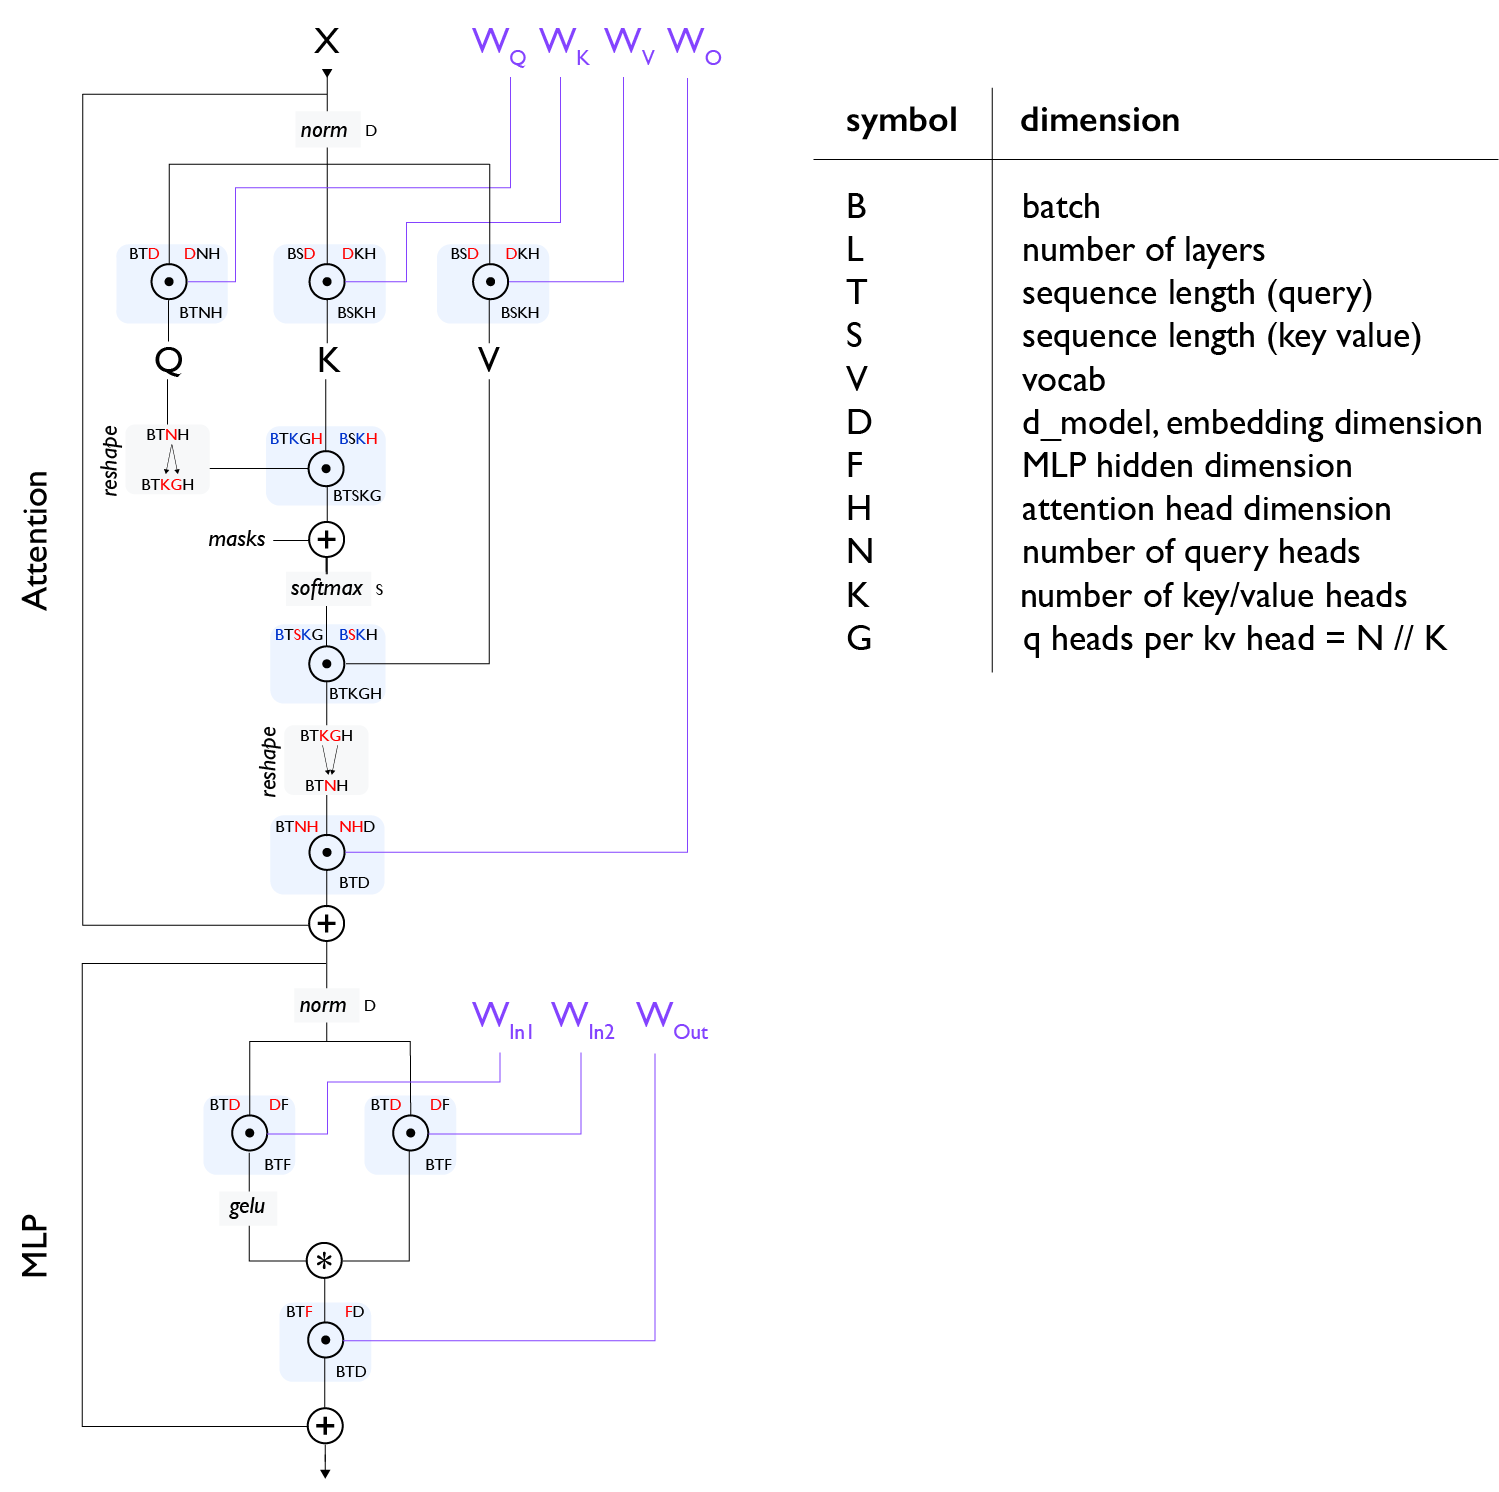
图: 该图显示了标准 Transformer 的一层并从上到下流动。我们使用单字母约定来描述 Transformer 中数组的形状和布局,再次以红色显示收缩维度,以蓝色显示批量维度。在给定的操作中,输入形状在左上角给出,参数形状在右上角给出,结果形状在下面,例如BTD 是门控 einsum 的输入形状,DF 是权重形状。
**注意 [gating einsum]**:上图使用了“gating einsum”,其中我们将上投影矩阵分成两个矩阵(上面的 $W_\text{In1}$ 和 $W_\text{In2}$),其输出按元素相乘,作为一种“门控功能”。并非所有 LLM 都使用此矩阵,因此你有时会看到单个 $W_\text{In}$ 矩阵和 $2DF$ 而不是 $3DF$ 的 MLP 参数总数。通常在这种情况下,$D$ 和 $F$ 将按比例放大,以保持参数计数与 3 矩阵情况相同。尽管如此,LLaMA、DeepSeek 和许多其他模型都使用某种形式的门控 einsum。
**注 2 [MHA 注意力]**:对于自注意力,$T$ 和 $S$ 是相同的,但对于交叉注意力,它们可能不同。对于普通多头注意力(MHA),$N$ 和 $K$ 相同;对于多查询注意力(MQA),$K=1$;对于分组多查询注意力(GQA),$K$ 只需能够整除 $N$。
注3 [前范数与后范数]: 上图显示了所谓的“前范数”架构,其中范数出现在残差连接之前,通常为 x + attn(norm(x))。像 LLaMA-3 这样的模型现在就使用这个。最初的 Transformer 论文使用了“后范数”架构,其中层范数发生在残差连接之后,即 norm(x + attn(x))。
全局 FLOP 和参数计算
让我们计算 Transformer 的每层 FLOP(这样我们就可以避免在任何地方都坚持 L 因子)。请注意,下面的训练 FLOP 几乎总是推理 FLOP 的 3 倍,因此你可以将任何总数除以 3 以获得前向传播的成本。
MLP
Transformer 的 MLP 通常由 2 个按元素组合的输入 matmul 和一个输出 matmul 组成:
$$
\begin{array}{ccc}
\textrm{operation} & \textrm{train FLOPs} & \textrm{params} \
\hline \
A[B,T,\red{D}] \cdot W_{in1}[\red{D}, F] & 6BTDF & DF \[10pt]
A[B,T,\red{D}] \cdot W_{in2}[\red{D}, F] & 6BTDF & DF \[10pt]
\sigma\left(A_{in1}\right)[B,T, F] * A_{in2}[B,T, F] & \gray{O(BTF)} \[10pt]
A[B,T,\red{F}] \cdot W_{out}[\red{F}, D] & 6BTDF & DF \[10pt]
\hline \
& \approx 18BTDF & 3DF
\end{array}
$$
注意力
对于具有不同 Q 和 KV 头数的通用分组查询注意情况,让我们假设 Q、K、V 投影的头尺寸 H 相等,并估计 QKVO 矩阵相乘的成本:
$$
\begin{array}{ccc}
\textrm{operation} & \textrm{train FLOPs} & \textrm{params} \
\hline \
A[B,T,\red{D}] \cdot W_{Q}[\red{D}, N, H] & 6BTDNH & DNH \[10pt]
A[B,T,\red{D}] \cdot W_{K}[\red{D}, K, H] & 6BTDKH & DKH \[10pt]
A[B,T,\red{D}] \cdot W_{V}[\red{D}, K, H] & 6BTDKH & DKH \[10pt]
A[B,T,\red{N}, \red{H}] \cdot W_{O}[\red{N}, \red{H}, D] & 6BTDNH & DNH \[10pt]
\hline \ & 12BTD(N+K)H & 2D(N+K)H
\end{array}
$$
点积注意力操作更加微妙,实际上是在 $B$、$K$ 维度上批处理的 $TH \cdot HS$ matmul、softmax 和在 $B$、$K$ 维度上再次批处理的 $TS \cdot SH$ matmul。我们用蓝色突出显示批处理的暗淡:
$$
\begin{array}{cc}
\textrm{operation} & \textrm{train FLOPs} \
\hline \[3pt]
Q[\blue{B}, T, \blue{K}, G, \red{H}] \cdot K[\blue{B}, S, \blue{K}, \red{H}]
& 6BTSKGH = 6BTSNH \[3pt]
\textrm{softmax}_S ;; L[B, T, S, K, G] & \gray{O(BTSKG) = O(BTSN)} \[3pt]
S[\blue{B}, T, \red{S}, \blue{K}, G] \cdot V[\blue{B}, \red{S}, \blue{K}, H]
& 6BTSKGH = 6BTSNH \[3pt]
\hline \
& \approx 12BTSNH = 12BT^2NH \
\end{array}
$$
**注意[因果屏蔽]**:最近的 Transformer 使用因果屏蔽,而不是完全双向关注。在这种情况下,点积运算的有用 FLOP 会减少一半。为了在实践中实现这种减少,我们需要使用注意力内核,而不是朴素的 einsum。
其他操作
Transformer 中还发生其他一些操作。层范数相对便宜,对于一阶成本估计可以忽略。请注意,每一层通常有两个(一个在注意力之前,一个在 MLP 之前)。还有最后一个巨大的(尽管不是每层)非嵌入矩阵乘法。
$$
\begin{array}{ccc}
\textsf{operation} & \textsf{train FLOPs} & \textsf{params} \
\hline \
2 \times \textrm{layernorm}D ;; A[B,T,\red{D}] & \gray{O\left(BTD\right)} & \gray{2D} \[10pt]
A[B,T,\red{D}] \cdot W{unembed}[\red{D}, V] & 6BTDV & DV \
\end{array}
$$
Transformer FLOP 的一般经验法则
如果我们忽略点积注意力的成本(这对于较短上下文的训练是合理的),那么所有层的总 FLOP 是
$$
\begin{align*}
(18BTDF + 12BTD(N+K)H)L = 6 BT * (3DF + 2D(N+K)H)L \ = 6 * \textrm{num tokens} * \textrm{parameter count}
\end{align}
$$
这导致了一个著名的经验法则,用于估计密集 Transformer FLOP 计数,忽略注意力 FLOP。 (取消嵌入是另一个简单的 matmul,具有 $6BTDV$ FLOP 和 $DV$ 参数,并遵循相同的经验法则。)
注意力成本与上下文长度的关系
如果我们确实考虑了上面的点积注意力并假设 $F=4D$、$D=NH$(典型情况)和 $N=K$,则点积注意力 FLOP 与所有 matmul FLOP(包括注意力投影)的比率为:
$$\small{\frac{\textrm{attention FLOPs}}{\textrm{matmul FLOPs}} = \frac{12BT^2NH}{18BTDF + 24BTDNH} = \frac{12BT^2D}{4*18 BTD^2 + 24 BTD^2} = \frac{12BT^2D}{96 BTD^2} = \frac{T}{8D}}$$
结果是,点积注意力仅在训练期间 $T>8D$ 时才占主导地位。对于 $D \sim 8\text{k}$,临界点约为 64K token。这是有道理的,因为这意味着随着 MLP 大小的增加,注意力 FLOP 变得不那么重要。对于大型模型来说,注意力的二次成本实际上并不是长上下文训练的巨大障碍。然而,对于较小的模型,例如 $D=4608$ 的 Gemma 27B,注意力在 37K 左右的序列长度开始占主导地位。(原注:一些现代 OSS 模型引入了局部注意力或其他优化,降低了注意力成本并改变了 Roofline。)Flash Attention 也有助于减轻长上下文的成本,我们在附录 A中简要讨论。
补充计算:MoE、重计算与 KV 缓存
稀疏性和混合专家
如果我们不简要讨论混合专家(MoE)模型,那就太失职了。它用一组可以动态路由的独立 MLP 取代标准 Transformer 中的单个密集 MLP 块。作为一阶近似,MoE 可以看作一个每层有 $E$ 个 MLP 块的普通密集模型,而不是只有一个。每个 token 会激活其中的 $k$ 个专家,通常有 $k \ll E$。比率 $E/k$ 称为稀疏度,通常在 8 到 64 之间(例如 DeepSeek-V3 有 $k=8$、$E=256$)。与密集版本相比,这将参数量增加到 $O(E)$,而每个 token 激活的参数量只乘以 $k$。
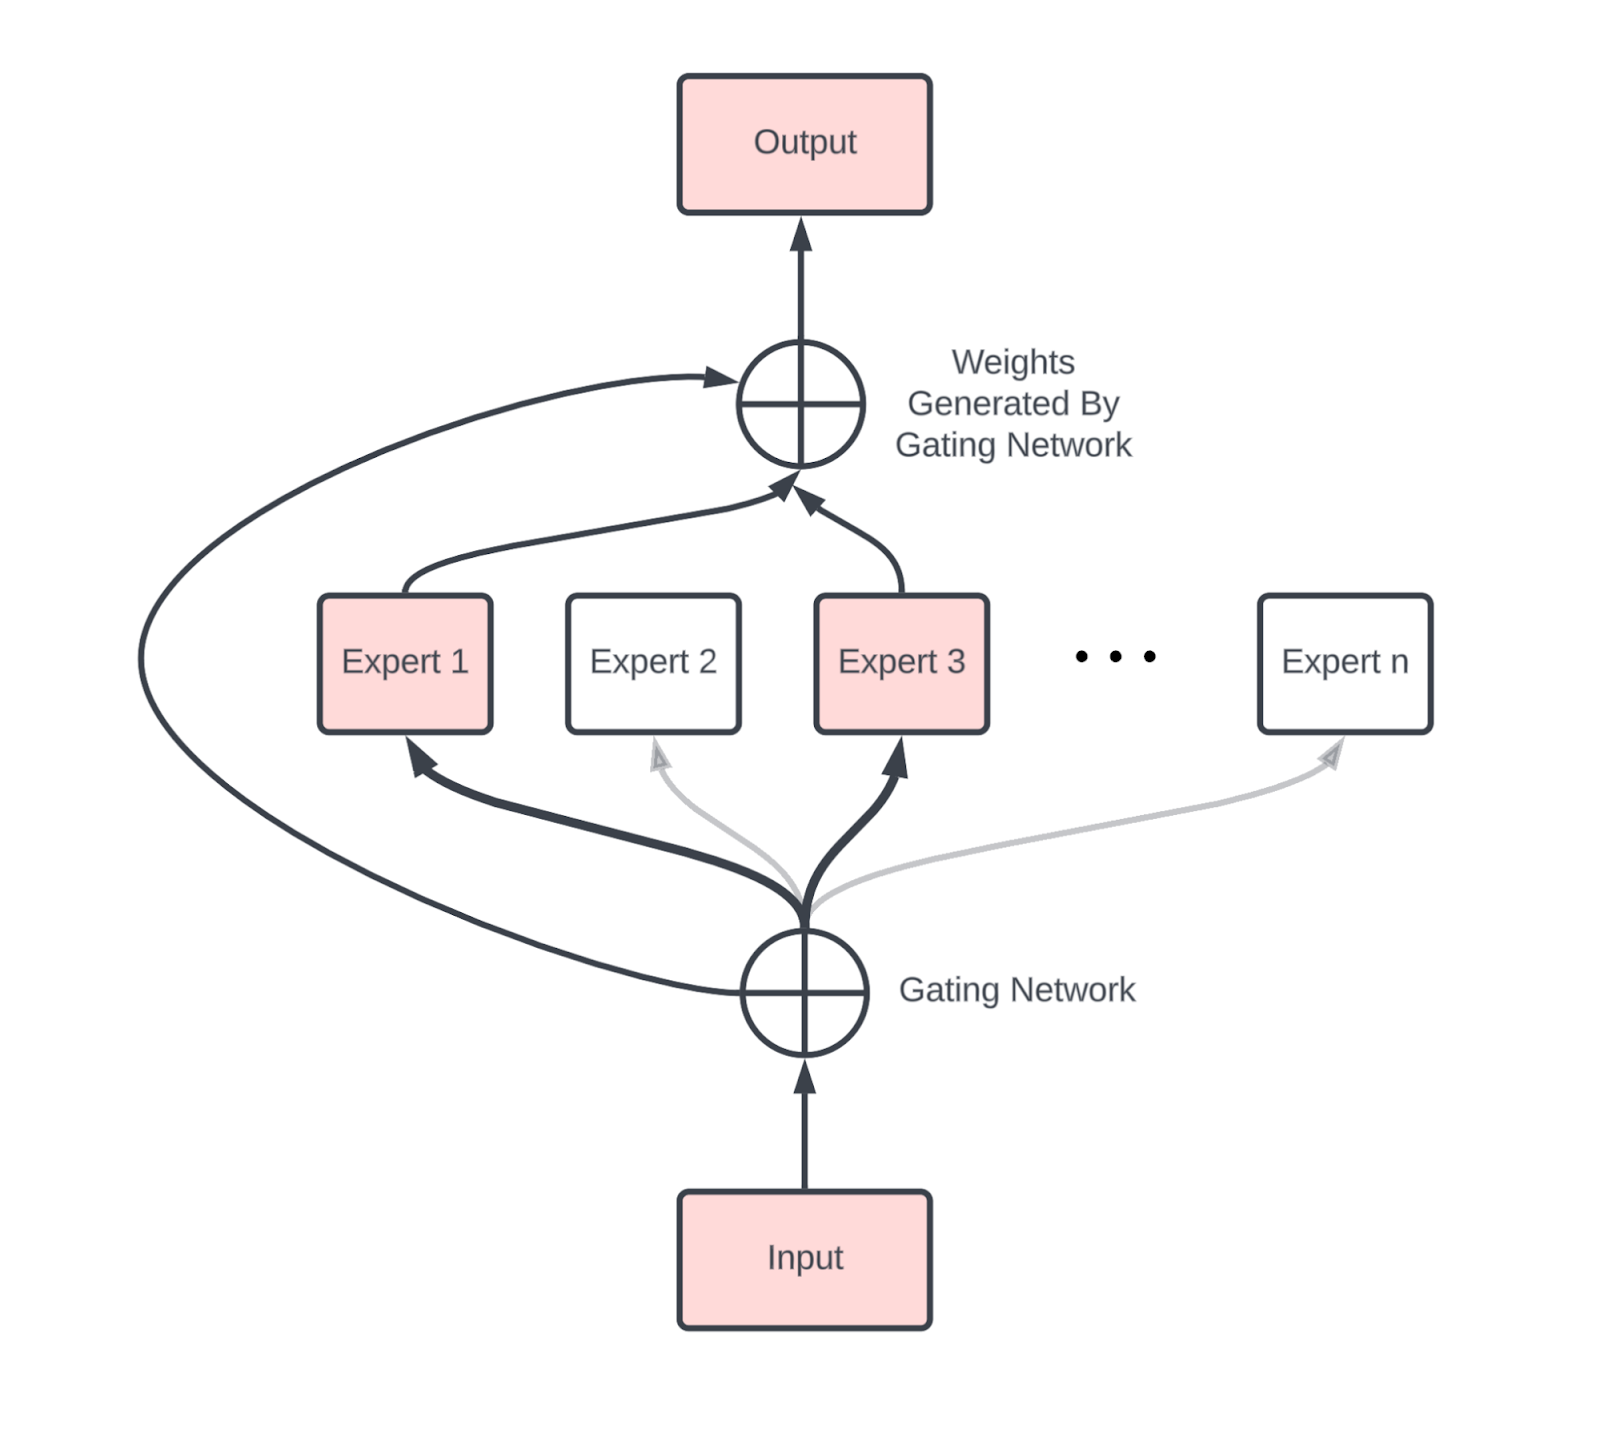
图:一个含 $n$ 个专家的 MoE 层。门控模块将每个 token 路由给其中 $k$ 个专家,再把这 $k$ 个 MLP 的输出相加。总参数量是单个专家参数量的 $n$ 倍,但每个 token 只使用其中 $k$ 个专家。来源。
与稠密模型相比,MoE 会引入新的通信,主要是在 MoE 模块前后各执行一次 AllToAll,将 token 送给正确的专家,再送回原来的设备。(原注:严格来说,只有数据或序列沿专家所在的同一设备轴分片时,才会发生这种通信。)不过,上一章已经说明,在双向环网络上,每次 AllToAll 的开销只有同一轴上可比 AllGather 的四分之一。
梯度检查点
反向传播这种算法用内存换取了计算量的减少:反向传播不必花费 $O(n_\text{layers}^2)$ FLOPs,却需要 $O(n_\text{layers})$ 的内存,来保存前向传播产生的全部中间激活。虽然这比二次增长的计算量更好,内存开销仍然很大。例如,若模型的 $B \times T=4\text{M}$(每批总计 400 万个 token)、$L=64$、$D=8192$,并且完全避免反向传播中的额外重计算,就要保存约 $2 \times 20 \times B \times T \times D \times L = 84\text{TB}$ 的 bf16 激活。这里的 20 来自对上面 Transformer 示意图中各个中间节点的粗略计数。例如:
$$f(x) = \exp(g(x))$$
$$\frac{df}{dx} = \exp(g(x)) \cdot \frac{dg}{dx}$$
所以,要避免重计算,就必须保存前向传播中的 $g(x)$ 和 $\exp(g(x))$。为了减少内存占用,我们可以只保存一部分中间激活。下面介绍几种常用做法。
- 整层重计算(block remat):只保存每层的输入。这是这里采用的最激进方案,每层只保存一个检查点,所以上例只需保存 4.2TB。但反向传播时,几乎要重新执行全部前向计算,运算量便从 $6 \cdot \text{num params} \cdot \text{num tokens}$ 增加到约 $8 \cdot \text{num params} \cdot \text{num tokens}$。
- 只保存大型矩阵乘法的输出:另一种简单策略是保留大型矩阵乘法的结果。这样,反向传播不必重做这些矩阵乘法,但仍要重新计算其他激活函数和一部分注意力操作。每层需要保存的中间结果数量,会从上面的约 20 个降到约 7 个。
这些策略并未覆盖所有情况。在 JAX 中,通常使用 jax.remat/jax.checkpoint 控制这些行为,更多说明见这里。
键值缓存(KV cache)
原著第 7 章将详细说明,LLM 推理包含两个主要阶段:预填充与生成。
- 预填充(prefill)处理较长的提示词,并把注意力模块的激活保存到键值缓存(KV cache),供生成阶段使用。具体保存的是注意力模块中键和值的投影。
- 生成(generation)把多份 KV cache 组成一个批次,分别从每个序列的分布中采样 token。
每份 KV cache 实际上可以看作形状为 $[2, S, L, K, H]$ 的数组,其中 2 表示键和值。这已经相当大了!采用 int8 时,KV cache 的总大小为 $2SLKH$。对于上下文长度 8k、64 层、$KH = NH = D = 8192$ 的中等规模模型,这相当于 $2 \cdot 8192 \cdot 64 \cdot 8192 = 8\text{GiB}$。这也解释了为什么我们希望采用 $K \ll N$ 的 GMQA。
本章需要记住什么?
- Transformer 的总参数量与 FLOPs 比较容易计算。下表给出了采用 MHA 时的汇总:批量为 $B$,词表大小为 $V$,序列长度为 $T$,$D=d_\text{model}$,$F=d_\text{ff}$。
| 组件 | 每层参数 | 每层训练 FLOPs |
|---|---|---|
| MLP | $3DF$ | $18BTDF$ |
| 注意力 | $4DNH$ | $24BTDNH + 12BT^2NH$ |
| 其他 | $2D$ | $BTD$ |
| 词表 | $DV$(总计,不是每层) | $12BTDV$ |
- MLP 块的参数计数主导总参数计数,并且只要序列长度为 $T < 8D$,MLP 块也主导 FLOP 预算。
- 对于合理的上下文长度,训练期间的总 FLOP 预算非常接近 $6 \cdot \text{num_params} \cdot \text{num_tokens}$。
- 在推理过程中,我们的 KV 缓存大约为每个缓存 $2 \cdot S \cdot L \cdot K \cdot H$(其中 $K$ 是 KV 头的数量),尽管架构修改通常可以减少这一点。
工作中的一些问题
问题1: $D=4096$、$F=4 \cdot D$、$V=32,000$、$L=64$ 的模型有多少个参数?其中哪些部分是注意力参数?每个token的 KV 缓存有多大? 你可以假设 $N\cdot H=D$ 和具有 int8 KV 的多头注意力。
答案:
总参数大约为 $L \cdot (3DF + 4DNH + 2D) + 2DV$(计算每层的两个层范数)。对于给定的数字,这是 $64 \cdot (3 \cdot 4e3 \cdot 16e3 + 4 \cdot 4e3 \cdot 4e3 + 2 \cdot 4e3) + 2 \cdot 4e3 \cdot 32e3 = 16e9$,或 16B 参数。
一般情况下,注意力参数占总参数的比例为 $4DNH / (4DNH + 3DF) = 4D^2 / (4D^2 + 12D^2) = 1/4$。这意味着大约 1/4 的参数用于注意力。
对于每个 token,我们的 KV 缓存是 int8 形式的 $2 \cdot L \cdot N \cdot H = 2 \cdot 64 \cdot 4096$,即
512 KiB / token。
问题 2: 在 {'X': 4, 'Y': 8, 'Z': 4} 的设备网格上执行 $A[B_X,D_Y] \cdot_D W[D_Y,F]$,总共需要多少 FLOP?每个 TPU 执行多少 FLOP?
答案:
该操作的总“理论”算力为 $2 \cdot B \cdot D \cdot F$。然而,由于计算并未在 Z 维度上进行分片,因此我们实际上执行了 Z 次额外的 FLOP,这意味着总 FLOP 为 $2 \cdot B \cdot D \cdot F \cdot Z$。由于计算是跨其他维度进行分片的,因此每台设备的总计算量大约为 $2 \cdot B \cdot D \cdot F / (X \cdot Y)$。
问题 3: 执行 $A[I,J,K,L] \cdot B[I,J,M,N,O] \rightarrow C[K,L,M,N,O]$ 涉及多少 FLOP?
答案:
遵循上述规则,我们将 I 和 J 作为收缩维度,将 K、L、M、N 和 O 作为非收缩维度。我们没有“批处理维度”,所以这只是 $2 \cdot I \cdot J \cdot K \cdot L \cdot M \cdot N \cdot O$,所有轴的乘积。如果我们有一个共享轴,它只会被计算一次。
问题 4: 分组多查询注意力的算术强度是多少(忽略 Q/K/V/O 投影)? 给出作为 Q 和 KV 序列长度 T 和 S 以及多查询因子 G 的函数的答案。 在什么上下文长度下注意力 FLOP 受限?给定 TPU 的 HBM 带宽,绘制随着上下文长度增长,关注 FFW 块的有效相对成本。 提示:假设我们使用有效的注意力实现,不会执行任何不必要的读/写。考虑 T = S 和 T << S 的极限。
答案:
自注意力需要加载 $Q$、$K$ 和 $V$ 激活,然后计算 $\text{softmax}(Q \cdot K) \cdot V$,然后将结果写回 HBM。这将通过 Flash Attention 来完成,因此对这个数学有一些注意事项,但基本上在 bf16 自注意力中执行
$$\text{Q[B,T,N,H]} \rightarrow_\text{reshape} \text{Q[B, T, K, G, H]} \cdot \text{K[B, S, K, H]} \rightarrow \text{O[B, T, S, K, G]}$$
$$U=\text{softmax}_S(\text{O[B, T, S, K, G]})$$
$$\text{U[B, T, S, K, G]} \cdot \text{V[B, S, K, H]} \rightarrow \text{X[B, T, K, G, H]}$$
所以我们的总字节数是 $2 * \text{sizeof}(Q) + 2 * \text{sizeof(K or V)} = 4BTNH + 4BSKH = 4BHK * (TG + S)$,总 FLOP 是 $4BTSNH + O(BTSN)$,算术强度是 $4BTSKGH / (4BHK * (TG + S))$。
所以基本上,在预填充期间我们有 $S=T$,所以我们有 $4BT^2KGH / 4BHKT \cdot (G+1) = TG/(G + 1) = O(T)$ 的算术强度。在生成过程中,$T=1$,因此我们有 $4BSKGH / (4BHK \cdot (G + S)) = SG / (G + S) \rightarrow G$,假设 $S$ 非常大。根据你解释问题的方式,在预填充或训练期间,假设没有序列分片,自注意力在 S=240 处受计算受限。在生成过程中,我们永远不会受计算受限,因为 $G$ 很小。尽管如此,你可以看到增加 $G$ 使我们更接近计算极限。
问题 5: 在什么序列长度下,自注意力 FLOP 等于 QKVO 投影 FLOP?
答案:
这纯粹是 $24BTDNH = 12BT^2NH$ 何时成立的问题。简化后得到 $2D = T$,所以对于 $D=4096$,临界序列长度是 $8192$。这告诉我们,对于大多数常见上下文长度,matmul FLOP 更大。
问题 6: 假设我们在前向传播期间仅保存 Transformer 层中 7 个主要矩阵乘法的输出(Q、K、V、O 加上三个 FFW 矩阵)。在反向传播过程中,需要额外执行多少 FLOP 来完成重计算?
答案:
仅保存七个 matmul 输出(Q、K、V、O、W₁、W₂、W₃)意味着反向传播必须重新计算两个注意力 matmul
$$QK^{\top} \quad\text{and}\quad \operatorname{softmax}(QK^{\top})V$$
以获得$\frac{\partial L}{\partial W_\text{O}}$。
每个都是 $T \times T$ matmul,通过 $B$ 序列和 $N$ 头进行批处理,因此额外的 FLOP 为
$$4 ; B , T^{2} , N , H.$$
其他重新计算的操作有:
$O(BTD)$ 为 $\frac{\partial L}{\partial W_\text{In1}}$ 和 $\frac{\partial L}{\partial W_\text{In2}}$。
$O(BTF)$ 为 $\frac{\partial L}{\partial W_\text{Out}}$。
问题 7: DeepSeek v3 表示它在 14.8T token上训练了 279 万小时的 H800 小时(来源)。鉴于它有 37B 个激活参数,它们大致实现了多少硬件利用率? 提示:请注意,他们使用了没有结构化稀疏性的 FP8 FLOP。
答案:
从此处的规格表中,我们发现稀疏情况下 FP8 性能为 3,026 TFLOPs/s,或者在没有稀疏情况下通常为该性能的一半 (1.513e15 FLOPs/s)。 279 万小时 H800 意味着 2.79e6 * 1.513e15 * 60 * 60 = 1.52e25 总算力。鉴于激活的参数计数为 37B,此训练运行应该使用大约 6 * 37e9 * 14.8e12 = 3.3e24 FLOP。这意味着 FLOP 利用率约为 3.3e24 / 1.52e25 = 21.7%。
问题 8:混合专家(MoE)模型有 $E$ 份标准稠密 MLP,每个 token 激活其中 $k$ 个专家。在 TPU v5e 上,如果权重采用 int8,需要多大的 token 批量才能达到计算受限?DeepSeek 有 256 个路由专家,且 $k=8$,此时这个数是多少?
答案:
因为我们有每个专家的 $E$ 副本,在 int8 中,对于每个权重矩阵,我们需要加载 $E \cdot D \cdot F$ 字节。因为每个token都会激活 $k$ 专家,所以对于每个权重矩阵,我们都有 $2\cdot k \cdot B \cdot D \cdot F$ FLOP。为了受到 int8 权重和 bfloat16 FLOP 的计算受限,我们需要算术强度(加载的每字节 FLOP)超过 TPU 的约 240 FLOP/字节,这在 $(2\cdot k \cdot BDF) / EDF > 240$ 或 $k \cdot B / E > 120$ 时发生。
因此,我们需要 $B > 120 \cdot E / k$ 进行计算受限。对于 DeepSeek,这给我们 $B > 120 \cdot 256 / 8 = 3840$。这在生成时是一个非常大的批量大小。
第 4 章到此结束!原著第 5 章将讨论如何扩展 Transformer 训练。
附录
附录 A:Flash Attention 是如何工作的?
将 Transformer 扩展到很长上下文的传统反对意见是,注意力 FLOP 和内存使用量与上下文长度呈二次方缩放。虽然注意力 QK 产品的形状确实是 $[B, T, S, N]$,其中 B 是批量大小,T 和 S 是 Q 和 K 序列暗淡,N 是头数,但这种说法有一些严重的警告:
- 正如我们之前提到的,即使这是二次的,注意力 FLOP 仅在 $T > 8 \cdot D$ 时占主导地位,并且在训练期间,与内存中的所有权重和激活检查点相比,单个注意力矩阵的内存很小,尤其是在分片时。
- 我们不需要具体化完整的注意力矩阵来计算注意力!我们可以计算局部总和和最大值,并避免实现超过数组的一小部分。虽然总 FLOP 仍然是二次方,但我们极大地减少了内存压力。
第二个观察首先由Rabe et al.。 2021 以及随后的 Flash Attention 论文(Dao 等人,2022)。基本思想是计算 K/V 块中的注意力,其中我们计算局部 softmax 和一些辅助统计数据,然后将它们传递到下一个块,将它们与其局部块组合。具体来说,我们计算
- M: $q \cdot k$ 在序列维度上的运行最大值
- O: 在序列维度上运行全注意力 softmax
- L: 运行分母 $\sum_i \exp(q \cdot k_i - \text{running max})$
有了这些,我们就可以仅使用恒定量的内存来计算新的最大值、新的运行总和以及新的输出。粗略地描述一下它是如何工作的,注意力大致是这样的操作:
$$\text{Attn}(Q, K, V) = \sum_i \frac{\exp(Q \cdot K_i - \max_j Q \cdot K_j) V_i}{\sum_l \exp(Q \cdot K_l - \max_j Q \cdot K_j)}$$
减去最大值是为了提高数值稳定性。由于 $\sum_i \exp(a_i + b) = \exp(b) \sum \exp(a)$,对所有分数减去同一个最大值,会使 softmax 的分子和分母乘上相同的因子,因此不改变最终结果。现在只看上式的分母:假设把键向量(key vectors)分成两个连续的块 $K^1$ 和 $K^2$,分别计算它们用于 softmax 归一化的局部指数和 $L^1$ 和 $L^2$:
$$L^1 = \sum_i \exp(Q \cdot K_i^1 - \max_j Q \cdot K_j^1)$$
$$L^2 = \sum_i \exp(Q \cdot K_i^2 - \max_j Q \cdot K_j^2)$$
然后我们可以使用以下方法将它们组合成这两个块的完整 softmax 总和:
$$L^\text{combined} = \exp(M^1 - \max(M^1, M^2)) \cdot L^1 + \exp(M^2 - \max(M^1, M^2)) \cdot L^2$$
在哪里
$$M^1 = \max_j Q \cdot K_j^1 \text{ and } M^2 = \max_j Q \cdot K_j^2$$
这也可以对完整的 softmax 完成,为我们提供了一种累积任意大的 softmax 总和的方法。这是 Flash Attention 论文中的完整算法。
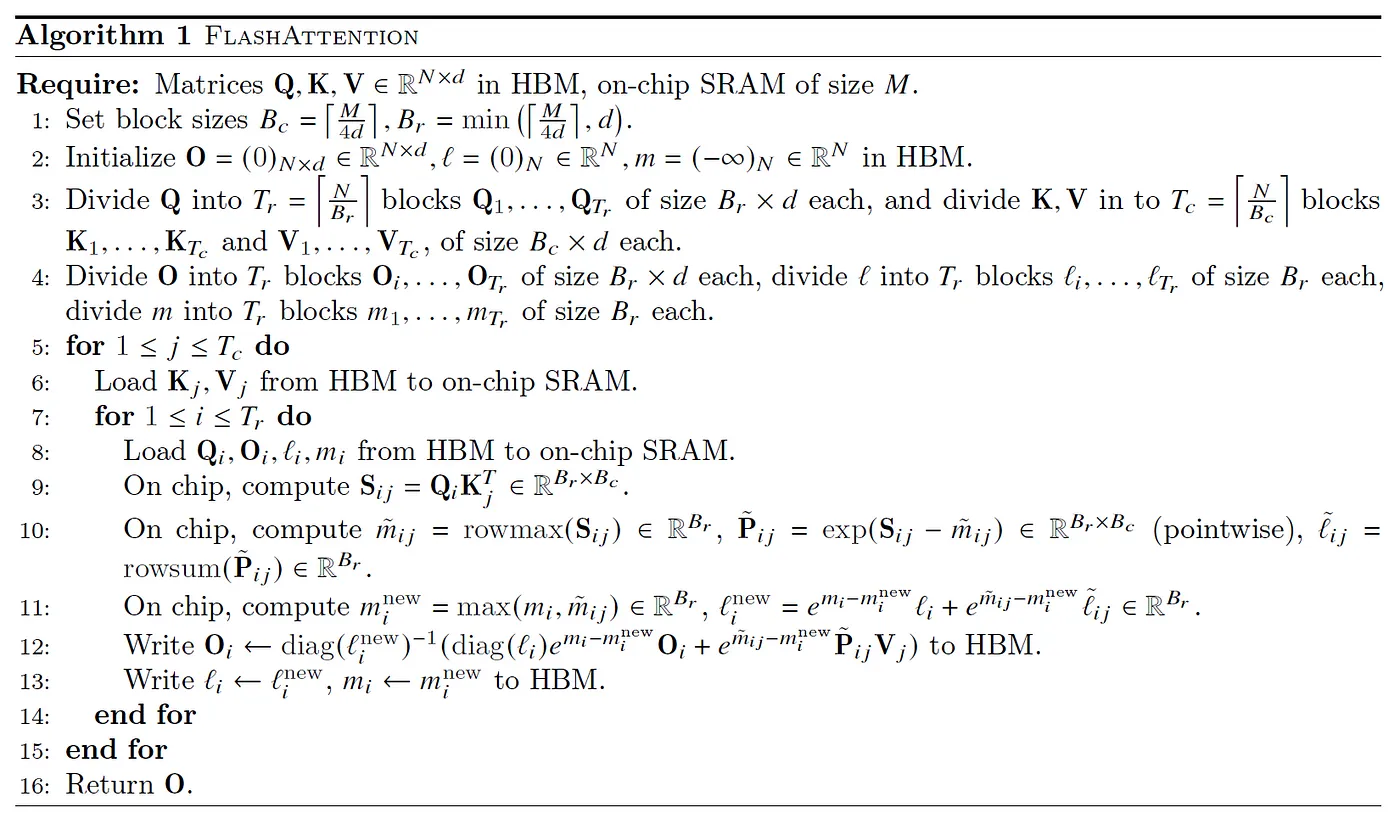
从硬件的角度来看,这让我们可以将 Q 块放入 VMEM(上面的算法称为片上 SRAM)中,因此我们只需在每次迭代时加载 KV 块,从而增加算术强度。我们还可以将运行统计数据保存在VMEM中。
最后一个值得强调的微妙点是注意力 softmax 属性,它用于使 Flash VJP(反向模式导数)计算对于训练实用。我们定义一个中间的softmax数组:
$$S_{ij} = \frac{e^{\tau q_i \cdot k_j}}{\sum_l e^{\tau q_i \cdot k_l}}$$
注意,我们从反向模式 dO 和 V 数组中获得 dS:
$$dS_{ij} = dO_{id} \cdot_d V_{jd} = \sum_d dO_{id} V_{jd}$$
在该梯度反向传播到 Q 和 K 期间
$$d(q_i \cdot k_j) = (dS_{ij} - S_{ij} \cdot_j dS_{ij}) S_{ij}$$
我们利用一个恒等式,允许我们将沿大密钥长度维度的收缩与沿特征深度维度的局部收缩进行交换。
$$\begin{align*}
S_{ij} \cdot_j dS_{ij} &= \sum_j \frac{e^{\tau q_i \cdot k_j}}{\sum_k e^{\tau q_i \cdot k_k}} \sum_d dO_{id} V_{jd} \
&= \sum_d dO_{id} \sum_j \frac{e^{\tau q_i \cdot k_j}}{\sum_k e^{\tau q_i \cdot k_k}} V_{jd} \
&= \sum_d dO_{id} O_{id} \
&= dO_{id} \cdot_d O_{id}
\end{align*}$$
这种替换对于能够为 VJP 实现序列块局部计算至关重要,并且能够实现更智能的分片方案,例如环关注。
译文与许可:本章是基于固定版本
173fb0851d7e654872f0327aff2e17607cf24106的机器辅助中文初译,并非逐句人工精校。原文与配图基于 MIT License 发布。Copyright (c) 2022 Maruan Al-Shedivat;Copyright (c) 2025 Google LLC。完整许可见 MIT License。