原著:Jacob Austin 等,Google DeepMind,《How to Scale Your Model》。本章原文。原文固定版本:
173fb0851d7e,获取日期:2026-10-26,MIT 许可。
本章为完整范围的机器辅助中文初译
简介:训练大型机器学习模型时,必须把参数或输入拆开,也就是分片,分给许多加速器。LLM 的主要操作是矩阵乘法,因此理解分片计算的关键,是理解跨设备分布的矩阵如何相乘。本章根据 TPU 通信原语的开销,建立一个简单的分片矩阵乘法分析方法。
分区表示法和集体运算
当我们在一万个 TPU 或 GPU 上训练法学硕士时,我们仍然在进行与训练时相同的抽象计算。不同之处在于我们的数组不适合单个 TPU/GPU 的 HBM,因此我们必须将它们拆分。(原注:值得注意的是,我们也可能选择并行化以提高速度。即使我们可以安装更少数量的芯片,扩大规模也只会给我们带来更多的 FLOPs/s。例如,在推理过程中,我们有时可以适应较小的拓扑,但选择扩展到较大的拓扑以减少延迟。同样,在训练期间,我们经常扩展到更多芯片以减少步骤时间。)我们将其称为“分片”或“分区”我们的数组。扩展的艺术在于弄清楚如何对模型进行分片,以便计算保持高效。
以下是跨 4 个 TPU 分片的 2D 数组 A 示例:
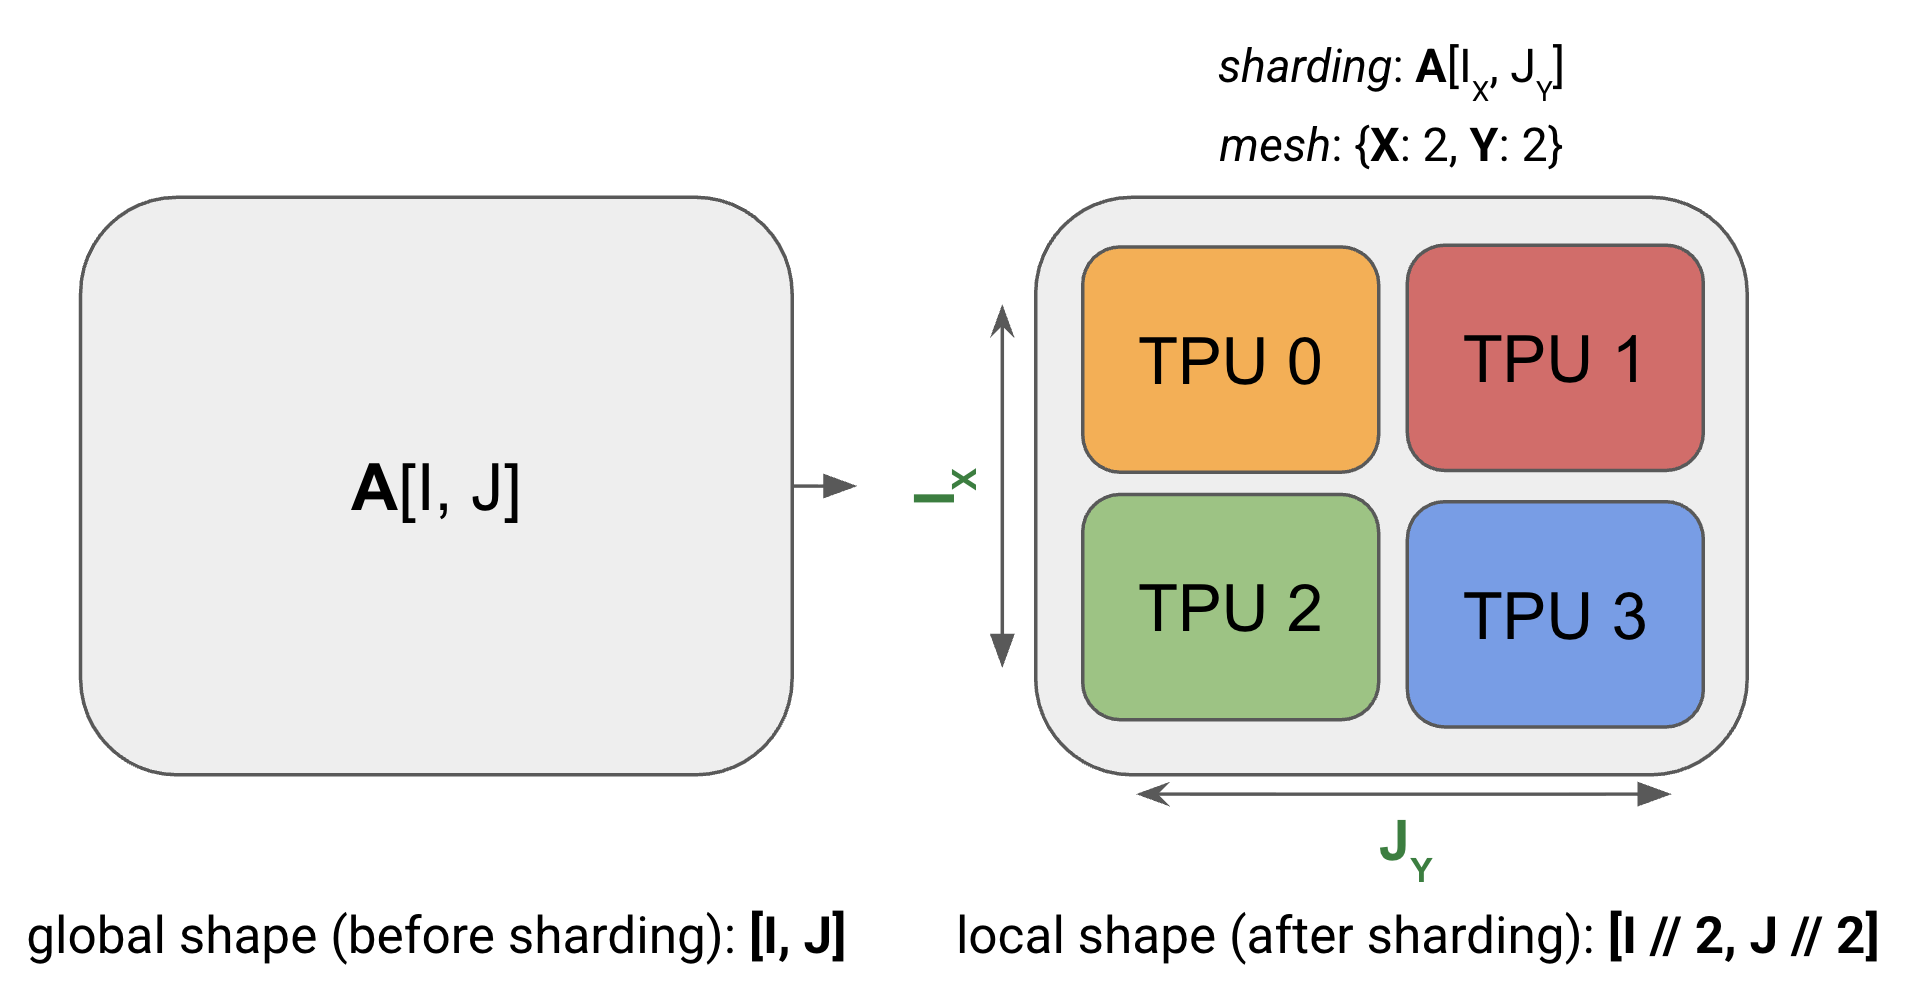
图: 形状为 A[I, J] 的示例数组在 4 个设备上进行分片。这两个维度均在 2 个设备上均匀分片,分片为 A[IX、JY]。每个 TPU 拥有总内存的 1/4。
请注意,分片数组仍然具有与未分片数组相同的“全局”或“逻辑形状”,例如 (4, 128),但它也具有“设备本地形状”,例如 (2, 64),它为我们提供了每个 TPU 所持有的实际大小(以字节为单位)(在上图中,每个 TPU 持有整个数组的 1/4)。现在我们将其推广到任意数组。
统一的分片符号
我们使用命名轴表示法的变体来描述张量如何在设备上分片:我们假设存在称为设备网格的设备的2D或3D网格,其中每个轴都被赋予了网格轴名称 例如X、Y 和 Z。 然后,我们可以通过描述数组的每个命名维度如何在物理网格轴上分区来指定矩阵数据如何在设备网格上布局。我们将此分配称为分片。
示例(上图):对于上图,我们有:
- 网格:
Mesh(devices=((0, 1), (2, 3)), axis_names=('X', 'Y'))上方的设备网格,它告诉我们在 2x2 网格中有 4 个 TPU,轴名称为 $X$ 和 $Y$。 - 分片: $A[I_X, J_Y]$,它告诉我们沿网格轴 $X$ 分片第一轴 $I$,沿网格轴 $Y$ 分片第二轴 $J$。这个分片告诉我们每个分片都保存着数组的 $1 / (\lvert X\rvert \cdot \lvert Y\rvert)$ 。
综上所述,我们知道数组的局部形状(单个设备保存的分片的大小)为 $(\lvert I\rvert / 2, \lvert J\rvert / 2)$,其中 $$\lvert I\rvert$$ 是 A 第一维度的大小,$$\lvert J\rvert$$ 是 A 第二维度的大小。
小测验 [跨 1 轴的 2D 分片]: 考虑一个具有分片 $A[I_{XY}, J]$ 和网格 {'X': 8, 'Y': 2} 的数组 fp32[1024, 4096]。每个设备保存多少数据?在 H100 上从 HBM 加载该阵列需要多少时间(假设每个芯片的内存带宽为 3.4e12)?
答案:
$A[I_{XY}, J]$ 沿 X 和 Y 硬件轴对第一维度 (I) 进行分片。在此示例中,局部形状为 $(\lvert I\rvert /(\lvert X\rvert \cdot \lvert Y\rvert), \lvert J\rvert)$。对于给定的示例,全局形状为 fp32[1024, 4096],因此局部形状为 fp32[64, 4096]。
由于每个 GPU 都有 4 * 64 * 4096 = 1MiB 字节,因此这将需要大约 1e6 / 3.4e12 = 294ns,尽管由于各种开销可能会显着增加,因为它太小了。
可视化这些分片: 让我们尝试通过查看分布在 4 个设备上的 2D 数据数组来可视化这些分片:
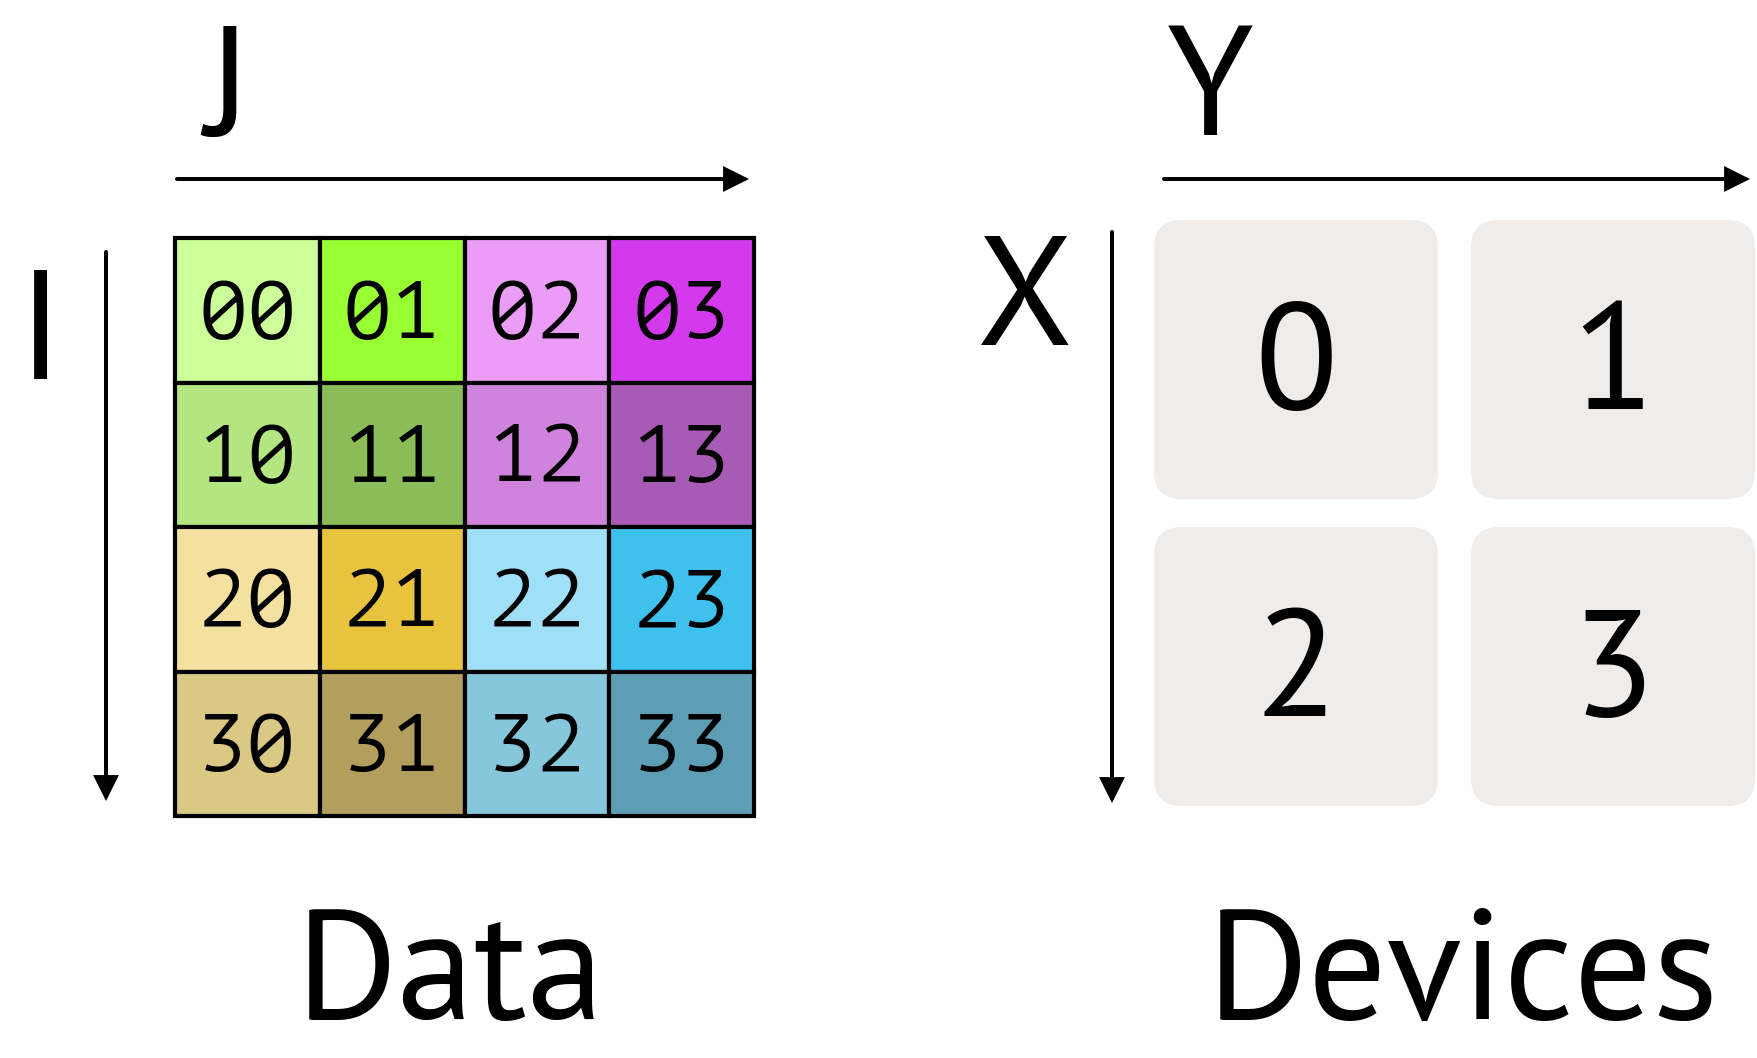
我们将矩阵的“完全复制”形式简单地写为 $A[I, J]$,没有分片分配。这意味着每个设备都包含整个矩阵的完整副本。
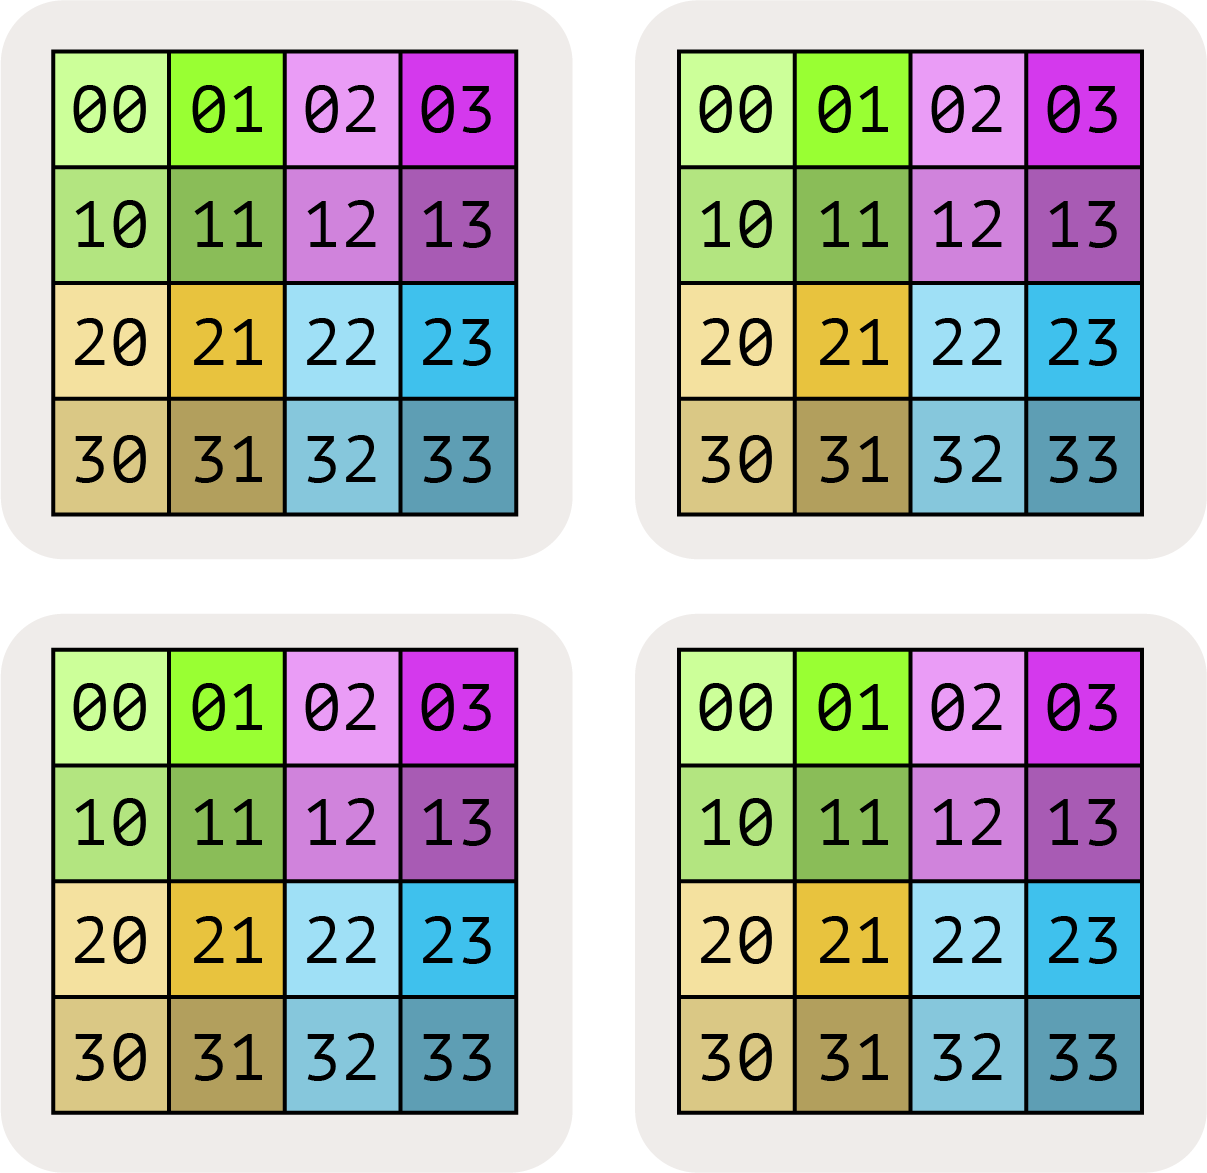
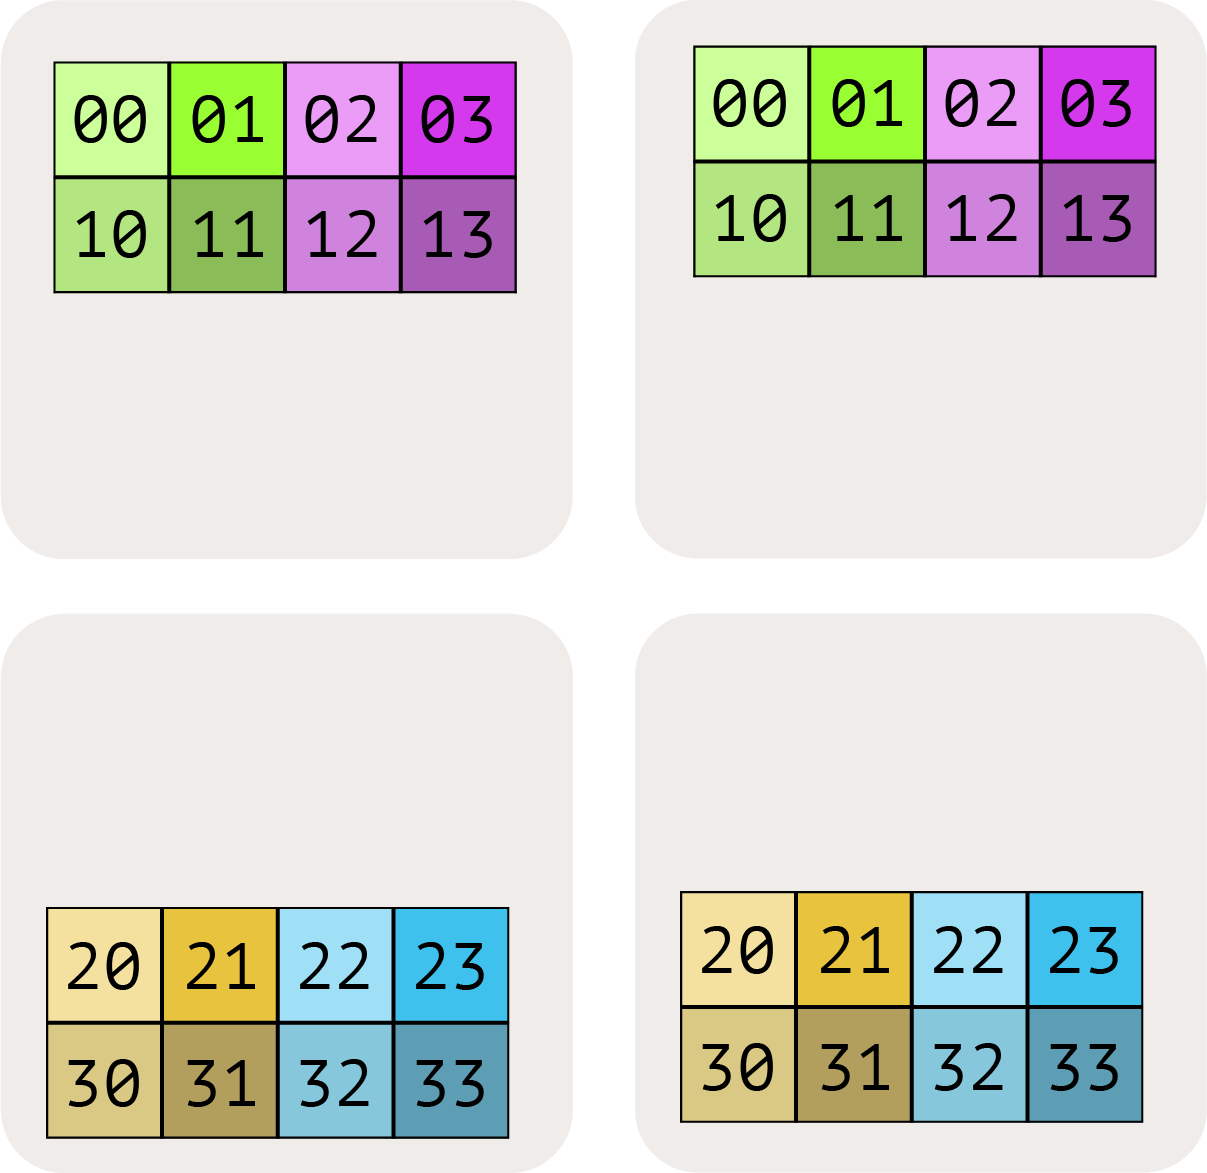
我们可以指示这些维度之一已通过下标网格轴在网格轴上进行分区。例如,$A[I_X, J]$ 意味着 I 逻辑轴已在 X 网格维度上进行分区,但 J 维度 未 分区,并且块在 Y 网格轴上保持“部分复制”。
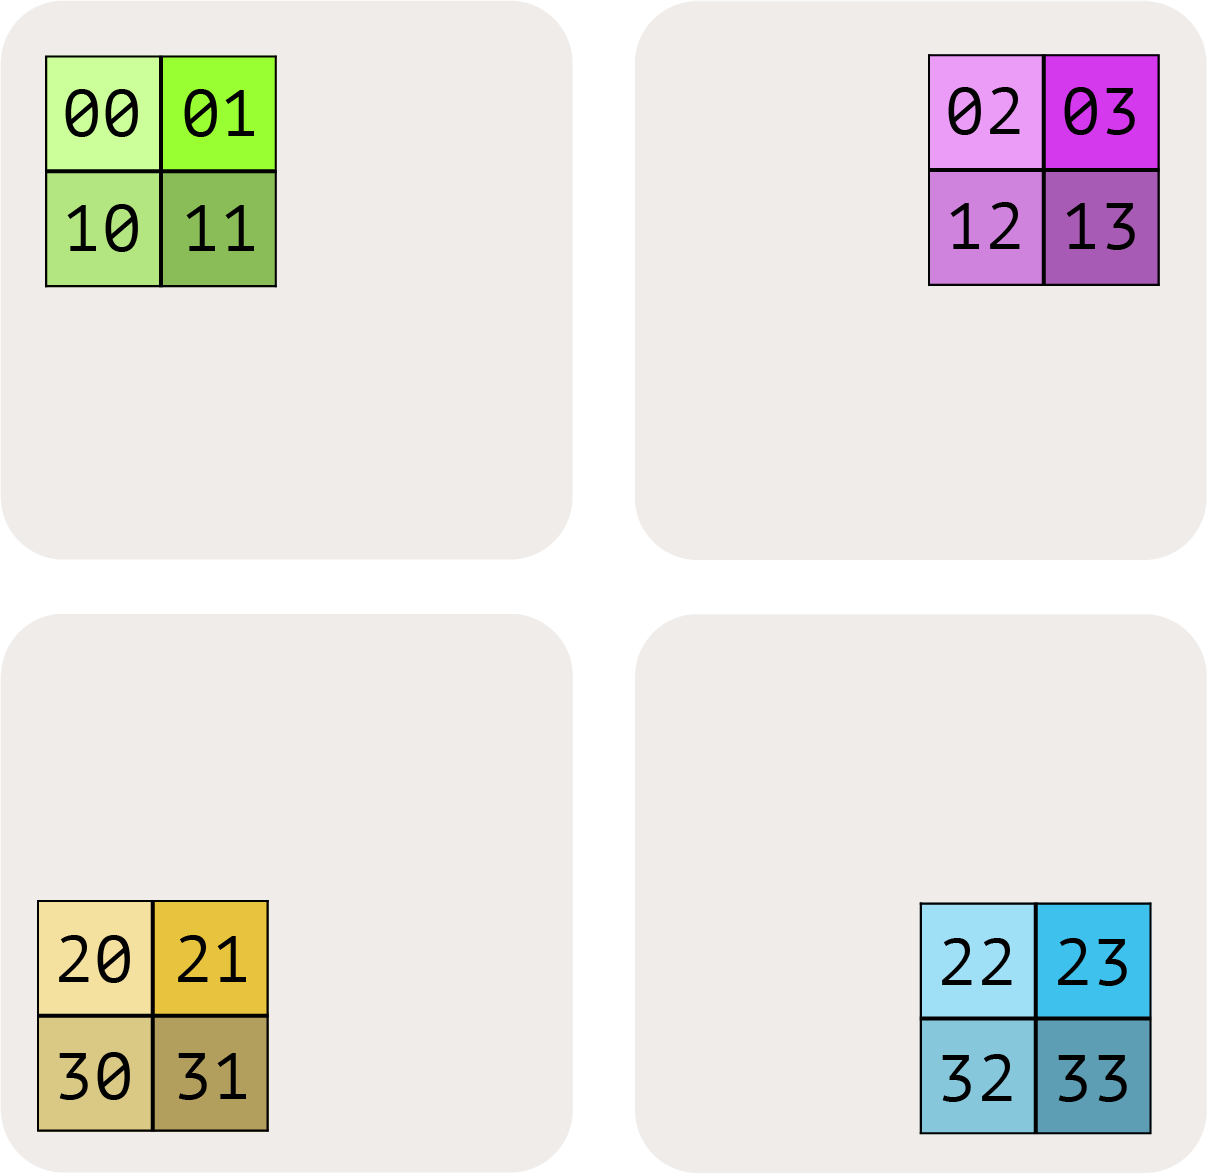
$A[I_X, J_Y]$ 表示 I 逻辑轴已跨 X 网格轴进行分区,并且 J 维度已跨 Y 网格轴进行分区。
我们在下图中说明了其他可能性:
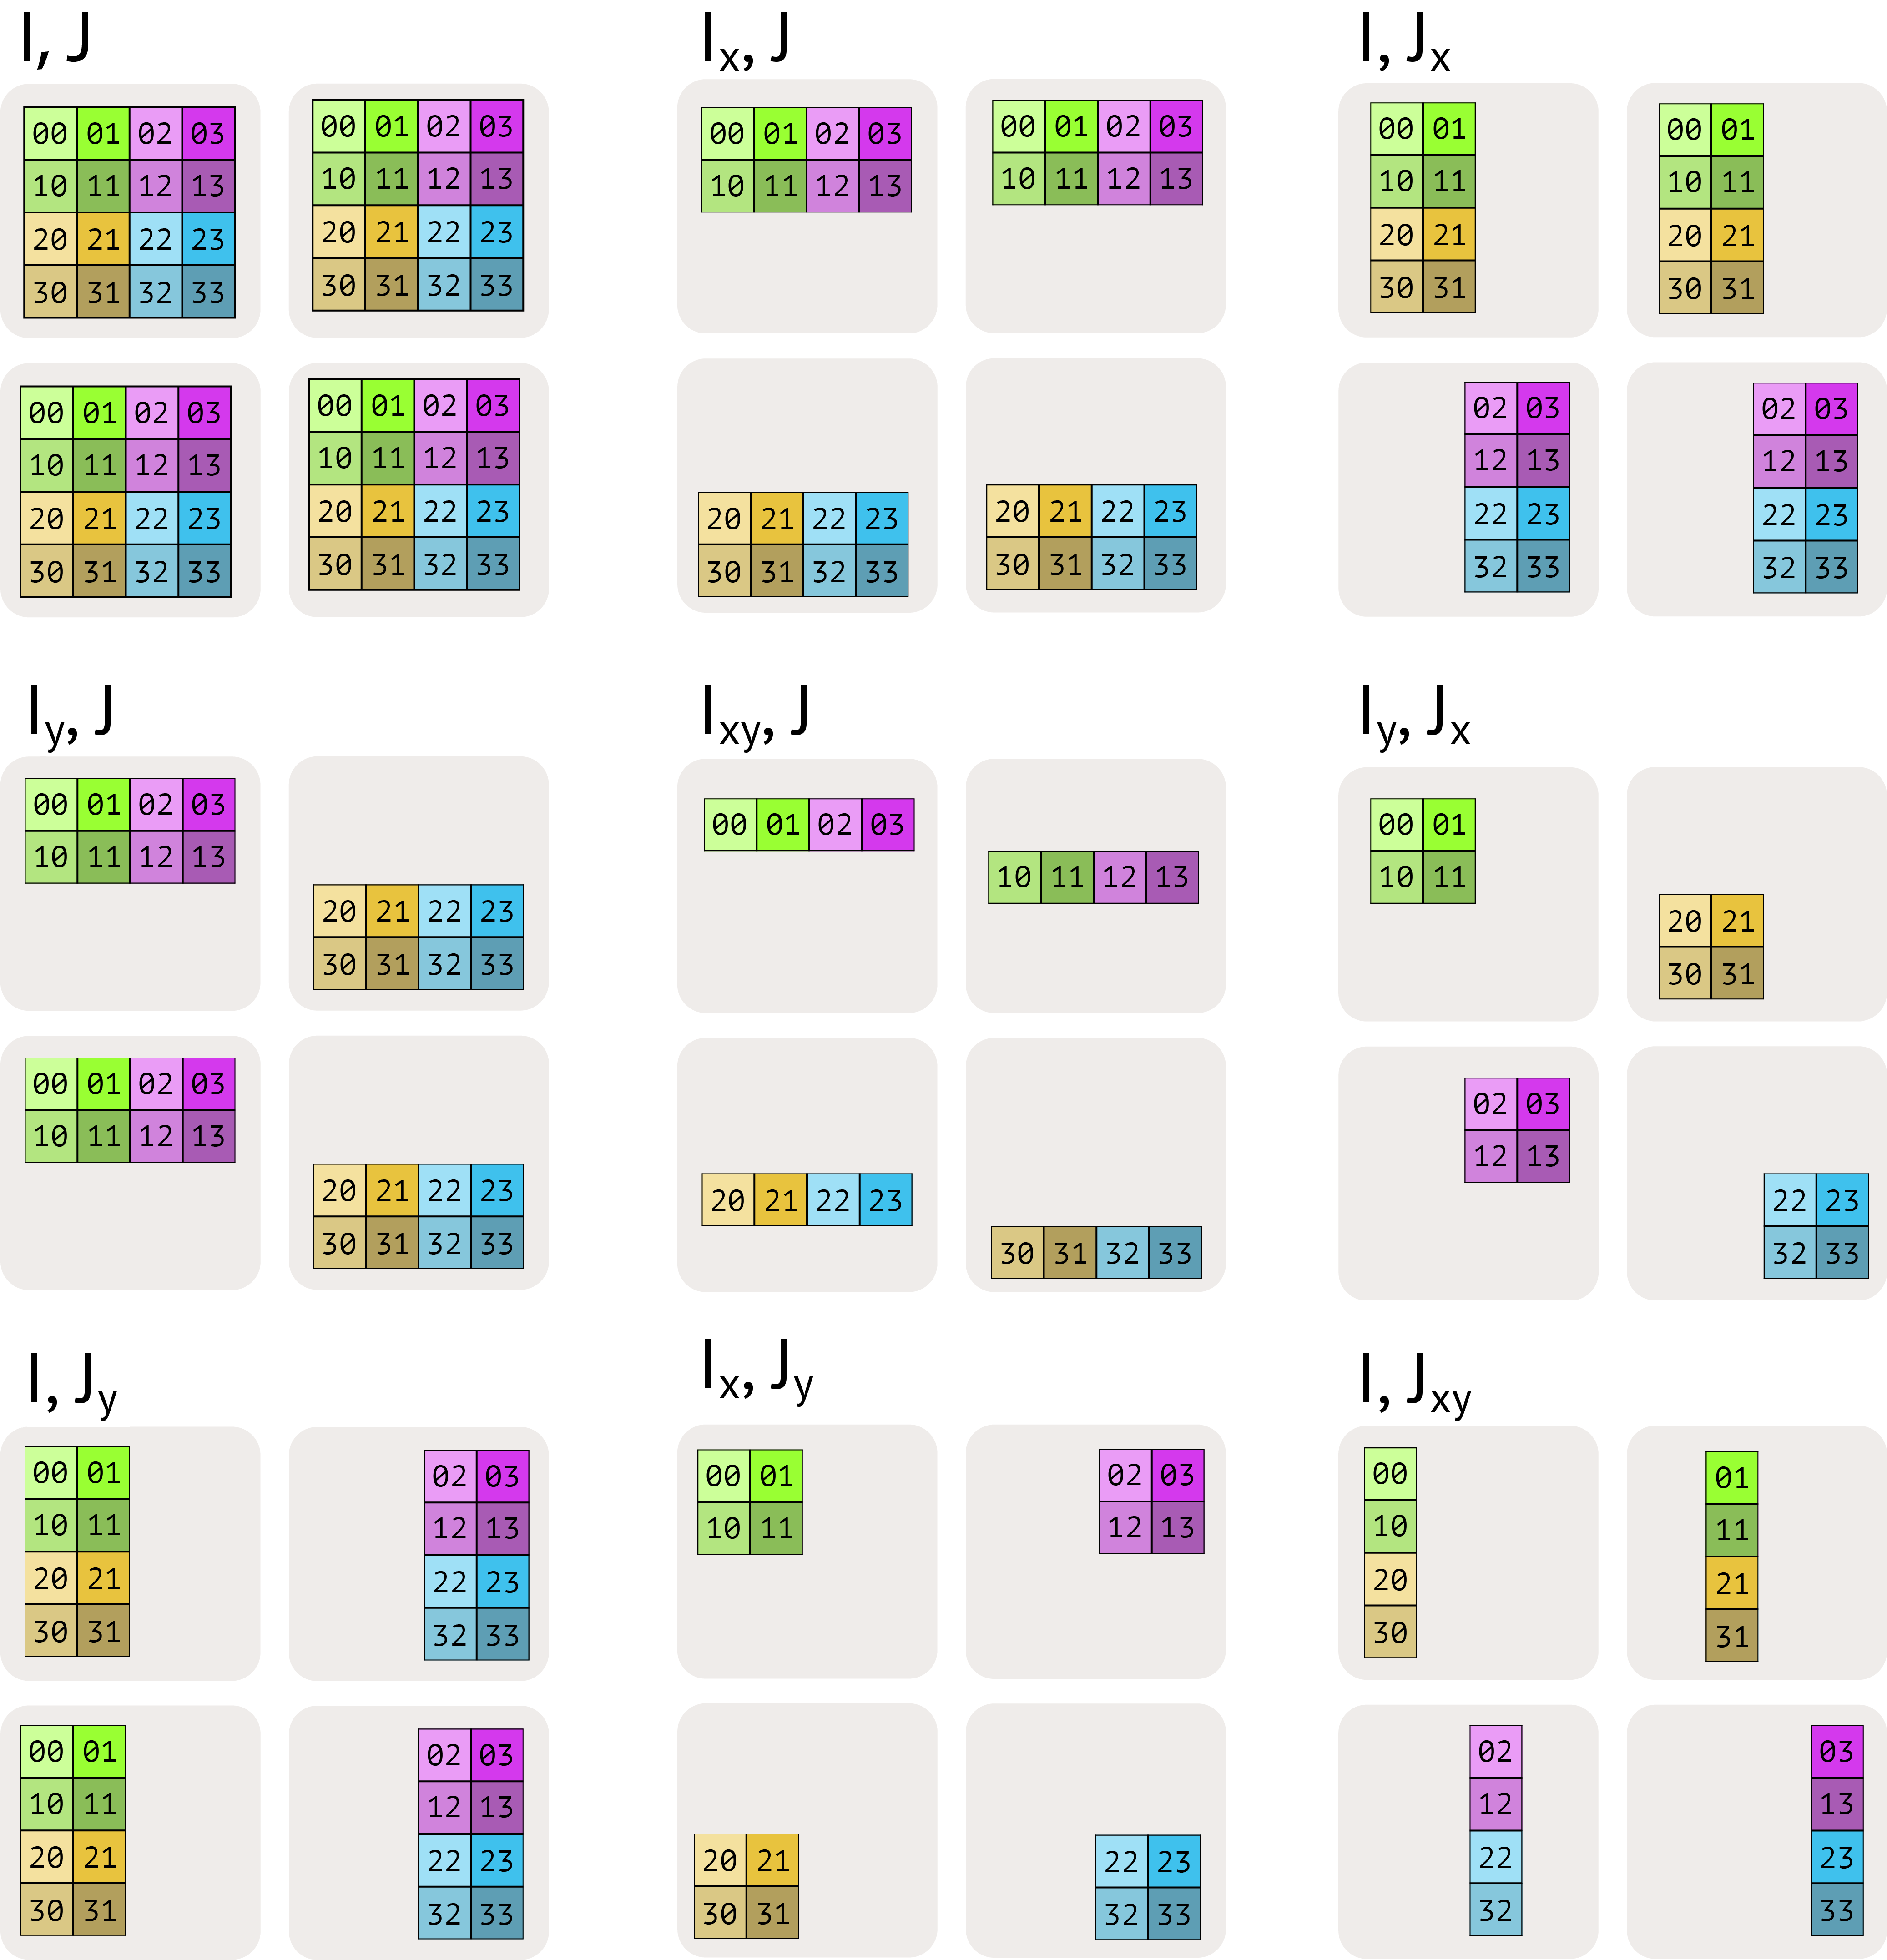
这里 $A[I_{XY}, J]$ 意味着我们将 X 和 Y 网格轴视为更大的扁平维度,并将 I 命名轴跨所有设备进行分区。多个网格轴下标的顺序很重要,因为它指定了网格上分区的遍历顺序。
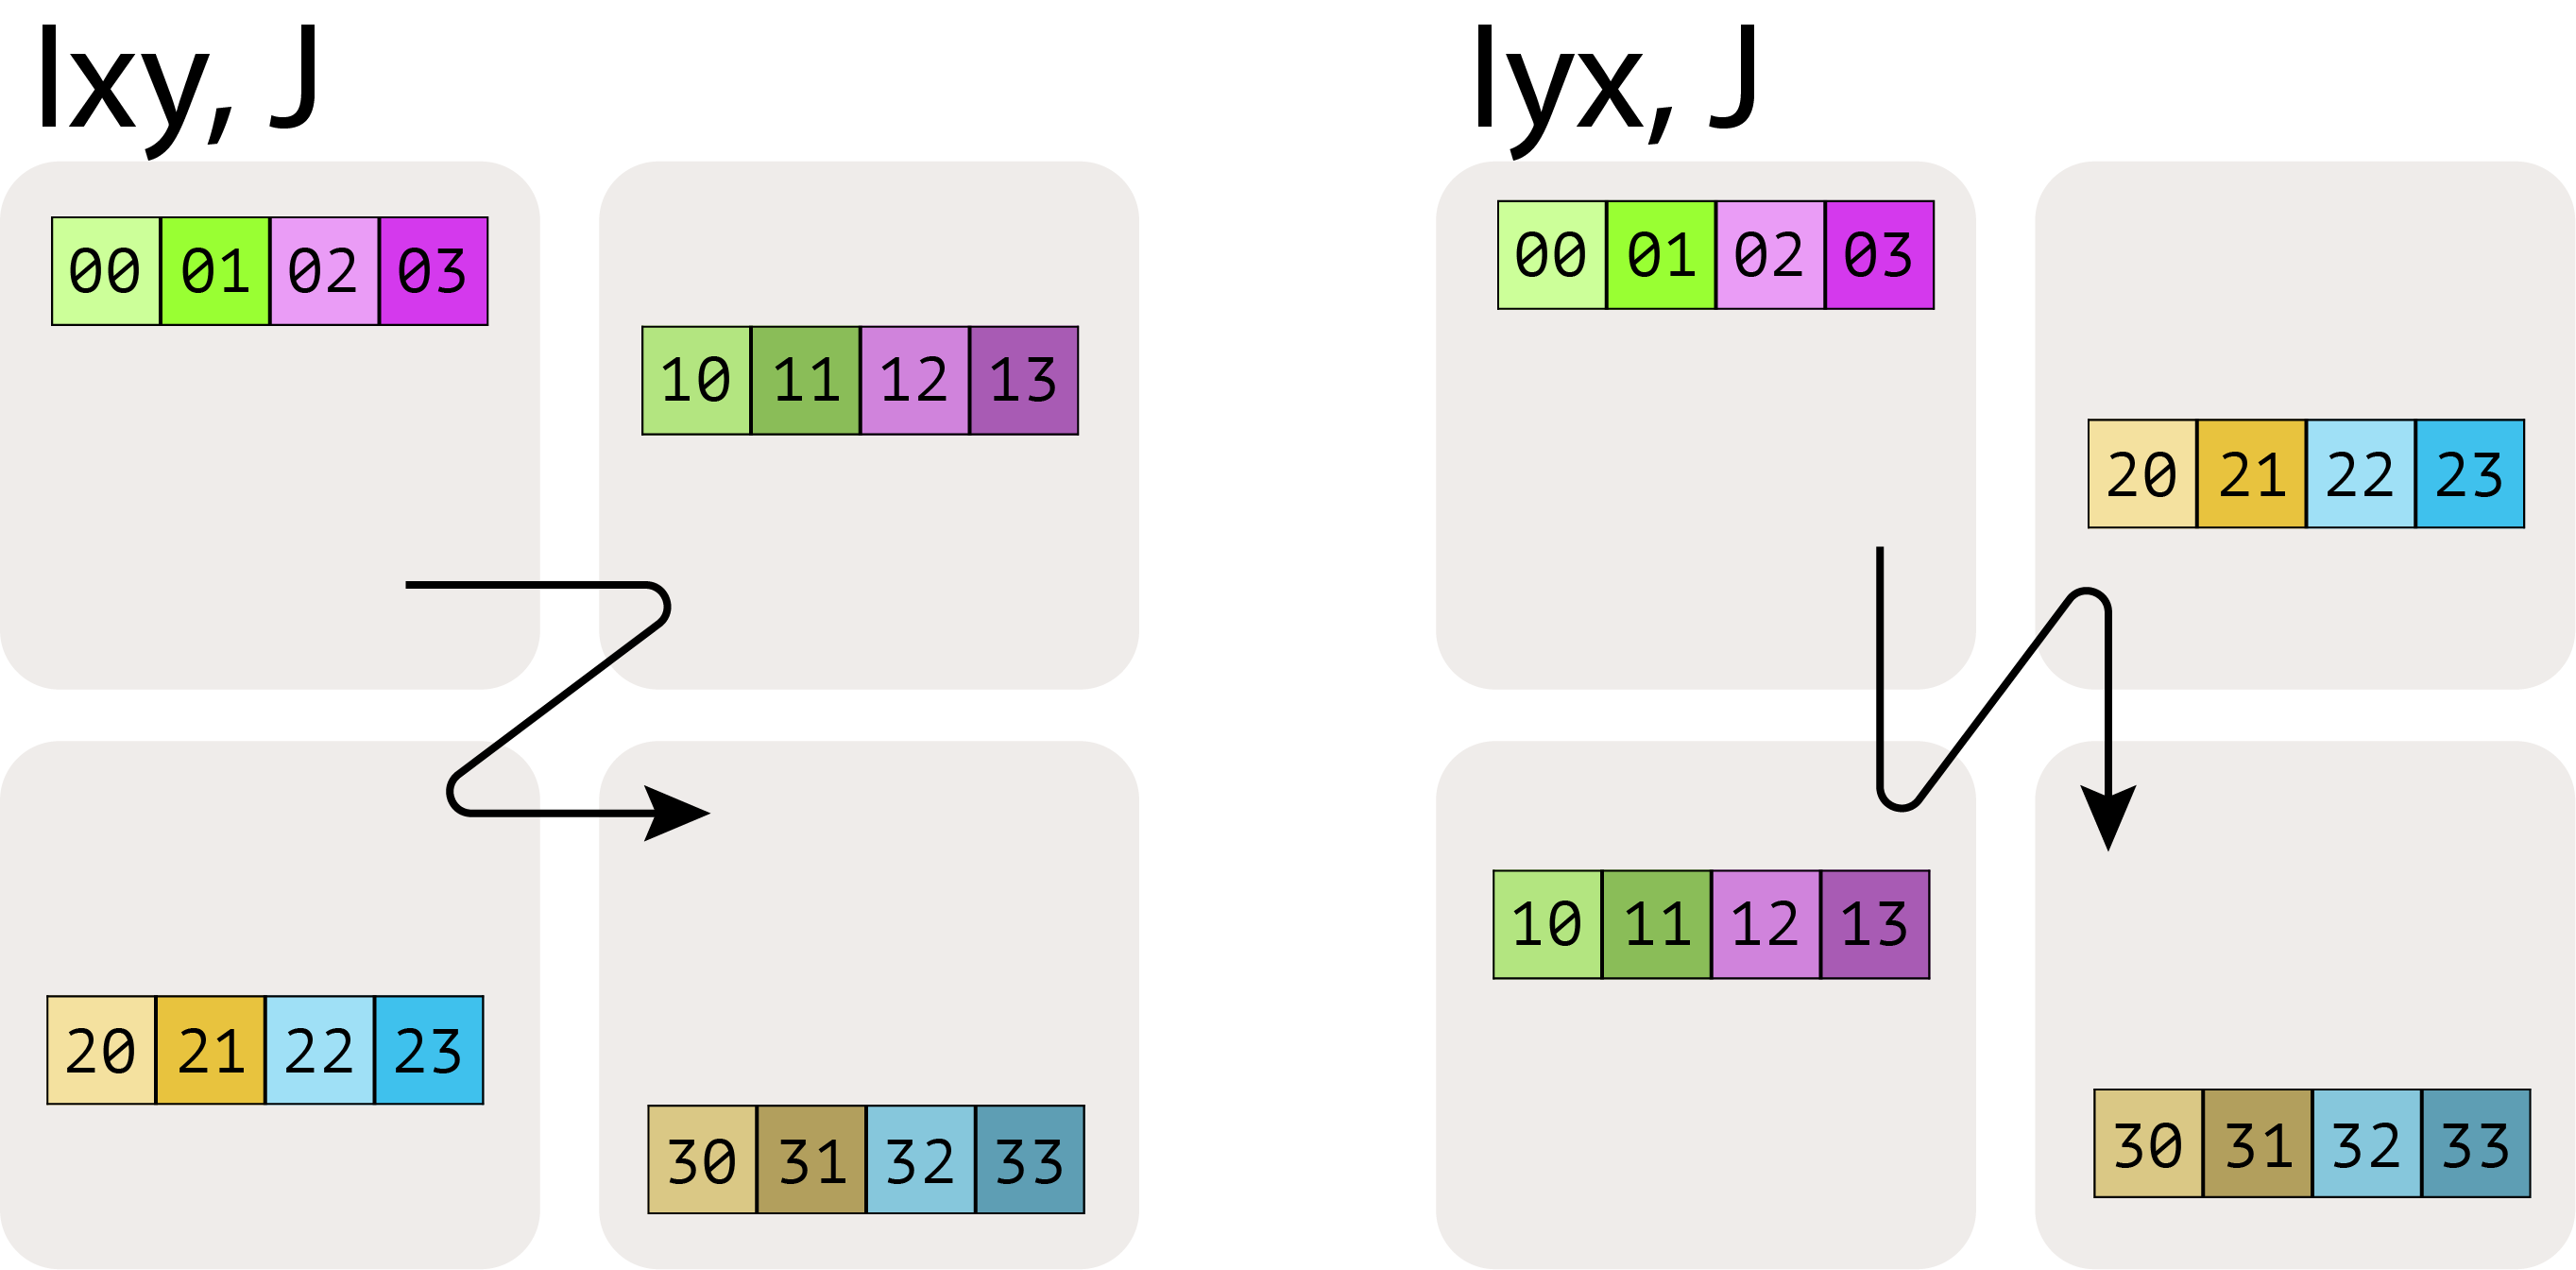
最后,请注意,我们不能沿着相同的网格维度分割多个命名轴。例如$A[I_X, J_X]$ 是一个无意义的、被禁止的分片。一旦网格维度被用来分割数组的一个维度,它在某种意义上就被“耗尽”了。
小测验: 令 A 为形状为 int8[128, 2048]、分片 $A[I_{XY}, J]$ 和网格 Mesh({'X': 2, 'Y': 8, 'Z': 2}) 的数组(总共 32 个设备)。每个设备 A 使用多少内存? A 在所有设备上使用了多少总内存?
答案:
答案: 我们的数组 A 在 X 和 Y 上进行分片,并在 Z 上进行复制,因此每个设备的形状为 int8[128 / (2 * 8), 2048] = int8[8, 2048],大小为 8 * 2048 = 16,384 字节。因为它是在 Z 上复制的,而在 Z 平面内它在 X 和 Y 上完全分片,所以有 2 个原始数组的完整副本(每个 Z 平面一个)。因此,所有设备的总大小为:原始数组大小 × Z 副本 = 128 * 2048 * 2 = 总计 512 KiB。或者,我们可以将其验证为:32 个设备 × 每个设备 16,384 字节 = 总共 512 KiB。
我们如何在代码中描述这一点?
到目前为止,我们一直避免谈论代码,但现在是先睹为快的好机会。 JAX 使用命名分片语法,该语法与我们上面描述的抽象语法非常匹配。我们将在第 10 节 中详细讨论这一点,但这里有一个快速预览。你可以在 Google Colab 此处 中使用它并分析结果以了解 JAX 如何处理不同的分片。这段代码做了三件事:
- 创建一个jax.Mesh,将我们的 8 个 TPU 映射到 4x2 网格中,并为两个轴分配名称“X”和“Y”。
- 创建矩阵 A 和 B,其中 A 沿其两个维度进行分片,B 沿输出维度进行分片。
- 编译并执行简单的矩阵乘法,返回分片数组。
import jax
import jax.numpy as jnp

# Create our mesh! We're running on a TPU v2-8 4x2 slice with names 'X' and 'Y'.
# The Auto axis type tells JAX to let the XLA compiler infer intermediate shardings.
assert len(jax.devices()) == 8
Auto = jax.sharding.AxisType.Auto
mesh = jax.make_mesh(axis_sizes=(4, 2), axis_names=('X', 'Y'), axis_types=(Auto, Auto))

# A little utility function to help define our sharding. A PartitionSpec is our
# sharding (a mapping from axes to names).
def P(*args):
  return jax.NamedSharding(mesh, jax.sharding.PartitionSpec(*args))

# We shard both A and B over the non-contracting dimension and A over the contracting dim.
A = jnp.zeros((8, 2048), dtype=jnp.bfloat16, device=P('X', 'Y'))
B = jnp.zeros((2048, 8192), dtype=jnp.bfloat16, device=P(None, 'Y'))

# We can perform a matmul on these sharded arrays! out_shardings tells us how we want
# the output to be sharded. JAX/XLA handles the rest of the sharding for us.
y = jax.jit(lambda A, B: jnp.einsum('BD,DF->BF', A, B), out_shardings=P('X', 'Y'))(A, B)
JAX 的一个很酷的事情是这些数组的行为就好像它们是未分片的一样! B.shape 将告诉我们全局或逻辑形状 (2048, 8192)。我们必须实际查看 B.addressable_shards 以了解它是如何本地分片的。我们可以对这些数组执行操作,JAX 将尝试找出如何广播或重塑它们来执行操作。例如,在上面的示例中,A 的局部形状是 [2, 1024],B 的局部形状是 [2048, 4096]。 JAX/XLA 将根据需要自动添加跨这些阵列的通信以执行最终的乘法。
使用分片数组进行计算
如果你有一组分布在许多设备上的数据,并希望对其执行数学运算,那么与分片数据和计算相关的开销是多少?
显然,这取决于所涉及的计算。
- 对于逐元素操作,在分布式数组上操作没有开销。
- 当我们希望跨驻留在许多设备上的元素执行操作时,事情会变得复杂。值得庆幸的是,对于大多数机器学习来说,几乎所有计算都以矩阵乘法的形式进行,并且分析起来相对简单。
本节的其余部分将讨论如何对分片矩阵进行乘法。初步估计,这涉及移动矩阵的块,以便你可以完全乘法或求和每个块。 每次分片都会涉及不同的通信。例如,$A[I_X, J] \cdot B[J, K_Y] \to C[I_X, K_Y]$ 可以在没有任何通信的情况下相乘,因为收缩维度(J,我们实际求和的维度)是未分片的。但是,如果我们希望输出未分片(即 $A[I_X, J] \cdot B[J, K_Y] \to C[I, K]$),我们需要将 $A$ 和 $B$ 或 $C$ 复制到每个设备(使用 AllGather)。这两种选择有不同的沟通成本,所以我们需要计算这个成本并选择最低的。
你可以将其视为“块矩阵乘法”。
为了理解这一点,回顾一下“块矩阵”或矩阵的嵌套矩阵的概念可能会有所帮助:
$$\begin{equation}
\begin{pmatrix}
a_{00} & a_{01} & a_{02} & a_{03} \
a_{10} & a_{11} & a_{12} & a_{13} \
a_{20} & a_{21} & a_{22} & a_{23} \
a_{30} & a_{31} & a_{32} & a_{33}
\end{pmatrix}
=
\left(
\begin{matrix}
\begin{bmatrix}
a_{00} & a_{01} \
a_{10} & a_{11}
\end{bmatrix} \
\begin{bmatrix}
a_{20} & a_{21} \
a_{30} & a_{31}
\end{bmatrix}
\end{matrix}
\begin{matrix}
\begin{bmatrix}
a_{02} & a_{03} \
a_{12} & a_{13}
\end{bmatrix} \
\begin{bmatrix}
a_{22} & a_{23} \
a_{32} & a_{33}
\end{bmatrix}
\end{matrix}
\right)
=
\begin{pmatrix}
\mathbf{A_{00}} & \mathbf{A_{01}} \
\mathbf{A_{10}} & \mathbf{A_{11}}
\end{pmatrix}
\end{equation}$$
矩阵乘法有一个很好的特性,即当矩阵被乘数以块形式编写时,乘积可以按照标准规则以块 matmuls 形式编写:
$$\begin{equation}
\begin{pmatrix}
A_{00} & A_{01} \
A_{10} & A_{11}
\end{pmatrix}
\cdot
\begin{pmatrix}
B_{00} & B_{01} \
B_{10} & B_{11}
\end{pmatrix}
=
\begin{pmatrix}
A_{00}B_{00} + A_{01}B_{10} & A_{00}B_{01} + A_{01}B_{11} \
A_{10}B_{00} + A_{11}B_{10} & A_{10}B_{01} + A_{11}B_{11}
\end{pmatrix}
\end{equation}$$
这意味着实现分布式矩阵乘法可以简化为通过网络移动这些分片块,对块执行“本地”矩阵乘法,并对它们的结果求和。 接下来的问题是要添加什么通信,以及它的成本有多高。
方便地,我们可以将所有可能的分片归结为我们需要考虑的大约 4 种情况,每种情况都有我们需要添加哪些通信的规则
- 情况 1: 两个输入都不会沿收缩维度进行分片。 我们可以在没有任何通信的情况下增加本地分片。
- 案例 2: 一个输入具有分片收缩维度。 我们通常沿着收缩维度“全部收集”分片输入。
- 案例 3: 两个输入都沿契约维度进行分片。 我们可以将本地分片相乘,然后“AllReduce”结果。
- 案例 4: 两个输入都有沿同一轴分片的非收缩维度。如果不先 AllGathering 两个输入之一,我们就无法继续。
你可以将这些视为只需要遵守的规则,但了解这些规则为何成立以及它们的成本有多高也很有价值。我们现在将详细介绍其中的每一项。
情况 1:被乘数都没有分片收缩维度
引理:当将分片矩阵相乘时,计算有效并且输出遵循输入的分片除非收缩维度被分片或两个矩阵沿同一轴分片。例如,这工作正常
$$\begin{equation*}
\mathbf{A}[I_X, J] \cdot \mathbf{B}[J, K_Y] \rightarrow \mathbf{C}[I_X, K_Y]
\end{equation*}$$
没有任何通信,并导致张量在 X 和 Y 硬件维度上分片。尝试思考这是为什么。基本上,计算与分片“独立”,因为每个批次条目都有一些正在收缩的轴的本地块,可以进行乘法和减少。这些情况中的任何一个都可以正常工作并遵循以下规则:
$$\begin{align*}
\mathbf{A}[I, J] \cdot \mathbf{B}[J, K] \rightarrow &\ \mathbf{C}[I, K] \
\mathbf{A}[I_X, J] \cdot \mathbf{B}[J, K] \rightarrow &\ \mathbf{C}[I_X, K]\
\mathbf{A}[I, J] \cdot \mathbf{B}[J, K_Y] \rightarrow &\ \mathbf{C}[I, K_Y]\
\mathbf{A}[I_X, J] \cdot \mathbf{B}[J, K_Y] \rightarrow &\ \mathbf{C}[I_X, K_Y]
\end{align*}$$
因为A和B都没有分片收缩维度J,所以我们可以简单地执行输入的局部块矩阵乘法,并且结果将已经根据所需的输出分片进行分片。当两个被乘数具有沿同一轴分片的非收缩维度时,情况不再如此(有关详细信息,请参阅无效分片 部分)。
情况 2:一个被乘数具有分片收缩维度
让我们考虑一下当一个输入 A 沿着收缩 J 维度进行分片并且 B 被完全复制时该怎么办:
$$\mathbf{A}[I, J_X] \cdot \mathbf{B}[J, K] \rightarrow \mathbf{C}[I, K]$$
我们不能简单地将 A 和 B 的局部块相乘,因为我们需要对 A 的整个收缩维度求和,该维度在 X 轴上分割。通常,我们首先“AllGather”A的分片,这样每个设备都有一个完整的副本,然后才与 B: 相乘
$$\textbf{AllGather}_X[I, J_X] \rightarrow \mathbf{A}[I, J]$$
$$\mathbf{A}[I, J] \cdot \mathbf{B}[J, K] \rightarrow \mathbf{C}[I, K]$$
这样,实际的乘法就可以在每个设备上完全完成。
要点: 当将其中一个矩阵沿收缩维度分片的矩阵相乘时,我们通常首先对其进行 AllGather,以便收缩不再分片,然后进行局部 matmul。
请注意,当 B 也没有沿 X 分片时,我们还可以进行局部部分 matmul,然后对分片部分和求和(或 AllReduce),这让我们可以对计算进行分片,但通常具有更高的通信成本。在某些情况下这可能会更快,尽管实际上 B 通常会被分片。当这更好时,问题 4 下面 就可以解决。
什么是 AllGather? AllGather 是我们将讨论的第一个核心 MPI 通信原语。 AllGather 沿轴删除分片,并将分布在设备上的分片重新组装到沿该轴的每个设备上。使用上面的符号,AllGather 从一组轴中删除下标,例如
$$\textbf{AllGather}{XY}(A[I{XY}, J]) \rightarrow A[I, J]$$
我们不必删除给定维度的所有下标,例如$$A[I_{XY}, J] \rightarrow A[I_Y, J]$$ 也是一个 AllGather,只是仅在一个轴上。另请注意,我们可能还希望使用 AllGather 来删除非收缩维度分片,例如在矩阵乘法中:
$$A[I_X, J] \cdot B[J, K] \rightarrow C[I, K]$$
我们可以首先 AllGather A 来删除输入分片,或者我们可以进行分片 matmul,然后 AllGather 结果 C。
AllGather 实际上是如何执行的? 为了围绕单个 TPU 轴(一个环)执行一维 AllGather,我们基本上让每个 TPU 围绕一个环传递其分片,直到每个设备都有一个副本。(原注:GPU AllGather 也可以像这样工作,你在节点中的 GPU 中创建一个环,并以该(任意)顺序传递块。)这是一个动画:
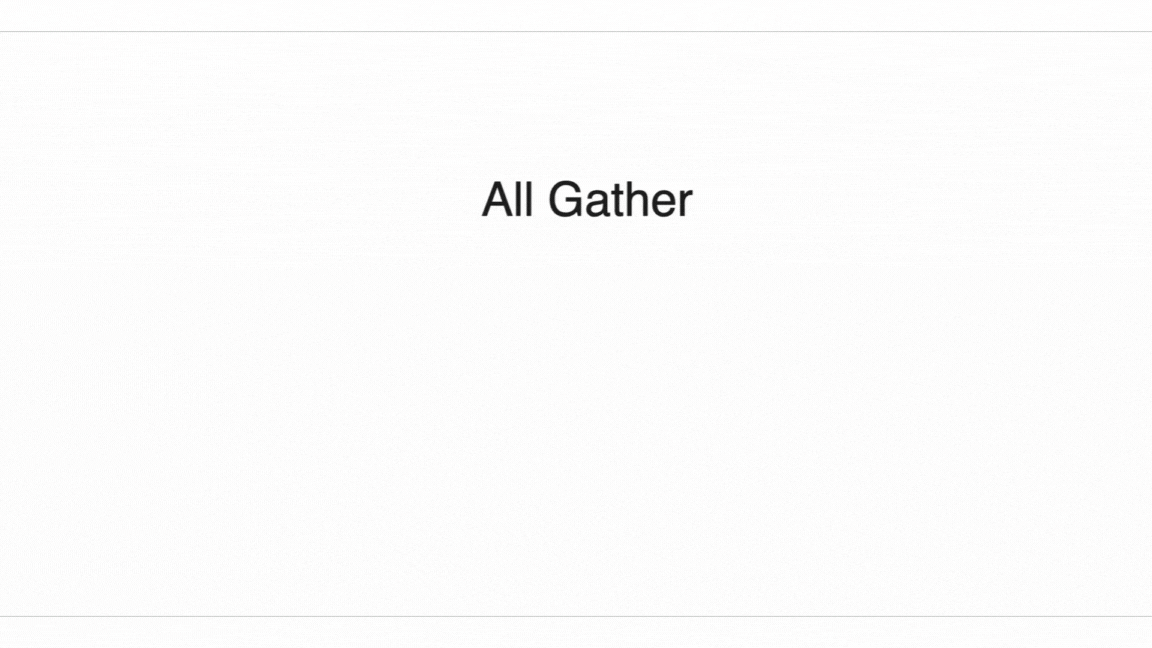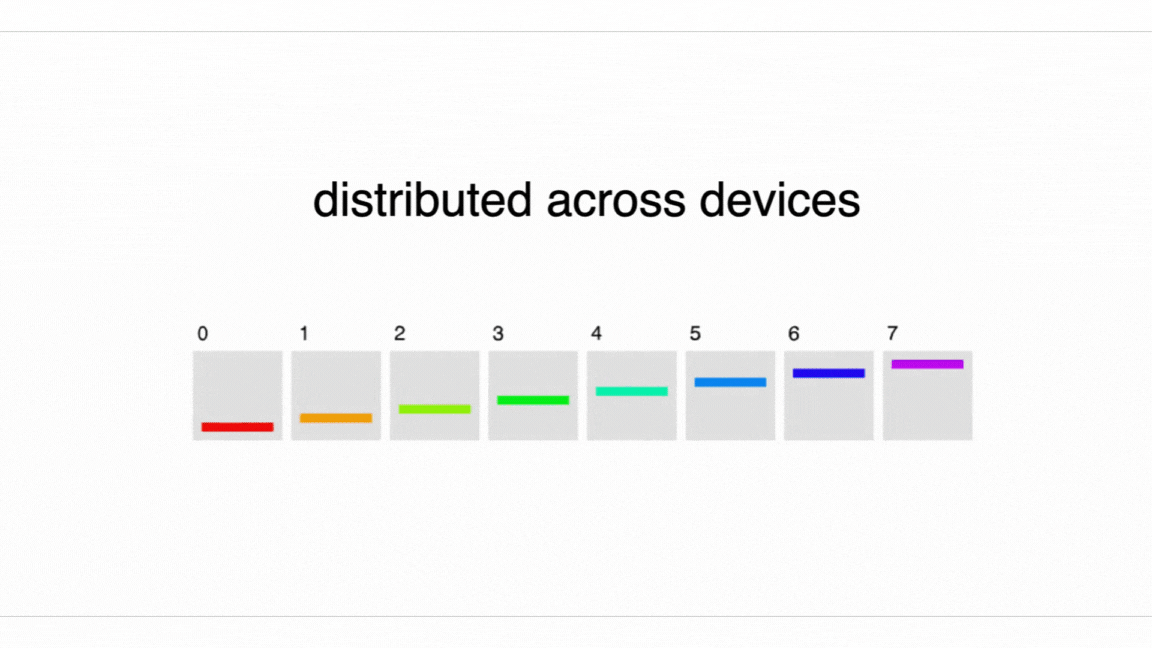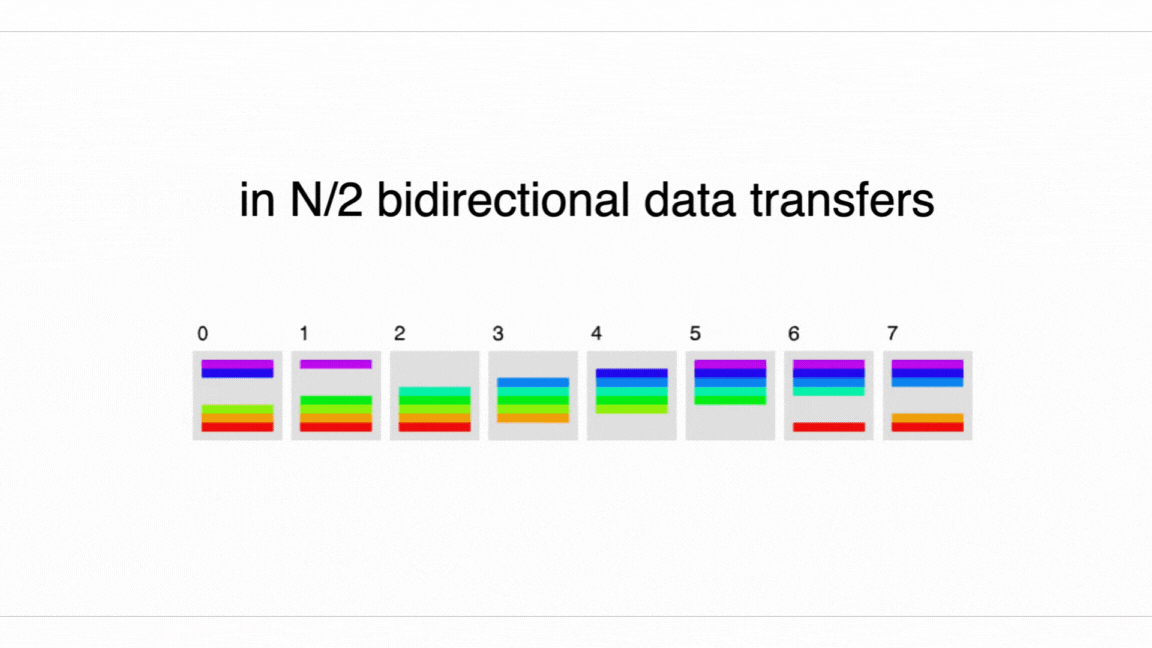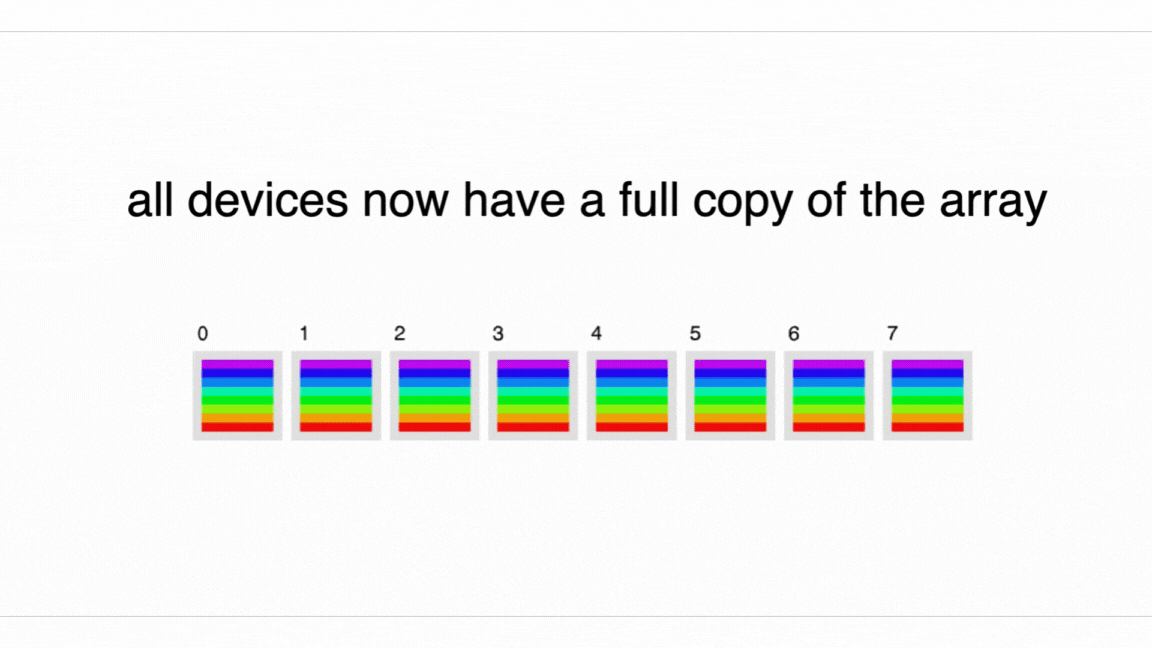
图: 动画展示如何围绕一组 8 个 TPU 或 GPU 设备执行 AllGather。每个设备从数组的八分之一开始,以完整副本结束。
我们可以在一个方向或两个方向上进行 AllGather(上面显示了两个方向)。如果我们做一个方向,每个 TPU 都会通过环上的 $N - 1$ 跳发送大小为 $\text{bytes} / N$ 的块。如果我们做两个方向,我们就有大小为 $2 \cdot \text{bytes} / N$ 的 $\lfloor \frac{N}{2} \rfloor$ 跳。
这需要多长时间? 让我们以双向 AllGather 为例,计算一下需要多长时间。令 $$V$$ 为数组中的字节数,$X$ 为收缩维度上的分片数量。那么从上图来看,每一跳在每个方向上发送$V / \lvert X\rvert$字节,所以每一跳需要
$$T_{hop} = \frac{2 \cdot V}{\lvert X \rvert \cdot W_\text{ici}}$$
其中 $W_\text{ici}$ 是双向 ICI 带宽。(原注:分子中的因子 2 来自我们使用双向带宽的事实。我们在每个方向发送 $V / X$,或者总共 $2V / X$。)我们总共需要发送 $\lvert X\rvert / 2$ 跳才能到达每个 TPU(原注:从技术上讲,$\lfloor X / 2 \rfloor$),因此总共减少了
$$T_{total} = \frac{2 \cdot V \cdot X}{2 \cdot X \cdot W_\text{ici}}$$
$$T_{total} = \frac{V}{W_\text{ici}}$$
请注意,这不依赖于 $X$! 这有点令人震惊,因为这意味着即使我们的 TPU 仅本地连接,连接的位置并不重要。我们只是受到每个链接速度的瓶颈。
要点: 在吞吐量受限的情况下执行 AllGather(或 ReduceScatter 或 AllReduce)时,实际通信时间仅取决于阵列的大小和可用带宽,而不取决于阵列分片的设备数量!
关于 ICI 延迟的说明: ICI 链路上的每一跳都有一些固有开销,无论数据量如何。这通常约为 1us。这意味着当我们的数组 $$A$$ 非常小并且每一跳花费的时间少于 1us 时,我们可以进入“延迟限制”状态,其中计算_确实_取决于 $X$。
欲了解完整详情,请点击此处。
设 $$T_\text{min}$$ 为单跳的最短时间。然后
$$T_{hop} = \max \left[ T_{min}, \frac{2 \cdot V}{X \cdot W_\text{ici}} \right]$$
$$T_{total} = \max \left[ \frac{T_{min} \cdot X}{2}, \frac{V}{W_\text{ici}} \right]$$
因为我们执行了 $X / 2$ 跳。对于大量减少或收集,我们受到带宽的严格限制。我们发送的数据如此之多,以至于每一跳的开销基本上可以忽略不计。但对于小型阵列(例如,从模型采样时),这一点不可忽略,并且 ICI 带宽不相关。我们纯粹受到延迟的束缚。另一种表达方式是给定特定的 TPU,例如TPU v5e 具有 4.5e10 单向 ICI 带宽,在 4.5e10 * 1e-6 = 45kB 下发送任何缓冲区都将受到延迟限制。
以下是 TPU v5e 8x16 切片上 AllGather 带宽的经验测量。该阵列在 16 轴上进行分片,因此它具有完整的双向环。
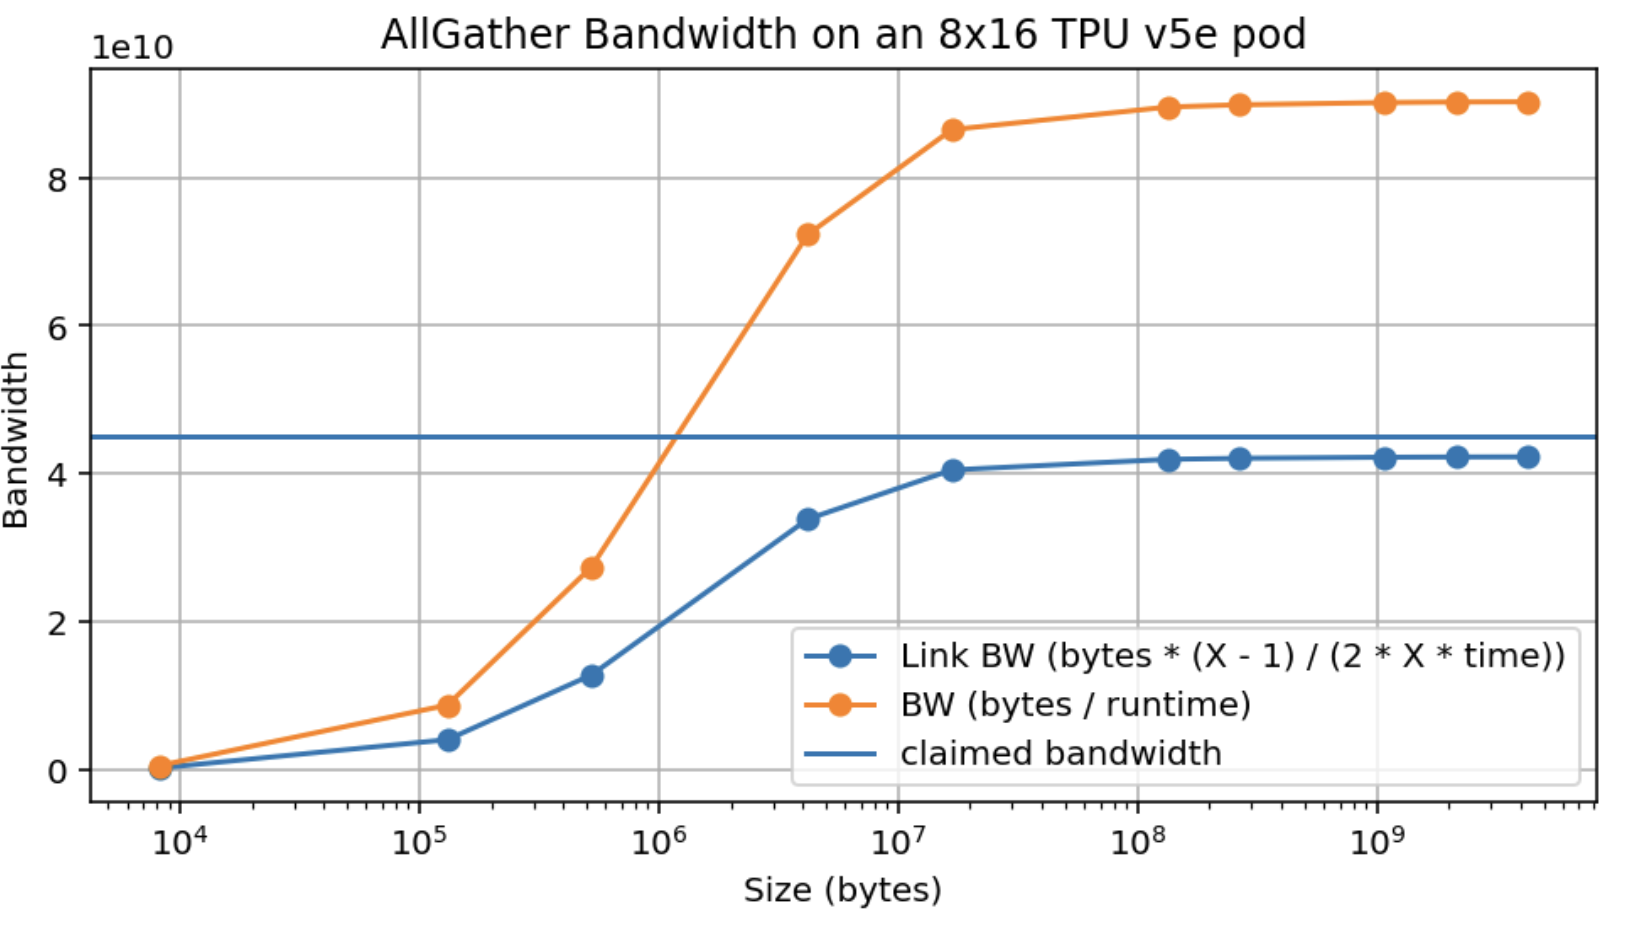
图: AllGather 期间 TPU v5e 的经验带宽和估计链路带宽。橙色的 BW 是 AllGathered 每秒的实际字节数,而蓝色曲线显示根据集体的已知成本计算的经验单向链路带宽。
请注意,我们不仅实现了约 95% 的峰值声称带宽 (4.5e10),而且还以约 10MB 实现了这一峰值,当 16 路分片时,每个设备约为 625kB(旁白:这比 GPU 好得多)。
当我们在多个轴上进行 AllGather 时会发生什么? 当我们在多个轴上进行收集时,我们有多个 ICI 维度来执行收集。例如,AllGatherXY([B, DXY]) 在两个硬件网格轴上运行。这使可用带宽增加了 $N_\text{axes}$ 倍。
在考虑延迟时,我们最终得出一般规则:
$$T_{total} = \max \left[ \frac{T_{min} \cdot \sum_{i} |X_i|}{2}, \frac{V}{W_\text{ici} \cdot N_\text{axes}} \right]$$
其中 $$\sum_i \lvert X_i \rvert / 2$$ 是 TPU 网格中最长路径的长度。
小测验 2 [全部收集时间]: 使用第 2 部分 中的数字,执行以下操作需要多长时间AllGatherY([EY, F]) → [E, F] 在 TPU v5e 上,具有 2D 网格 {'X': 8, 'Y': 4}、$$E = 2048$$、$$F = 8192$$ bfloat16? $$E=256, F=256$$ 怎么样?
答案:
答案: 让我们从计算一些基本量开始:
- TPU v5e 的 2 个轴均具有 4.5e10 字节/秒的单向 ICI 带宽。
- 在 (a) 的 bfloat16 中,我们有 $A[E_Y, F]$,因此每个设备都保存一个形状为 bf16[512, 8192] 的数组,其大小为 512 * 8192 * 2 = 8.4MB。总数组大小为 2048 * 8192 * 2 = 34MB。
对于第(1)问,可以使用上面的公式。由于 AllGather 沿一条轴进行,有 $T_{\text{comms}} = \text{34e6} / \text{9e10} = \text{377us}$。还要检查是否受延迟限制:大小为 4 的轴最多经过 3 跳,对应延迟下限约 3us,远小于估算时间。不过,TPU v5e 只有轴长为 16 时才有首尾环绕连接,因此这里实际上无法执行完整的双向 AllGather。数据从一端传到另一端需要经过 3 跳,理论耗时应更接近 $T_{\text{comms}} = 3 * \text{8.4e6} / \text{4.5e10} = 560\mu s$。这里的实际性能记录来自这个 Colab,显示耗时 $680 \mu s$。考虑到实际带宽往往达不到理论值的 100%,这是合理的。对于第(2)问,每个分片只有 64 * 256 * 2 = 32kB. 32e3 / 4.5e10 = 0.7us,因此受延迟限制。3 跳大约需要 3 × 1us = 3us,实测更接近 8us。
注意:当我们有像 {'X': 16, 'Y': 4} 这样的 2D 网格时,每个轴不必对应于特定的_硬件_轴。这意味着例如上面可以描述一个 4x4x4 TPU v5p 立方体,在 $X$ 轴上有 2 个轴。当我们稍后描述多轴上的数据并行性时,这将发挥作用。
情况 3:两个被乘数都有分片收缩维度
第三种基本情况是两个被乘数在其收缩维度上沿着相同的网格轴进行分片:
$$\textbf{A}[I, J_X] \cdot \textbf{B}[J_X, K] \rightarrow C[I, K]$$
在这种情况下,本地分片块矩阵乘法至少可能执行,因为它们将共享相同的收缩索引集。但每个产品仅代表完整所需产品的“部分总和”,并且沿着X维度的每个设备将留下该最终所需产品的不同“部分总和”。 这种情况非常常见,因此我们扩展了符号来明确标记这种情况:
$$\textbf{A}[I, J_X] \cdot_\text{LOCAL} \textbf{B}[J_X, K] \rightarrow C[I, K] {\ U_X }$$
记号 { UX } 表示“沿 X 设备网格轴尚未归约”。也就是说,当前运算还没有完全结束,需要最后再求一次和。$\cdot_\text{LOCAL}$ 表示只完成设备内的局部求和,跨设备的结果仍未归约。
这可以看作是关于矩阵乘法和外积的以下结果:
$$A \cdot B = \sum_{i=1}^{P} \underbrace{A_{:,i} \otimes B_{i,:}}_{\in \mathbb{R}^{n \times m}}$$
其中 ⊗ 是外积。因此,如果X轴上的TPUi具有A的第i列和B的第i行,我们可以进行局部矩阵乘法以获得$$A_{:,i} \otimes B_{i,:} \in \mathbb{R}_{n\times m}$$。该矩阵在每个条目中具有 A • B 在该条目处的总和的第 i 项。我们仍然需要对P(我们在网格轴X上进行分片)执行求和,以获得完整的A • B。如果我们按块(即分片)写入 A 和 B,然后对结果的每个结果分片求和,则效果相同。
我们可以使用跨 X 轴的完整 AllReduce 来执行此求和来解决此问题:
$$\begin{align*}
A[I, J_X] \cdot_\text{LOCAL} B[J_X, K] \rightarrow &\ C[I, K] { U_X } \
\textbf{AllReduce}_X C[I, K] { U_X } \rightarrow &\ C[I, K]
\end{align*}$$
AllReduce 删除部分求和,导致沿轴的每个设备具有相同的完全求和值。 AllReduce 是我们将在本节中讨论的几个关键通信中的第二个,第一个是 AllGather,其他是 ReduceScatter 和 AllToAll。 AllReduce 采用具有未缩减(部分求和)轴的数组,并通过围绕未缩减轴传递这些分片并累加结果来执行求和。签名是
$$\textbf{AllReduce}_Y A[I_X, J] {U_Y} \rightarrow A[I_X, J]$$
这意味着它只是删除 $\{U_Y\}$ 后缀,但结果保持不变。
AllReduce 有多昂贵? AllReduce 如何执行的一种思维模型是每个设备将其分片发送给其邻居,并对它接收到的所有分片进行求和。显然,这比 AllGather 更昂贵,因为每个“分片”都具有与完整数组相同的形状。一般来说,AllReduce 的成本是 AllGather 的两倍。 看到这一点的一种方法是注意 AllReduce 可以表示为其他两个原语的组合:ReduceScatter 和 AllGather。与 AllReduce 类似,ReduceScatter 解析数组上的部分和,但会导致输出“分散”或沿给定维度分区。 AllGather 收集所有这些片段,并沿着该物理轴“取消分区/取消分片/复制”逻辑轴。
$$\begin{align*}
\textbf{ReduceScatter}_{Y,J} : A[I_X,J] {U_Y} \rightarrow &\ A[I_X, J_Y] \
\textbf{AllGather}_Y : A[I_X, J_Y] \rightarrow &\ A[I_X, J]
\end{align*}$$
ReduceScatter 怎么样? 正如 AllGather 重新组装分片数组(删除下标)一样,ReduceScatter 对未缩减/部分求和的数组求和,然后沿同一网格轴分散(分片)不同的逻辑轴。 $X[F]\{U_Y\} \to X[F_Y]$。动画显示了这是如何完成的:请注意,它与 AllGather 非常相似,但我们不是保留每个分片,而是将它们加在一起。因此,它的延迟大致相同,不包括执行归约所需的时间。
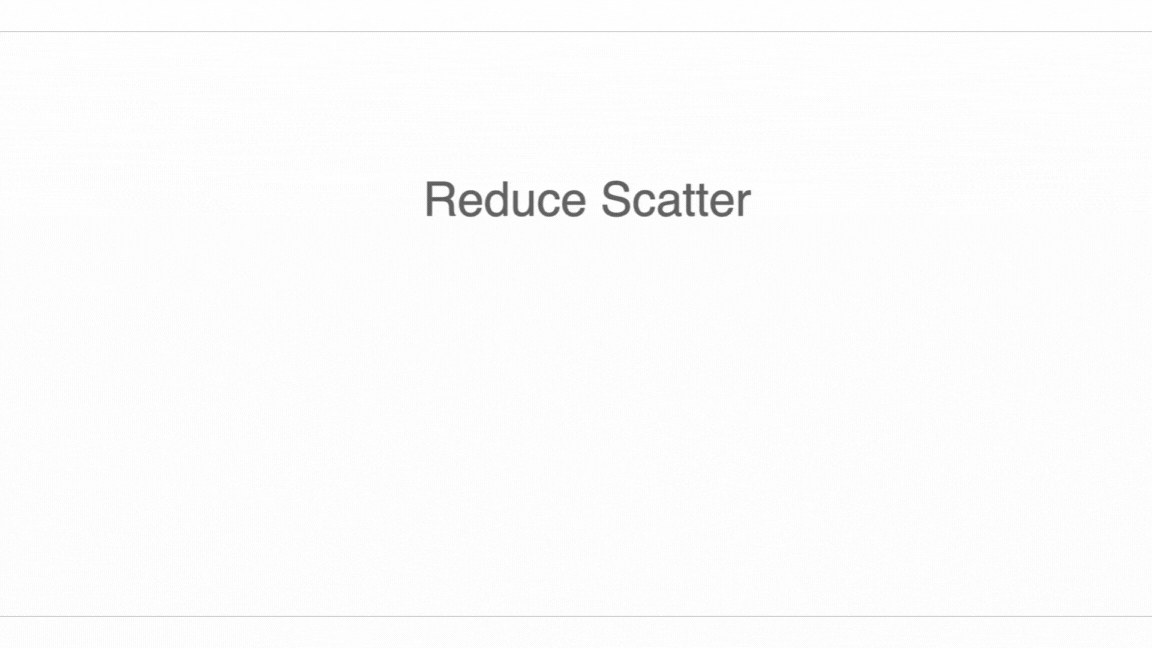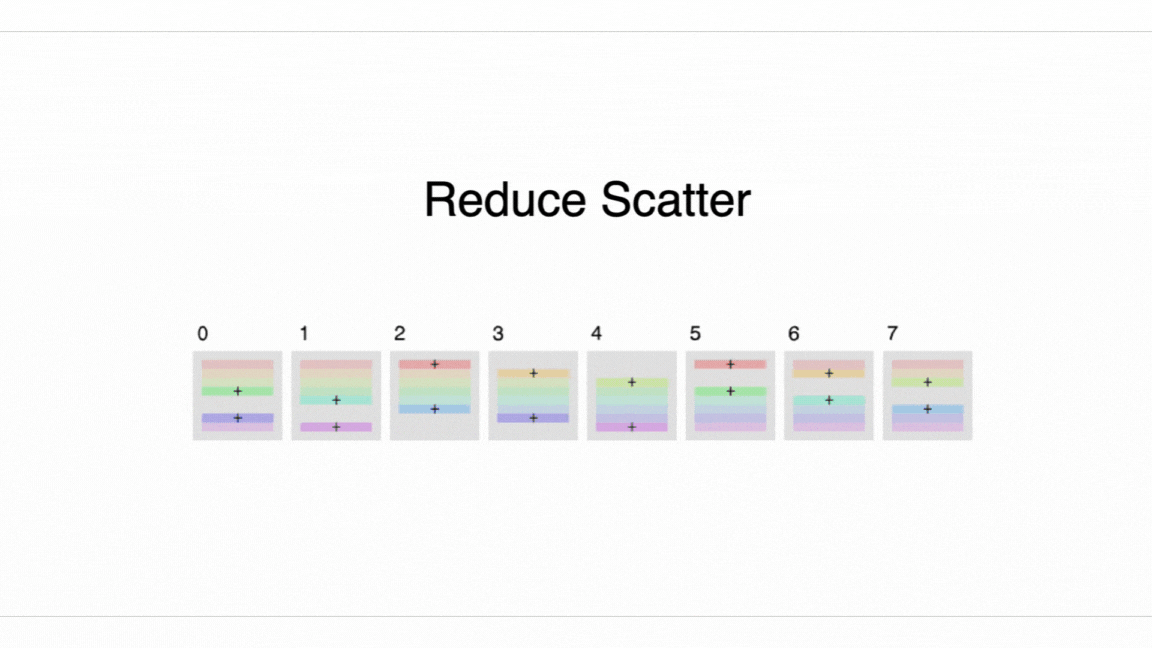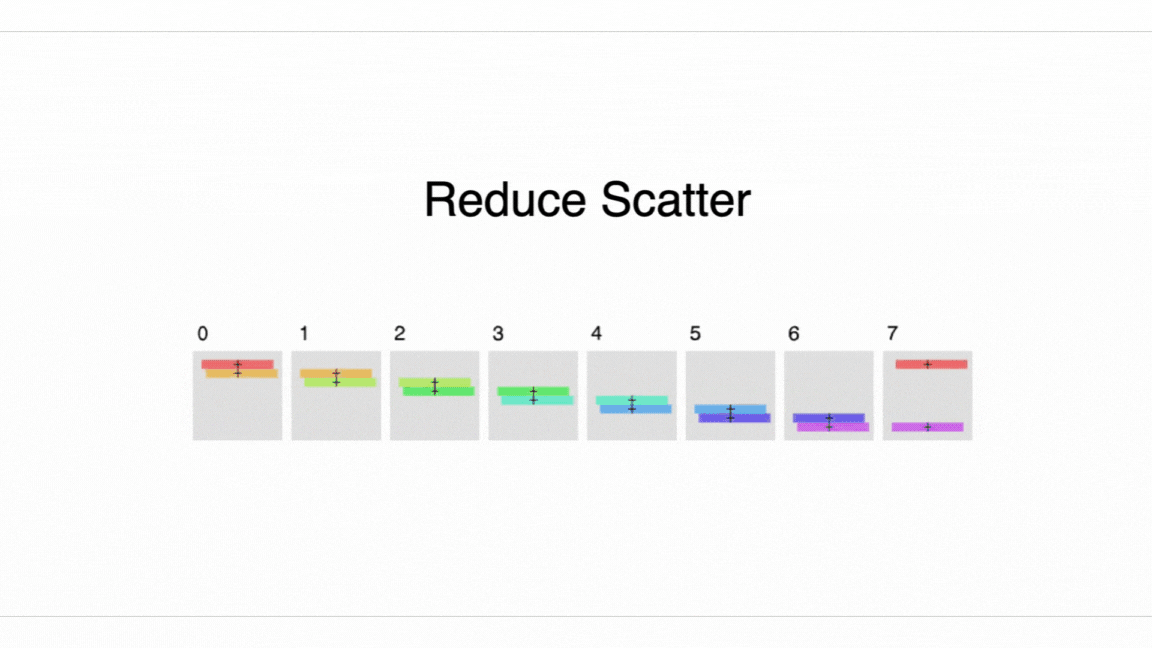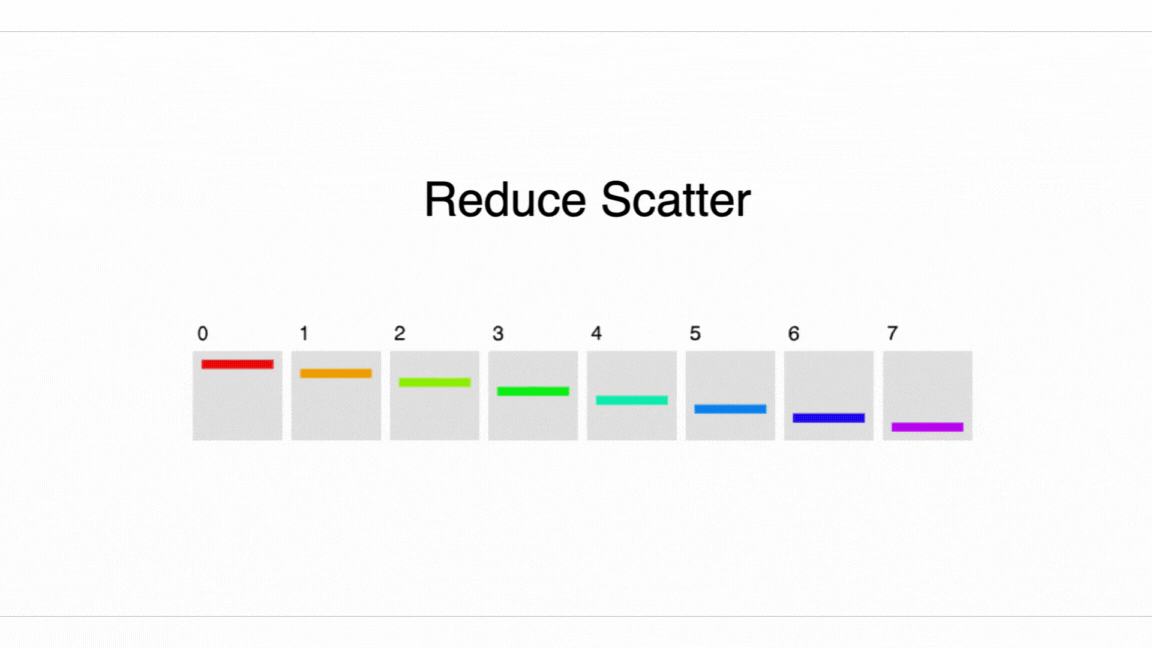
每跳的通信时间就是每个分片字节 $V / Y$ 除以带宽 $W_\text{ici}$,就像 AllGather 一样,所以我们有
$$T_{\text{comms per AllGather or ReduceScatter}} = \frac{V}{W_\text{ici}}$$
$$T_{\text{comms per AllReduce}} = 2 \cdot \frac{V}{W_\text{ici}}$$
其中$$W_\text{ici}$$是双向带宽,只要我们有一个完整的环就可以减少过来。
情况 4:两个被乘数都有沿同一轴分片的非收缩维度
对张量进行分片时,每个网格维度最多可以出现一次。执行上述规则有时会导致违反此规则的情况,例如:
$$A[I_X, J] \cdot B[J, K_X] \rightarrow C[I_X, K_X]$$
这是无效的,因为给定的分片,例如 i,沿维度 X,将具有 C 的 (i, i) 个分片,即对角线条目。那么,所有分片之间没有足够的信息来恢复除结果的对角线条目之外的任何内容,因此我们不能允许这种分片。
解决这个问题的方法是 AllGather 一些维度。这里我们有两个选择:
$$\begin{align*}
\textbf{AllGather}_X A[I_X, J] \rightarrow &\ A[I, J] \
A[I, J] \cdot B[J, K_X] \rightarrow &\ C[I, K_X]
\end{align*}$$
或者
$$\begin{align*}
\textbf{AllGather}_X B[J, K_X] \rightarrow &\ B[J, K] \
A[I_X, J] \cdot B[J, K] \rightarrow &\ C[I_X, K]
\end{align*}$$
无论哪种情况,结果只会在其形状中提及 X 一次。我们选择哪一个将基于以下操作需要的分片。
深入探讨 TPU 通信原语
前面的4个案例已经介绍了几个用于执行分片矩阵乘法的“核心通信原语”:
- AllGather:从分片中删除下标,收集分片。
- ReduceScatter: 通过对该轴上的分片求和,从数组中删除“未缩减”后缀,使数组在第二个轴上分片。
- AllReduce: 删除“未缩减”后缀,使数组沿该轴未分片。
在混合专家 (MoE) 模型和其他计算的情况下,还需要提及一个核心通信原语:AllToAll。
我们最后的通信原语:AllToAll
最后一个基本集体在考虑分片矩阵乘法时不会自然出现,但在实践中不断出现,它是 AllToAll 集体,或更准确地说是分片转置或重新分片操作的特殊情况。例如
$$\textbf{AllToAll}_{X, J} A[I_X, J] \rightarrow A[I, J_X]$$
AllToAll 通常需要在不具有兼容布局方案的分片计算的不同区域之间重新排列分片布局。当考虑分片混合专家模型时,它们自然会出现。 你可以将 AllToAll 视为将下标从一个轴移动到另一个轴。因为 all to all 不需要复制环上每个分片的所有数据,所以它实际上比 AllGather 便宜(1/4 倍)(原注:对于偶数大小的双向环,每个设备将向右发送 $(N/2 + (N/2-1) + … + 1)$ 块,向左发送 $((N/2-1) + … + 1)$ 块 $= 0.5 \cdot (N / 2) \cdot (N/2 + 1) + 0.5 \cdot (N / 2) \cdot (N/2 - 1) = N^2/4$。每个块(也称为分片的分片)的大小为 $\text{bytes} / N^2$,因此每台设备的成本为 $(\text{bytes} / N^2) \cdot N^2 / 4 = \text{bytes} / 4$。此结果在所有设备上扩展,因为总带宽随设备数量扩展。)。
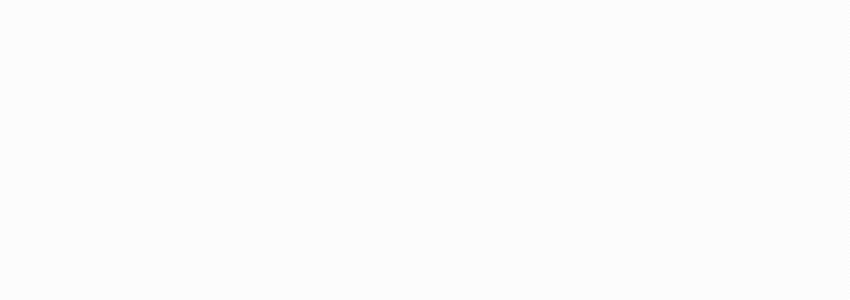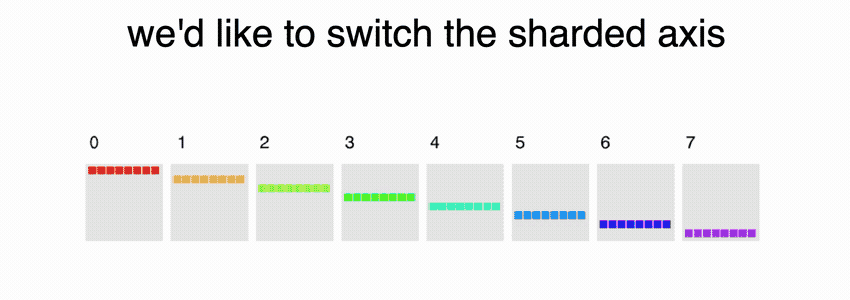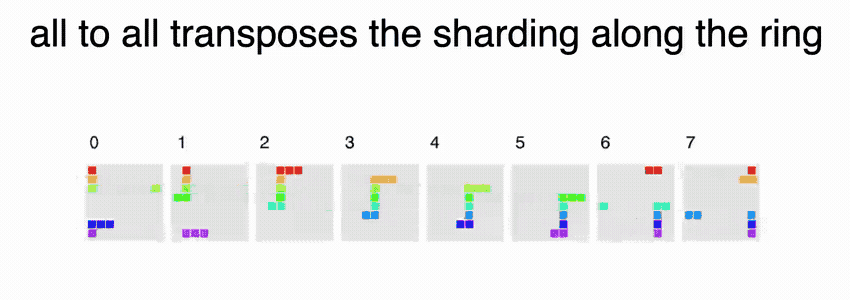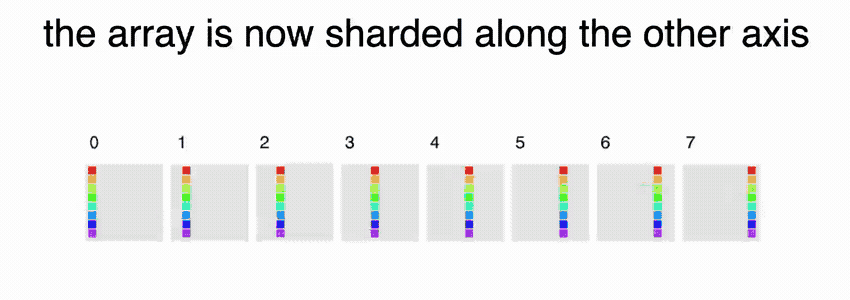
如果我们推广到 ND AllToAll,则 AxBxC 网格上 $V$ 总字节数(所有设备的总和)数组的总体成本为
$$T_\text{comms per AllToAll} = \frac{V \cdot \max(A, B, C, …)}{4 \cdot N \cdot W_\text{ici}}$$
其中,像往常一样,$W_\text{ici}$ 是双向 ICI 带宽,$N = A \cdot B \cdot C \cdot \ldots$ 是设备总数。同样,就每个设备字节 $V / N$ 而言,成本为 $(V / N) \cdot \max(A, B, C, …) / (4 \cdot W_\text{ici})$。对于 1D 网格,这可减少至 $V / (4 \cdot W_\text{ici})$,这是 AllGather 成本的四分之一。在 2D 中,成本实际上随着最小轴的大小而减小。
旁白:如果你想要手动推导这一事实,请从一维环面 $\mathbb{Z} / N\mathbb{Z}$ 开始。如果我们随机选择一个源节点和目标节点,它们之间平均有 N / 4 跳,这给我们带来了 $(V \cdot N) / (4 * N)$ 的成本。现在,如果我们考虑 ND 环面,每个轴基本上都是独立的。每个节点有 $1 / N$ 字节,平均必须跳跃其数据 $\max(A, B, C, …) / 4$ 跳。你还可以从二分带宽得出这一点:在 AllToAll 中,网格的每一半将其一半数据($V / 4$ 字节)发送到另一半。最窄的二等分垂直于最长轴进行切割,穿过 $2 \cdot N / \max(A, B, …)$ 链路(两个切割平面,计算环绕),以获得 $N \cdot W_\text{ici} / \max(A, B, …)$ 的单向带宽。除法得出上面的公式。
有关ReduceScatter 的更多信息
ReduceScatter 是一个比乍一看更基本的操作,因为它实际上是 AllGather 的派生,反之亦然。即,如果在前向传播中我们有:
$$\textbf{AllGather}_X A[I_X] \rightarrow A[I]$$
然后,我们对反向模式导数 **A’**(通常在每个分片上都不同)进行ReduceScatter,以导出分片 **A’**:
$$\textbf{ReduceScatter}_X A’[I] { U_X } \rightarrow A’[I_X]$$
同样,前向传播中的 $$\text{ReduceScatter}X(A[I] {U_X}) \to A[I_X]$$ 意味着反向传播中的 $$\text{AllGather}{X}(A’[I_X]) \to A’[I]$$。
有关AllGather和ReduceScatter如何相互衍生的详细信息,请单击此处。
这是因为广播和归约作为线性算子是相互转置的,而 AllGather 和ReduceScatter 分别是广播和归约的外积(也称为克罗内克积)。具体来说,如果我们有一个向量$x \in \mathbb{R}^n$,任意数量的设备$p \in \mathbb{N}$,并且我们让$u = (1, \ldots, 1) \in \mathbb{R}^p$,我们可以通过以下方式定义broadcast和reduce,这应该符合你对它们的直观理解:
$$
\begin{align*}
\text{broadcast} &: \mathbb{R}^n \rightarrow \mathbb{R}^{p n} \
\text{broadcast} &= u \otimes \mathbf{I}_n \
\text{reduce} &: \mathbb{R}^{p n} \rightarrow \mathbb{R}^n \
\text{reduce} &= u^T \otimes \mathbf{I}_n
\end{align*}
$$
让我们看一下示例,其中 $n = 1$、$p = 2$。如果 $x = (7)$,我们有 $$\text{broadcast}(x) = \left(\begin{pmatrix} 1 \ 1 \end{pmatrix} \otimes \begin{pmatrix} 1 \end{pmatrix}\right) x = \begin{pmatrix} 1 \ 1 \end{pmatrix} x = \begin{pmatrix} 7\ 7 \end{pmatrix} \in \mathbb{R}^{p n}$$。这符合我们的预期,将 $\mathbb{R}^n$ 中的向量广播到 $\mathbb{R}^{pn}$。现在让$y = (8, 9)$,我们有$$\text{reduce}(y) = \left(\begin{pmatrix} 1 & 1 \end{pmatrix} \otimes \begin{pmatrix} 1\end{pmatrix}\right) y = \begin{pmatrix} 1 & 1 \end{pmatrix} \begin{pmatrix} 8 \ 9 \end{pmatrix} = \begin{pmatrix} 17 \end{pmatrix}$$。这再次符合我们的预期,将 $\mathbb{R}^{p n}$ 中的向量减少为 $\mathbb{R}^{n}$ 中的向量。由于 $(A \otimes B)^T = A^T \otimes B^T$ 对于任意两个矩阵 $A$ 和 $B$,我们看到 $\text{reduce} = \text{broadcast}^T$。我们将AllGather和ReduceScatter恢复为以下外部产品:
$$
\begin{align*}
\text{AllGather} &: \mathbb{R}^{p n} \rightarrow \mathbb{R}^{p^2 n} \
\text{AllGather} &= \text{broadcast} \otimes \mathbf{I}_p \
\text{ReduceScatter} &= \mathbb{R}^{p^2 n} \rightarrow \mathbb{R}^{p n} \
\text{ReduceScatter} &= \text{reduce} \otimes \mathbf{I}_p
\end{align*}
$$
在这里,我们将 $\mathbb{R}^{p^2 n}$ 视为 $\mathbb{R}^{p \times p n}$,因此每个 $p$ 设备都有一个 $\mathbb{R}^{p n}$ 向量。我们建议尝试一些小示例,例如 $n = 2$、$p = 3$,看看这些运算符作为矩阵是什么样子。使用相同的转置性质,我们再次获得 $\text{AllGather}^T = \text{ReduceScatter}$,当然还有 $\text{ReduceScatter}^T = \text{AllGather}$。这种转置将在反向传播期间出现,因为如果我们对某些线性算子 $A$(例如 AllGather 或 ReduceScatter)有 $y = Ax$,那么在反向传播期间,我们将得到损失相对于 $y$、$\frac{\partial L}{\partial y}$ 的导数,并且我们得到 $\frac{\partial L}{\partial x}$ 为$\frac{\partial L}{\partial x} = A^T \frac{\partial L}{\partial y}$。这显示了 AllGather 的导数将如何是ReduceScatter,反之亦然。
将 AllReduce 转换为 AllGather 和 ReduceScatter 还具有一个方便的属性,即我们可以将最终的 AllGather 推迟到稍后的某个时刻。通常,我们宁愿不支付重新组装跨设备复制的完整矩阵产品的成本。相反,即使在将两个被乘数与分片收缩维度组合的情况下,我们也希望保留分片状态:
$$A[I, J_X] \cdot B[J_X, K] \rightarrow C[I, K_X]$$
在这种情况下,我们还可以执行ReduceScatter而不是AllReduce,然后选择性地在稍后的某个时间执行AllGather,即
$$\begin{align*}
A[I, J_X] \cdot_{LOCAL} B[J_X, K] \rightarrow &\ C[I, K] { U_X } \
\textbf{ReduceScatter}_{X,K} C[I, K] { U_X } \rightarrow &\ C[I, K_X]
\end{align*}$$
请注意,ReduceScatter“引入”了分片维度,因此在本例中具有沿着 I 或 K 命名维度进行分片的天然自由度。在使用ReduceScatter时,我们通常需要选择哪个命名维度来引入新的分片(尽管该选择通常是由更大的建模上下文强制的)。这就是为什么我们使用语法 ReduceScatterX,K 来指定要分片的轴。
如何将 matmul 通信与计算重叠
正如我们在第 1 部分 中讨论的那样,我们通常假设如果通信足够快,我们总是可以将通信与一些有用的计算重叠。本节中的集合通常可以与矩阵乘法计算本身重叠,但这样做并不简单。我们使用的算法称为“集体 matmul”,首先在 Wang 等人 中进行了描述。以下是如何实现这种重叠的简化动画:
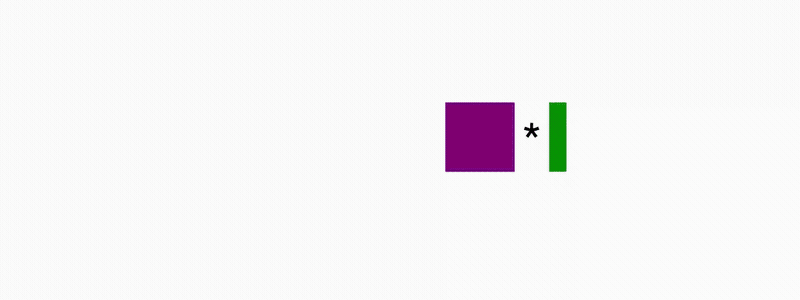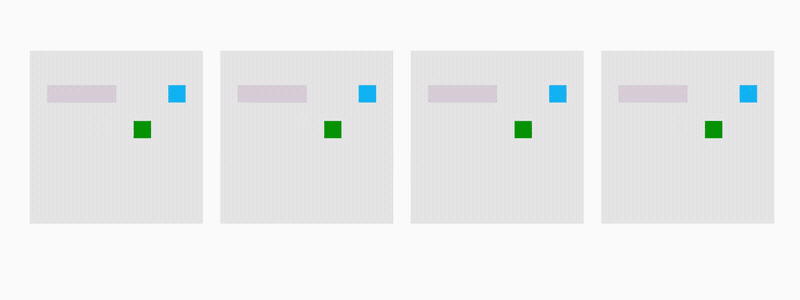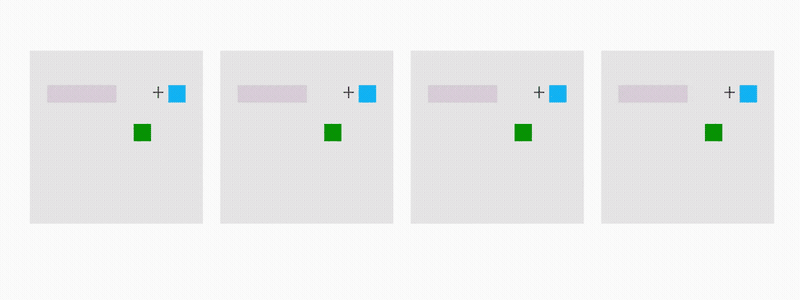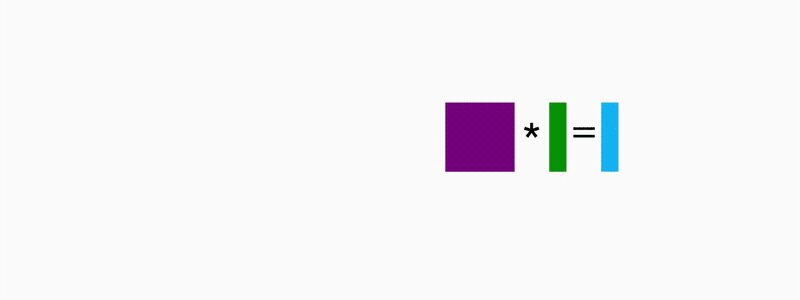
图: 动画显示单个分片矩阵向量乘积如何与生成的 AllReduce 重叠(上面的情况 3)。完整的 matmul 由多个矩阵向量乘积组成。
简而言之,我们可以对矩阵的一个块进行 matmul,同时开始对前一个块进行环约简。在某些情况下,我们还可以平铺批量维度或矩阵输入维度。我们在第 10 部分 中完成了一个简单的 JAX 实现,Mosaic 文档 也给出了一个关于 GPU 的很好的例子。我们鼓励你在某个时候实施此版本。
我们学到了什么?
数组的分片由 Mesh 指定,Mesh 命名 TPU 网格的物理硬件轴,而 Sharding 将网格轴名称分配给数组的逻辑轴。
- 例如,A[IXY, J] 描述了一个抽象数组 A,其第一维沿两个网格轴 X 和 Y 分片。与 Mesh(mesh_shape=(4, 8), axis_names=(‘X’, ‘Y’)) 或缩写的 Mesh({‘X’: 4, ‘Y’: 8}),这告诉我们我们的数组沿第一个维度分为 32 种方式。
分片数组的算术工作原理与未分片数组完全相同,除非你沿分片轴执行收缩。在这种情况下,我们必须引入一些沟通。我们考虑四种情况:
- 两个数组都没有沿着契约维度进行分片:不需要通信。
- 一个数组沿着收缩维度进行分片(或者收缩维度沿着不同的轴进行分片):我们在执行操作之前收集其中一个输入。
- 两个数组沿收缩维度进行相同的分片:我们在本地乘以分片,然后执行 AllReduce 或 ReduceScatter。
- 两个数组都沿着相同的网格轴沿着非收缩维度进行分片:我们首先收集其中一个输入。
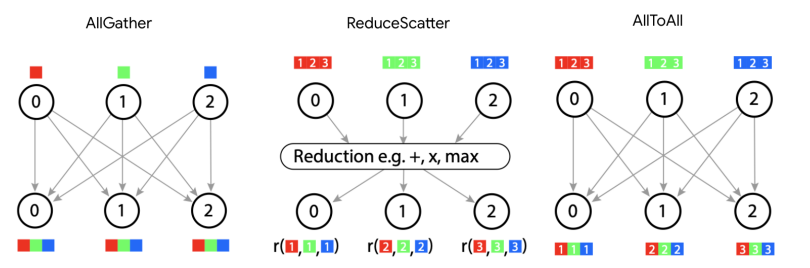
TPU 大致使用 4 个核心通信原语:
- 全部收集:$[A_X, B] \to [A, B]$
- 减少分散:$[A, B] \{U_X\} \to [A_X, B]$
- 全部到全部:$[A, B_X] \to [A_X, B]$
- AllReduce:$[A_X, B]\{U_Y\} \to [A_X, B]$(技术上不是原语,因为它结合了ReduceScatter + AllGather)
- 每个操作的成本和延迟不取决于轴的大小(只要它们受带宽受限),而仅取决于输入数组的大小和链路的带宽。对于单向 AllGather/ReduceScatter:
$$T_{\text{comm per AllGather or ReduceScatter}} = \frac{\text{Data volume}}{\text{bandwidth}} \cdot \frac{\text{Axis} - 1}{\text{Axis}}
\longrightarrow \frac{\text{Data volume}}{\text{bandwidth (bidirectional)}}$$
- AllReduce 由一个ReduceScatter 和一个AllGather 组成,因此其成本是上述的2 倍。 AllToAll 只需要在环中传递分片,因此成本是 AllGather 的 1/4。总结如下:
| 运营 | 描述 | 语法 | 运行时 |
|---|---|---|---|
| 全部聚集 | 沿轴收集分片数组的所有分片,删除下标。 | $[A_X, B] \to [A, B]$ | 字节/(双向 ICI 带宽 * num_axes) |
| 减少分散 | 沿一个轴对部分求和的数组求和,并沿另一个轴对其进行分片(添加下标)。 | $[A, B] \{U_X\} \to [A_X, B]$ | 与 AllGather 相同 |
| 全部减少 | 沿轴对部分求和的数组求和。删除 { Ux }。结合了 AllGather 和 ReduceScatter。 | $[A_X, B]\{U_Y\} \to [A_X, B]$ | 2 * 聚集 |
| 所有到所有 | 收集(复制)一个轴并沿同一轴分割不同的维度。 | $[A, B_X] \to [A_X, B]$ | AllGather / 4 用于双向环 |
工作中的一些问题
以下是一些基于本节内容的指导性问题。目前我们不会包含所有答案,但我们会尽可能写出更多答案。
**问题 1 [复制分片]**:数组被分片为 $A[I_X, J, K, \ldots]$(即,仅在 $X$ 上分片),网格为 Mesh({'X': 4, 'Y': 8, 'Z': 2})。 $A$ 在所有芯片上占用的总字节数与该数组的一份副本的大小之比是多少?
答案:
我们的数组仅沿 X 进行分片,其大小为 4,因此实际上每个分片的大小为 $[I / 4, J, K, \ldots] = \text{sizeof}(A) / 4$。由于我们的阵列是在 Y 和 Z 上复制的,因此总大小为 $Y \cdot Z \cdot \text{sizeof}(A)$,因此总大小与单芯片大小的比率为 $Y \cdot Z \cdot \text{sizeof}(A) / \text{sizeof}(A) = 16$。
**问题 2 [AllGather 延迟]**:如果 $B=1024$ 和 $D=4096$ 在 bfloat16 中,$\text{AllGather}X([B_X, D_Y])$ 在具有网格 Mesh({'X': 4, 'Y': 4, 'Z': 4}) 的 TPU v4p 4x4x4 切片上需要多长时间? $$\text{AllGather}{XY}([B_X, D_Y])$$怎么样? $$\text{AllReduce}_Z([B_X, D_Y] {U_Z })$$怎么样?
答案:
我们在所有轴上都有一个环绕链接,因为我们有一个完整的 4x4x4 立方体,因此我们有 9e10 双向带宽可供使用。
因为我们只是在一个轴上进行收集,而另一个轴进行了分片,所以我们在 1 个轴上有效地收集了 $2BD / Y$ 字节。 如果你只考虑沿 Y 轴的单个分片,则沿 X 的 AllGather 看起来就像具有 1 / Y 字节的未分片 AllGather。 由于我们的 TPU v4p ICI 带宽是 9e10 字节/秒双向,这将需要 $2BD / (\text{9e10} \cdot Y) = 2 \cdot 1024 \cdot 4096 / (\text{9e10} \cdot 4) = 23 \mu s$。
我们的带宽是以前的两倍,但我们正在收集完整的阵列,因此
T = 2BD / (2 * W) = 2*1024*4096 / (2 * 9e10) = 46us。这距离 4us(每跳 1us)的延迟界限还很远,所以我们没问题。AllReduce 的成本是 AllGather 的两倍。每个分片的大小为 $2BD / (X * Y)$,因此成本约为 $4BD / (X * Y * W)$,或者大致为
4 * 1024 * 4096 / (16 * 9e10) = 11.6us。
有趣的事实:部分(1)和(2)实际上并不是最佳的,因为数组也沿着未使用的 Z 轴复制,我们可以利用这些空闲链接:我们可以首先免费重新分片 $[B_X, D_Y] \to [B_{XZ}, D_Y]$(每个设备只删除其分片的一部分),然后执行 $$\text{AllGather}{XZ}$$ (或 $$\text{AllGather}{XYZ}$$),在收集更多轴的同时达到相同的最终状态。这会将第 (1) 部分减少到 11.5us,将第 (2) 部分减少到 31us — 实际上,你可以通过预先在更多轴上进行分片来实现这一点,这也是尽可能精细地分片数组的原因之一。
**问题 3 [延迟限制的 AllGather]**:假设我们正在执行 $\text{AllGather}_X([B_X])$,但 $B$ 非常小(比如 128)。在 bfloat16 中具有网格 Mesh({'X': 4, 'Y': 4, 'Z': 4}) 的 TPU v4p 4x4x4 切片上需要多长时间? 提示:你可能受到延迟限制。
答案:
bfloat16 中的数组总共仅使用 256 个字节,并且每个设备仅使用 64 个字节。由于我们在 TPU v4p 上有一个大小为 4 的轴,因此我们有一个环绕链接,因此我们可以在两个方向上发送数组。对于 4.5e10 的单向带宽,每一跳大约需要 64 / 4.5e10 ~ 0,因此我们肯定会受到延迟限制。计算跳数,我们只需 2 跳即可完成完整收集,因此大约 2us 是一个不错的估计。
*问题 4 [matmul 策略]*:要执行 $X[B, D] \cdot_D Y[D_X, F] \to Z[B, F]$,在本节中,我们将告诉你执行 $\text{AllGather}_X(Y[D_X, F])$ 并将完全复制的矩阵相乘(情况 2,策略 1*)。相反,你可以乘以 $X[B, D_X] \cdot_D Y[D_X, F] \to Z[B, F] \{U_X\}$(案例 3,策略 2*)等本地分片,然后乘以 $\text{AllReduce}_X(Z[B, F] \{ U_X\})$。其中每一个执行了多少次 FLOP 和通信?哪个更好,为什么?
答案:
让我们从基线开始(策略 1)。正如我们所展示的,AllGather 的成本为 $2DF / W_\text{ici}$。一旦我们有了完全复制的数组,总计算时间就是 $2BDF / C$(其中 $C$ 是我们的加速器 FLOPs/s,因为每个 TPU 执行相同的 FLOPs)。所以我们有
$$T_\text{total (Strategy 1)} = \max\left(\frac{2BDF}{C}, \frac{2DF}{W_\text{ici}}\right)$$
相比之下,新策略(策略 2)在 $2BF$ 字节上执行 AllReduce,其成本为 $4BF / W_\text{ici}$,但减少了 $1 / X$ 的 FLOP(因为计算是分片的)。这意味着我们执行 $2\cdot B\cdot D\cdot F / X$ FLOP,并且生成的 AllReduce 在 bfloat16 中传递 $$2 \cdot 2 \cdot B \cdot F$$ 字节。因此,我们策略 2 的总时间(没有 AllGather,只是稍后的 AllReduce)大约是
$$T_\text{total} = \max\left(\frac{2BDF}{X \cdot C}, \frac{4BF}{W_\text{ici}}\right)$$
问题是:其中哪个更大?当 $D / (X \cdot C) > 2 / W_\text{ici}$ 或 $D / 2X > C / W_\text{ici} \approx 2550 \rightarrow X < D / (2 * 2550)$ 时,策略 (2) 是计算受限的。我们可能合理地期望 $D \approx 8k$,所以这意味着大约是 $X < 2$,这是不太可能的 - 因此我们基本上总是与策略 2 进行通信受限。使用基线(策略 1),当 $$B < C / W_\text{ici} = 2550$$ 时我们会进行通信受限,这通常但并不总是如此。
因此,如果 $B < 2550$,我们在这两种情况下都是通讯绑定的,并且我们有
$$T_\text{comms for Strategy 2} < T_\text{comms for Strategy 1} \Leftrightarrow \frac{4BF}{W_\text{ici}} < \frac{2DF}{W_\text{ici}}$$
当 $D > 2B$ 其中 $2B < 5100$ 时,这是正确的。这通常是正确的,因此如果我们的批量较小,策略 2 有时会更好。当我们的批量很大时($B > 2550$),我们有
$$T_\text{comms for Strategy 2} < T_\text{math for Strategy 1} \Leftrightarrow \frac{4BF}{W_\text{ici}} < \frac{2BDF}{C}$$
当 $2 / W_\text{ici} < D / C$ 或 $D > 2 * 2550 = 5100$ 时就是如此,对于大型模型通常如此。因此,这种替代策略通常更适合大型模型,除非 $D$ 很小。
为什么我们不总是这样做? 好吧,在实践中我们有时可能会这样做,但通常很少有一个 matmul 输入的收缩维度沿着另一个输入未分片的轴分片。例如,如果我们正在进行 FSDP(在第 5 节 中进行了解释),我们将在数据维度上对参数进行分片,但我们的激活也将沿着数据进行分片。所以从这个意义上来说,这并没有表现出太多。
**问题 5 [最小延迟]**:假设我想在 TPU v4p 4x4x4 上以尽可能低的延迟进行 matmul $A[I, J] \cdot_J B[J, K] \to C[I, K]$。假设输入可以任意分片,但结果应该完全复制。我的输入应该如何分片?总的 FLOP 次数和通信时间是多少?
部分答案:
我们不会在这里提供完整的答案,但我们将首先描述四个最有可能的选项:
- $A[I_{XYZ}, J] \cdot B[J, K]$+最后AG
- $A[I, J] \cdot B[J, K_{XYZ}]$+最后AG
- $A[I, J_{XYZ}] \cdot B[J_{XYZ}, K]$ + AR 最后
- $A[I, J] \cdot B[J, K]$(完全复制)
我们还可以考虑沿不同的网格轴对不同的轴进行分片,但这不太可能改变最终的成本。对于除 (4) 之外的所有情况,每个 TPU 的总 FLOP 是相同的,但每个 TPU 的通讯不同。然后,我们只需计算每个的通信成本,看看哪个是最低的。 TLDR 是(1)和(2)同样好。
问题 6: 假设我们要在 TPU v5e 4x4 上执行 $A[I_X, J_Y] \cdot_J B[J_Y, K] \to C[I_X, K]$。我们进行什么沟通?通信与计算上花费了多少时间?
- $A[I_X, J] \cdot_J B[J_X, K_Y] \to C[I_X, K_Y]$呢?这是我们结合数据、张量和 ZeRO 分片的最标准的训练设置。
- $A[I_X, J] \cdot_J B[J, K_Y] \to C[I_X, K_Y]$呢?这是推理的标准,我们在其中进行纯张量并行(+数据)。
问题 7: 典型的 Transformer 块有两个矩阵 $W_\text{in}[D, F]$ 和 $W_\text{out}[F, D]$,其中 $F \gg D$。假设我们有一个批量大小 B。那么完整的块是 $In[B, D] \cdot W_\text{in}[D, F] \cdot W_\text{out}[F, D]$。我们选择 $D=8192$、$F=32768$ 和 $B=128$ 并假设所有内容都在 bfloat16 中。假设我们在 TPU v5e 2x2 切片上运行,但假设每个 TPU 只有 300MB 的可用内存。应如何对 In、$W_\text{in}$、$W_\text{out}$ 和 Out 进行分片,以保持低于内存限制,同时最小化总体时间?在通信和 FLOP 上花费了多少时间? 提示:最终输出不需要完全复制,但应该与输入一样进行分片,以便可以重复“层”。
部分答案:
首先让我们考虑一下内存。我们的两个大矩阵都使用 2 * 8192 * 32768 = 536MB。我们的激活 In 的大小为 2 * 128 * 8192 = 2MB(足够小,不用担心)。由于每个设备中只有 300MB 的空闲内存,因此我们显然需要对 matmul 进行分片。
- $In[B_X, D] * W_\text{in}[D_{XY}, F] * W_\text{out}[F, D_{XY}] \rightarrow Out[B_X, D]$(这通常称为 FSDP)
- $In[B, D_{XY}] * W_\text{in}[D, F_{XY}] * W_\text{out}[F_{XY}, D] \rightarrow Out[B, D_{XY}]$(这称为张量并行)
第一个非常糟糕,因为我们需要首先收集我们的大权重或激活值。第二种需要在开始时使用 AllGather,在末尾使用 ReduceScatter(这比 AllReduce 便宜)。我将把它作为练习来完成其余的数学运算。
**问题 8 [挑战]**:使用上面的短代码片段作为模板,分配一个分片数组,并使用 pmap 或 shard_map 对 4 个主要通信原语(AllGather、AllReduce、ReduceScatter 和 AllToAll)中的每一个进行基准测试。你将需要使用 jax.lax.all_gather、jax.lax.psum、jax.lax.psum_scatter 和 jax.lax.all_to_all。你了解这些函数的语义吗?他们需要多长时间?
**问题 9 [分片 matmul 的另一种策略?]**:上面 我们声称,当 matmul 的只有一个输入沿其收缩维度进行分片时,我们应该 AllGather 分片矩阵并在本地执行结果收缩。你可能会想到的另一种策略是执行分片 matmul,然后对结果进行 AllReduce(就好像两个输入都沿收缩维度进行分片),即 $A[I, J_X] *_J B[J, K] \to C[I, K]$ 通过
- $C[I, K] \{ U_X \} = A[I, J_X] \cdot B[J_X, K]$
- $C[I, K] = \text{AllReduce}(C[I, K] \{ U_X\})$
回答以下问题:
- 显式地为矩阵 $A[N, M]$ 和 $B[M, K]$ 写出该算法,使用索引来准确显示在什么设备上进行了哪些计算。 假设 $A$ 在 ND 设备上分片为 $A[I, J_X]$,并且你希望在所有设备上复制输出。
- 现在假设你同意最终结果不在每个设备上复制,而是进行分片(跨 N 或 K 维度)。 上面的算法会如何改变?
- 纯粹看看上述策略的通信成本(在第 2 部分,而不是第 1 部分),该通信成本与我们首先 AllGather A 然后进行 matmul 的算法的通信成本相比如何?
答案:
- 首先计算外积,将结果存储在$$O[N, K]: o_{kj} = \sum_i a_{ki} b_{ij}$$中。请注意,重复索引不是收缩的索引,因为我们正在做外部产品。这里,总和范围涵盖我们正在使用的特定设备上存储的 i 值集。因此,举例来说,如果我们有一个尺寸为 16 的收缩轴和 4 个设备,那么在设备 0 上,i 的范围为 {0, 1, 2, 3};在设备 1 上,i 的范围为 {4, 5, 6, 7};在设备 2 上,i 的范围为 {8, 9, 10, 11};在设备 3 上,i 的范围为 {12, 13, 14, 15}。然后 AllReduce 每个设备上存在的 $O[N, K]$ 的部分和,以形成完整的 $O[N, K]$。
- 我们可以使用更便宜的ReduceScatter,而不是在步骤2中执行AllReduce,沿着任一轴:$[N, K] \{ U_X \} \to [N_X, K]$或$[N, K] \{ U_X \} \to [N, K_X]$。
- 正如上面正文中所述,执行 AllGather 的成本(当我们受到吞吐量限制时)与执行 ReduceScatter 的成本相同;它只是由我们正在处理的完整矩阵的大小给出。 因此,在“gather-then-matmul”算法中,其缩放比例为 $NM$(因为我们是 $\text{AllGather}$-ing $A$);在 matmul-then-reduce-scatter 算法中,该比例为 NK(因为我们正在减少散射 $O$)。所以两种算法的通信成本比为
M/K。
问题 10:AllToAll 的乐趣: 在上表中,我们注意到执行 AllToAll 的时间比执行 AllGather 或 ReduceScatter 的时间低 4 倍(在吞吐量受限的情况下)。在这个问题中,我们将看到这个因子 4 从何而来,并且还会看到如果我们只有单向 ICI 链路而不是双向 ICI 链路,这个因子会如何变化。
- 我们先从单向的情况开始。想象一下,我们在环形拓扑中拥有 D 设备,并且想要在 N x N 矩阵 $A[I_X, J]$ 上执行 AllGather 或 ReduceScatter(为简单起见,假设 $D$ 除 $N$)。描述这两个集合中涉及的通信,并计算在整个算法过程中通过单个 ICI 链路传输的标量(浮点数或整数)的总数。
- 现在让我们考虑一下 AllToAll,仍然是单向 ICI 情况。 这种情况下的算法与全收集情况有何不同? 计算在此算法中通过单个 ICI 链路传输的标量数量。
- 你应该已经发现(a)部分和(b)部分的答案之间的比率是一个不错的数字。 用简单的术语解释这个因素从何而来。
- 现在让我们添加双向通信。这对全聚集情况下所需的总时间有何影响?
- 添加双向通信如何影响 AllToAll 情况下所需的总时间?
- 现在简单解释一下双向环中AllGather时间和AllToAll时间的比率。
答案:
(1) 解决方案: 过程很简单:在算法的每一步中,每个设备都会将矩阵的单分片“条带”(总大小为 $$\frac{N}{D} \times N$$ 元素)发送到其最近的邻居。这种情况会发生 $$D-1$$ 次,因为每个分片都需要与除其开始所在的设备之外的所有设备进行通信。因此,总共 $$\frac{N^2(D-1)}{D}$$ 标量由每个设备传输,即流经单个 ICI 链路。
答案: $$N^2 (1-\frac{1}{D})$$,或者在 $$D >> 1$$ 时简称为 $$N^2$$。
(2) 解决方案: 从通信的角度来看,AllToAll 和 AllGather 之间的主要区别在于,在 AllToAll 中,特定设备上的整个分片不需要与所有其他设备进行通信。想象一下存储在特定设备(称为设备 0)上的分片是 $$[A, B, C, D]$$(这里 A、B、C、D 是矩阵,我们想象一个包含 4 个设备的环以进行说明)。现在矩阵 $$A$$ 不需要在任何地方进行通信,矩阵 $$B$$ 需要最终到达设备 1 上;矩阵 $$C$$ 最终出现在设备 2 上;矩阵 $$D$$ 最终在设备 3 上。因此,在算法的第一步中,我们将 $$B$$、$$C$$ 和 $$D$$ 发送到设备 1;下一步,设备1向设备2发送$$C$$和$$D$$;在最后一步中,设备 2 仅将 $$D$$ 发送到设备 3。在这种情况下,传输的参数总数为 $$(\text{size of A/B/C/D}) * (3 + 2 + 1)$$。 A/B/C/D 的大小是(现在一般情况下)$$\frac{N^2}{D^2}$$,并且在一般情况下,$$(3 + 2 + 1)$$ 项再次变为 $$((D-1) + (D-2) + … + 1)$$ 或 $$\frac{(D)(D-1)}{2}$$。因此,通过单个 ICI 链路传输的字节总数为 $$\frac{N^2(D-1)}{D \times 2}$$。
答案: $$\frac{N^2}{2}(1-\frac{1}{D})$$,或者在 $$D >> 1$$ 时简称为 $$\frac{N^2}{2}$$。
(3) 解决方案: 因子就是 $$\frac{1}{2}$$,即 AllToAll 的成本是单向环形拓扑上的 all-gather/ReduceScatter 的一半。看看上面的推导,这最终来自于这样一个事实:在全收集情况下,我们每次 $$(D-1)$$ 次传输相同大小的块,即我们正在计算 $$ \text{tiny block size} * (D + D + D + … + D)$$ 的总和,而在 AllToAll 情况下,我们正在计算 $$\text{tiny block size} * (D + D-1 + D-2 + … + 1)$$ 的总和。因此,因子 2 本质上来自 $$1 + 2 + \ldots + n = n(n+1)/2$$ 这一事实。
(4) 解决方案:任何一个链路必须携带的标量总数现在减少了 2 倍,因为在双向环中,每个“分片条”可以同时以两种方式发送。
(5) 解决方案:在这种情况下,与单向情况相比,我们赢得了 4 倍的胜利。 通过考虑单个分片条中每个大小 (N2/D2) 块的命运,例如源自设备 0 的块,最容易看出这一点。我们现在将条带划分为向右或向左移动的块,移动最大距离为楼层 (D/2),而不是(如在单向情况下)将其中一个块发送距离 D-1,将另一个块发送距离 D-2,等等,一直到 1。 因此,相应的总和现在变为 $$D/2 + D/2 - 1 + D/2 - 2 + … = D/2 \cdot (D/2+1)/2$$,或者在大 $$D$$ 的限制下为 $$D^2/8$$。 将其与单向情况下的 $$D^2/2$$ 进行比较,我们发现我们赢得了 4 倍。
(6) 解决方案: 在单向环中,我们看到AllToAll时间已经是all-gather时间的两倍;这是因为我们不需要将完整的条带发送到每个设备。 然后,当我们添加双向性时,我们发现 AllToAll 获得了 4 倍的胜利,而 all-gathers 只获得了 2 倍的胜利。 将这些比率放在一起,我们得到了我们所追捧的因子 4。
第 3 章到此结束!接下来进入介绍 Transformer 数学的第 4 章。
译文与许可:本章是基于固定版本
173fb0851d7e654872f0327aff2e17607cf24106的机器辅助中文初译,并非逐句人工精校。原文与配图基于 MIT License 发布。Copyright (c) 2022 Maruan Al-Shedivat;Copyright (c) 2025 Google LLC。完整许可见 MIT License。