原著:Jacob Austin 等,Google DeepMind,《How to Scale Your Model》。本章原文。原文固定版本:
173fb0851d7e,获取日期:2026-10-26,MIT 许可。
本章为完整范围的机器辅助中文初译。
简介:训练大语言模型常让人觉得像炼金术,但理解和优化性能并不必如此。本书解释语言模型扩展背后的规律:TPU 与 GPU 怎样工作、如何互相通信,LLM 怎样在真实硬件上运行,以及如何在训练和推理时安排并行,让模型在大规模硬件上高效执行。如果你想知道一个模型应该花多少钱训练、自己部署需要多少内存,或者 AllGather 是什么,希望本书能帮到你。
深度学习的大部分内容仍然可以归结为一种黑魔法,但优化模型的性能不必如此——即使是大规模的!相对简单的原则适用于任何地方——从处理单个加速器到数万个加速器——理解它们可以让你做很多有用的事情:
- 大致了解模型的各个部分与其理论最佳值的接近程度。
- 对不同规模的不同并行方案做出明智的选择(如何在多个设备之间分割计算)。
- 估计训练和运行大型 Transformer 模型所需的成本和时间。
- 设计利用特定硬件功能可供性的算法。
- 通过明确了解限制当前算法性能的因素来设计硬件。
预期背景: 我们假设你对 LLM 和 Transformer 架构有基本了解,但不一定了解它们如何大规模运行。你应该了解 LLM 训练的基础知识,并且最好对 JAX 有一定的了解。一些有用的背景阅读可能包括关于 Transformer 架构的这篇博文 和原始 Transformer 论文。另请查看此列表以获取更有用的并发和未来阅读。
你可能还会喜欢阅读有关 NVIDIA GPU 的新 第 12 节!
你为什么要关心?
三四年前,我认为大多数机器学习研究人员不需要理解本书中的任何内容。但如今,即使是“小型”模型的运行也如此接近硬件限制,以至于进行新颖的研究需要考虑规模效率。(原注:从历史上看,机器学习研究遵循系统创新和软件改进之间的循环。 Alex Krizhevsky 必须编写糟糕的 CUDA 代码才能使 CNN 更快,但几年之内,Theano 和 TensorFlow 等库意味着你不必这样做。也许这种情况也会发生在这里,几年后本书中的所有内容都会被抽象掉。但缩放法则将我们的模型永远推向了硬件的最前沿,而且在可预见的未来,进行前沿研究似乎将与如何有效地将模型缩放到大型硬件拓扑密不可分。) 如果一种新架构在基准测试中的表现提升了 20%,却让硬件运行效率降低了 20%,那么这种提升就可能失去实际价值。 许多看起来很有潜力的模型架构,最终没能取得成功:有的是因为无法在大规模硬件上高效运行,有的则是因为没有投入足够的工程工作,让它们高效运行起来。
译者补充:这里的“硬件运行效率”对应原文的 roofline efficiency,指实际性能接近 Roofline 模型所预测上限的程度。作者想强调:评估新架构,既要看模型效果,也要看实际运行的资源成本。两个“20%”是强调这一取舍,并不表示模型效果与运行效率能直接相减、恰好抵消。
“模型扩展”的目标是能够增加用于训练或推理的芯片数量,同时实现吞吐量的成比例、线性增加。这称为“强扩展”。尽管添加额外的芯片(“并行性”)通常会减少计算时间,但这也会以增加芯片之间的通信为代价。当通信时间比计算时间长时,我们就会受到“通信束缚”,并且无法强扩展。(原注:随着计算耗时缩短,还需要留意单块芯片内部的瓶颈。一块全新的 TPU 或 GPU,标称算力可能达到每秒 500 万亿次运算;但如果大量时间花在内存中搬运参数,计算单元就只能等待数据,实际运算速度可能只有标称值的十分之一,也就是每秒约 50 万亿次运算。因此,要让模型高效扩展,就必须同时考虑单芯片算力、内存带宽和内存总容量,以及它们之间的配合。)如果我们足够了解我们的硬件,能够预测这些瓶颈将在哪里出现,我们就可以设计或重新配置我们的模型来避免它们。(原注:硬件设计人员面临着相反的问题:构建为我们的算法提供足够计算、带宽和内存的硬件,同时最大限度地降低成本。你可以想象这个“协同设计”问题的压力有多大:你必须押注当第一批芯片真正可用时(通常是 2 到 3 年后),算法会是什么样子。 TPU的故事在这款游戏中取得了巨大的成功。矩阵乘法是一种独特的算法,因为它每字节内存使用的 FLOP 次数比几乎任何其他算法都要多(每字节 N FLOP),并且早期的 TPU 及其脉动阵列架构比 GPU 在构建时实现了更好的性能/成本。 TPU 是为 ML 工作负载而设计的,带有 Tensor Core 的 GPU 也在迅速变化,以填补这一空白。但你可以想象,如果神经网络没有起飞,或者没有以 TPU(本质上不如 GPU 灵活)无法处理的某些基本方式发生变化,那么成本会有多高。)
我们在本书中的目标是解释 TPU(和 GPU)硬件如何工作,以及 Transformer 架构如何发展以在当前硬件上表现良好。我们希望这对于设计新架构的研究人员和致力于使当前一代法学硕士快速运行的工程师都有用。
高层概要
本书的总体结构如下:
第 1 节 解释了屋顶线分析以及哪些因素会限制我们的扩展能力(通信、计算和内存)。 第 2 节 和 第 3 节 详细讨论了 TPU 如何工作,既作为单独的芯片,又作为具有有限带宽和延迟的芯片间链路的互连系统(至关重要)。我们将回答以下问题:
- 一定大小的矩阵相乘需要多长时间?它在什么时候受到计算、内存或通信带宽的限制?
- TPU 如何连接在一起形成训练集群?系统各部分有多少带宽?
- 在多个 TPU 上收集、分散或重新分布数组需要多长时间?
- 我们如何有效地乘以跨设备不同分布的矩阵?
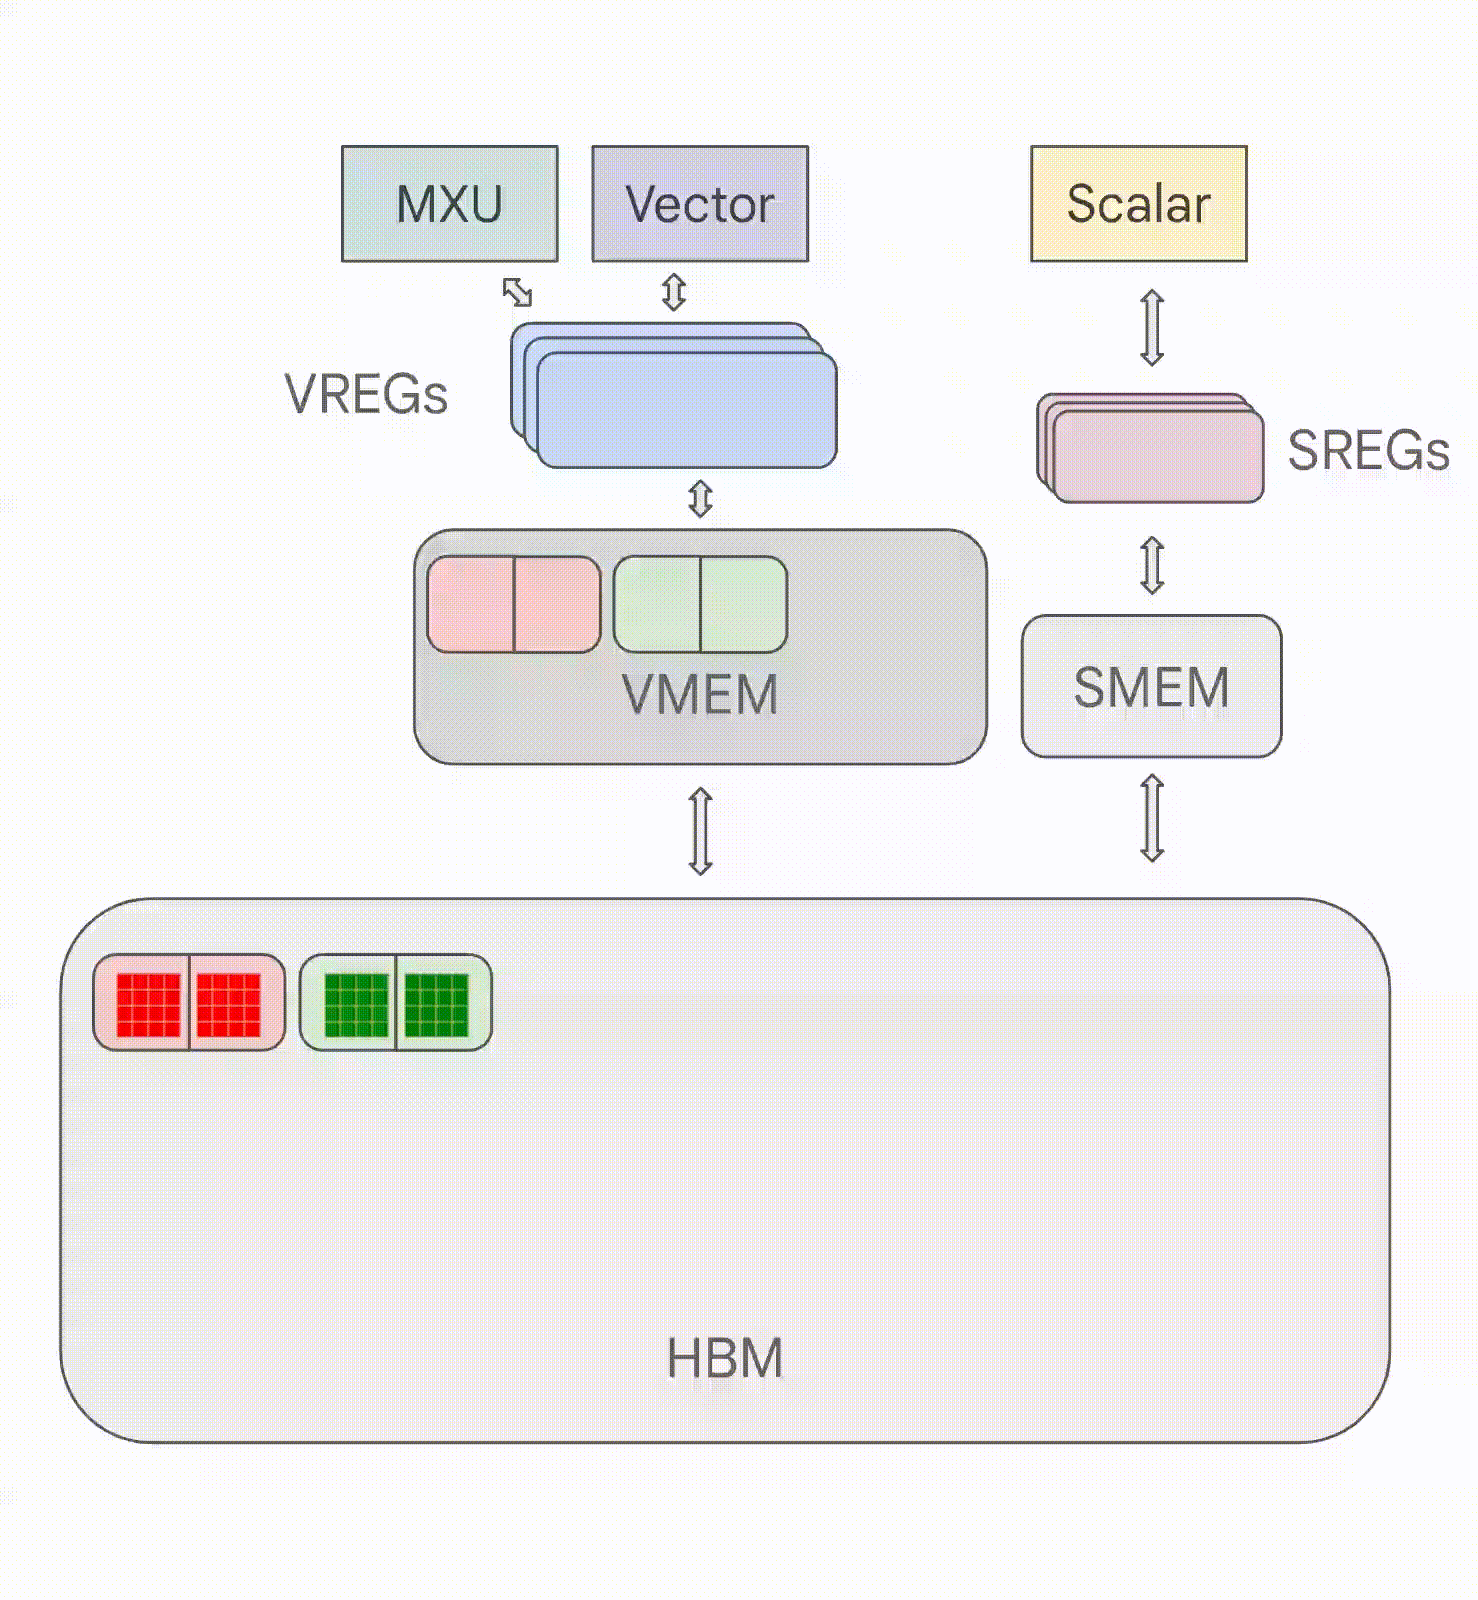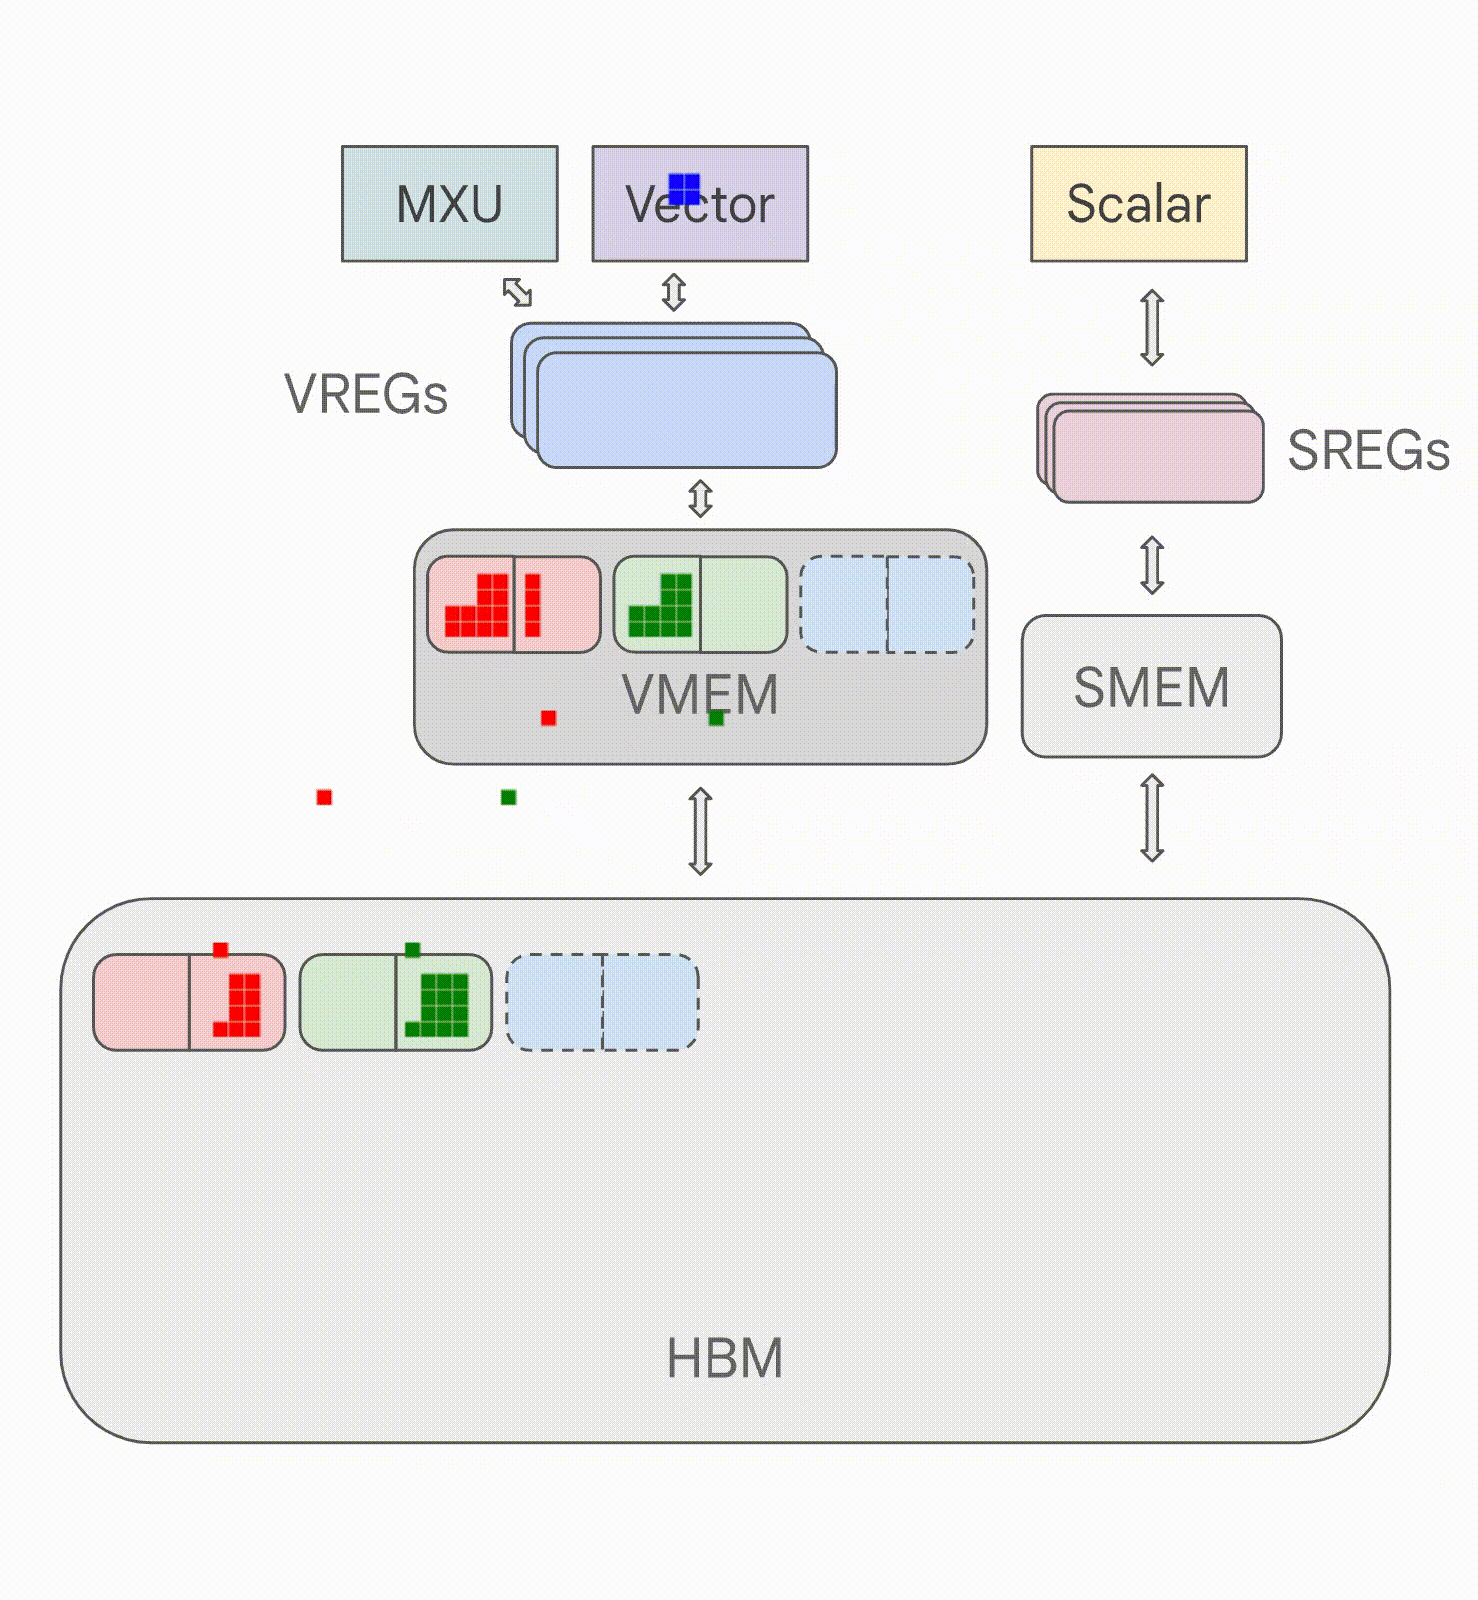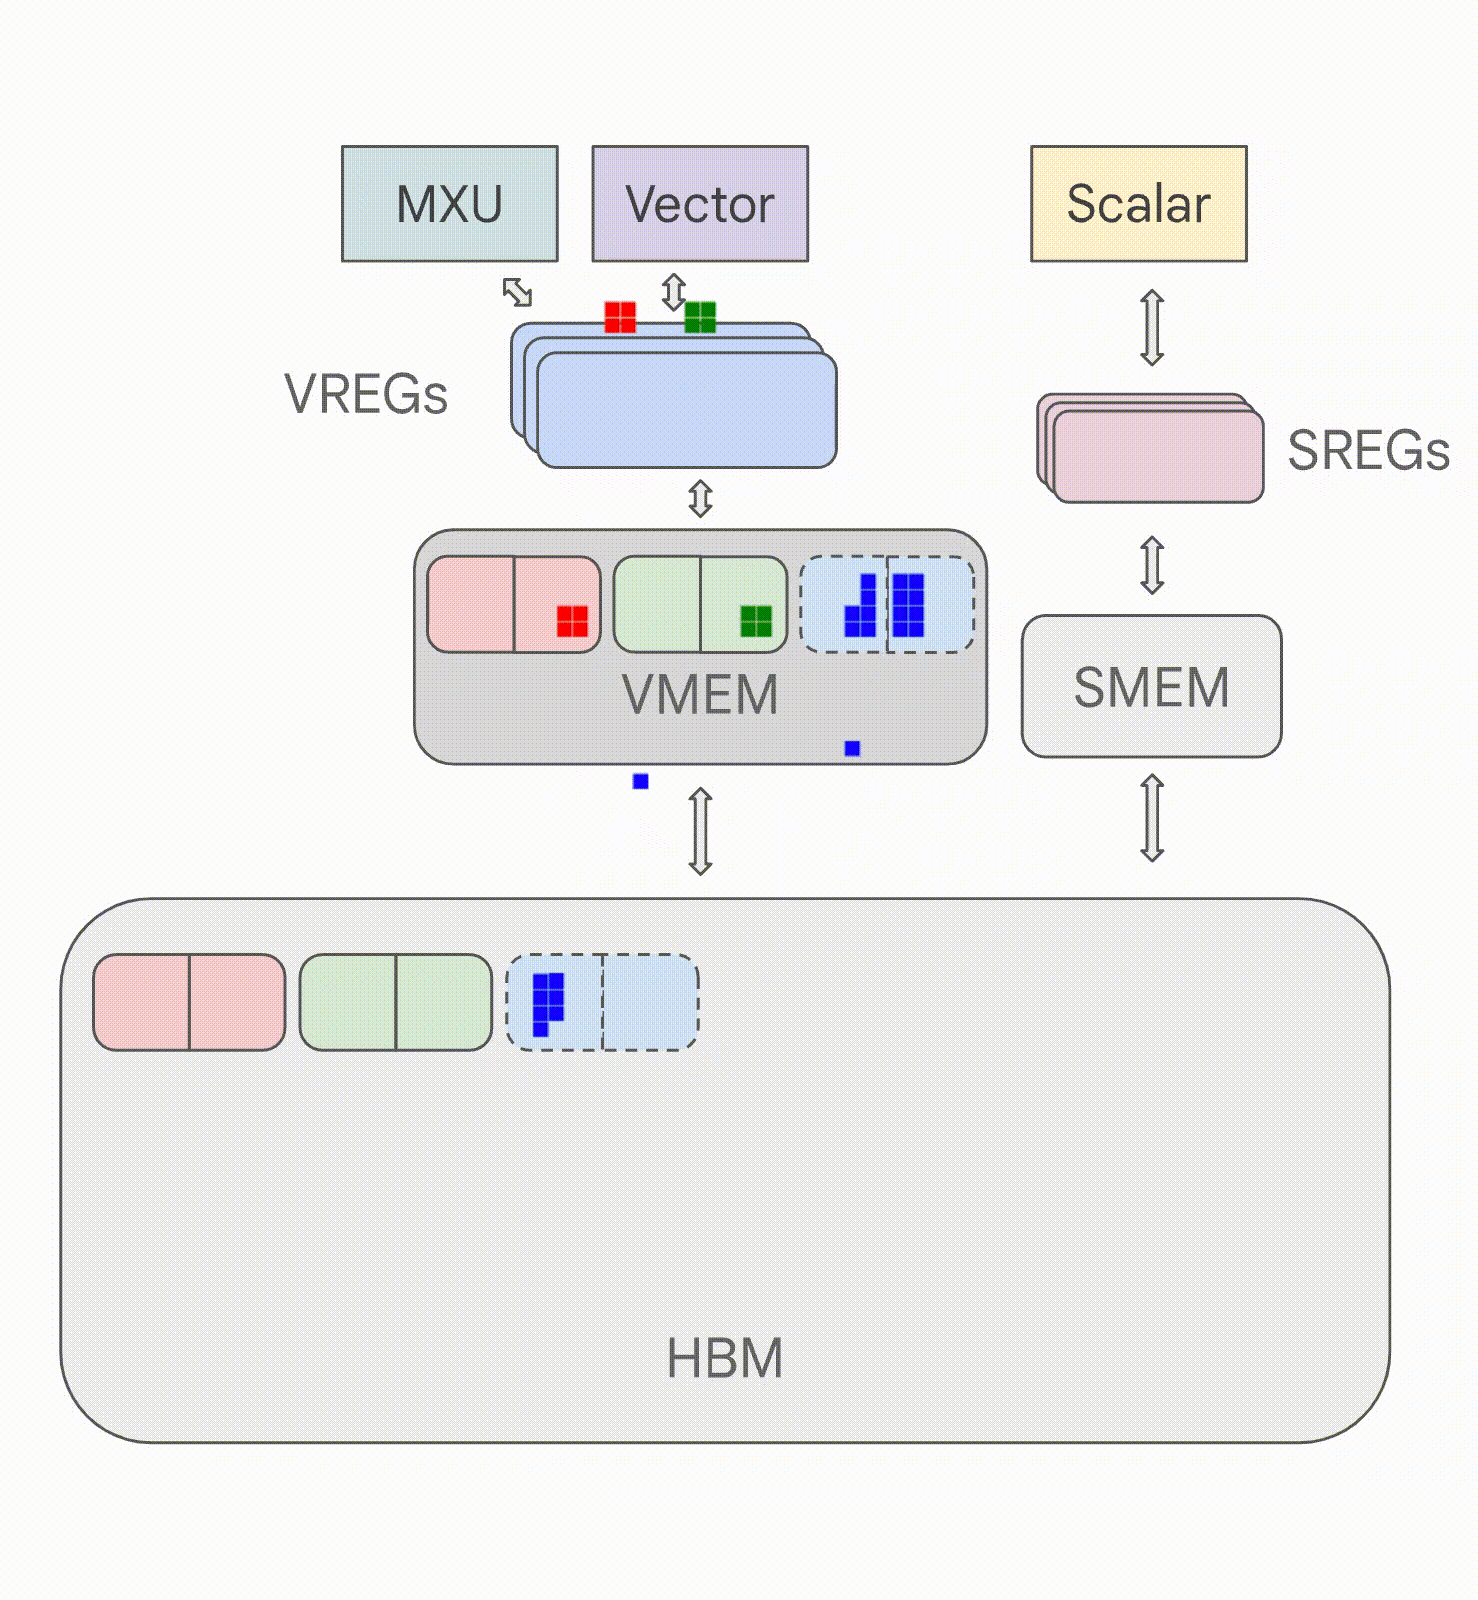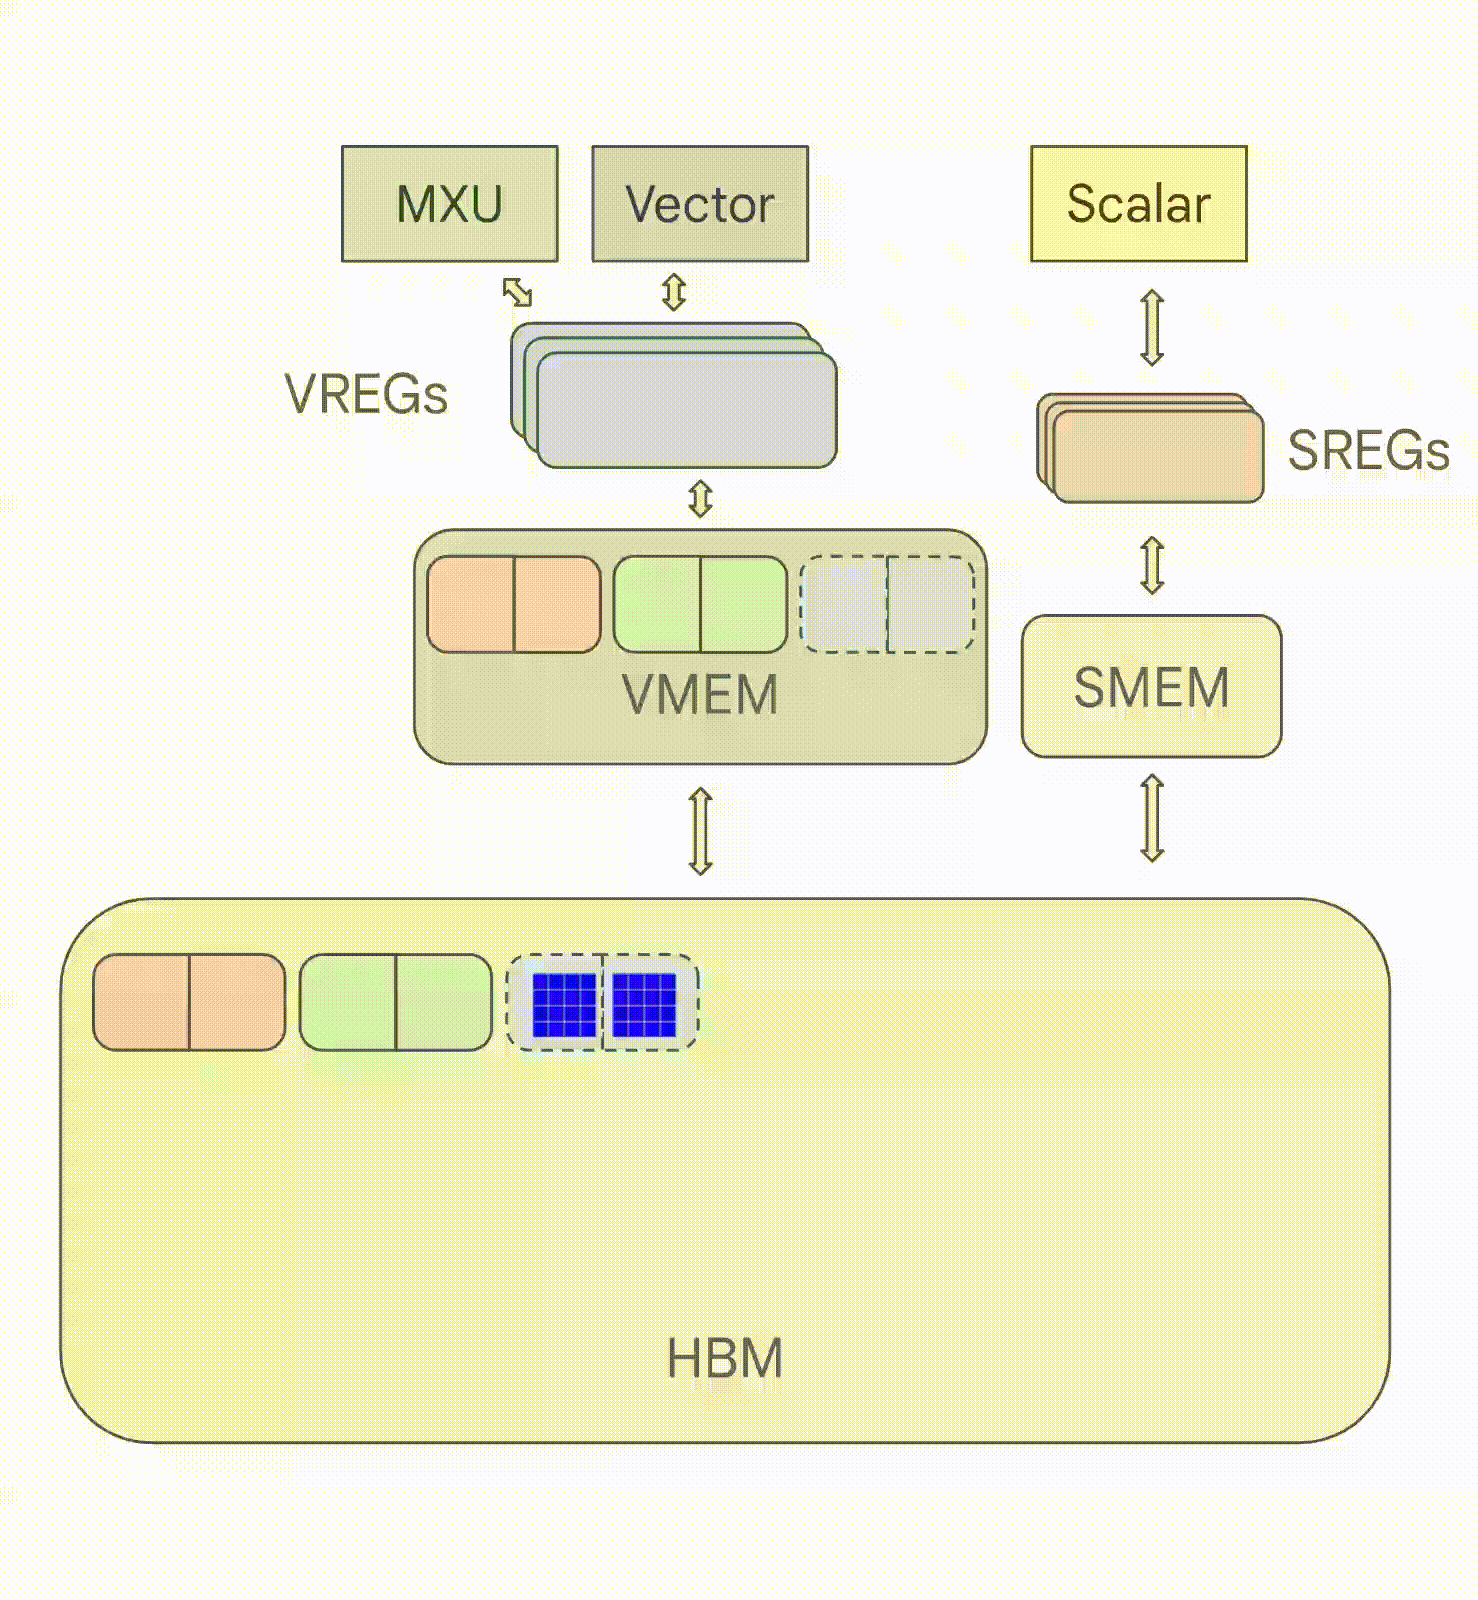
图: 第2部分的图表显示了TPU如何执行元素乘积。根据数组的大小和各种链路的带宽,我们可以发现自己受计算受限(使用全部硬件计算能力)或受内存限制(因内存加载而成为瓶颈)。
五年前,ML 拥有丰富多彩的架构——ConvNet、LSTM、MLP、Transformers——但现在我们大多只有 Transformer
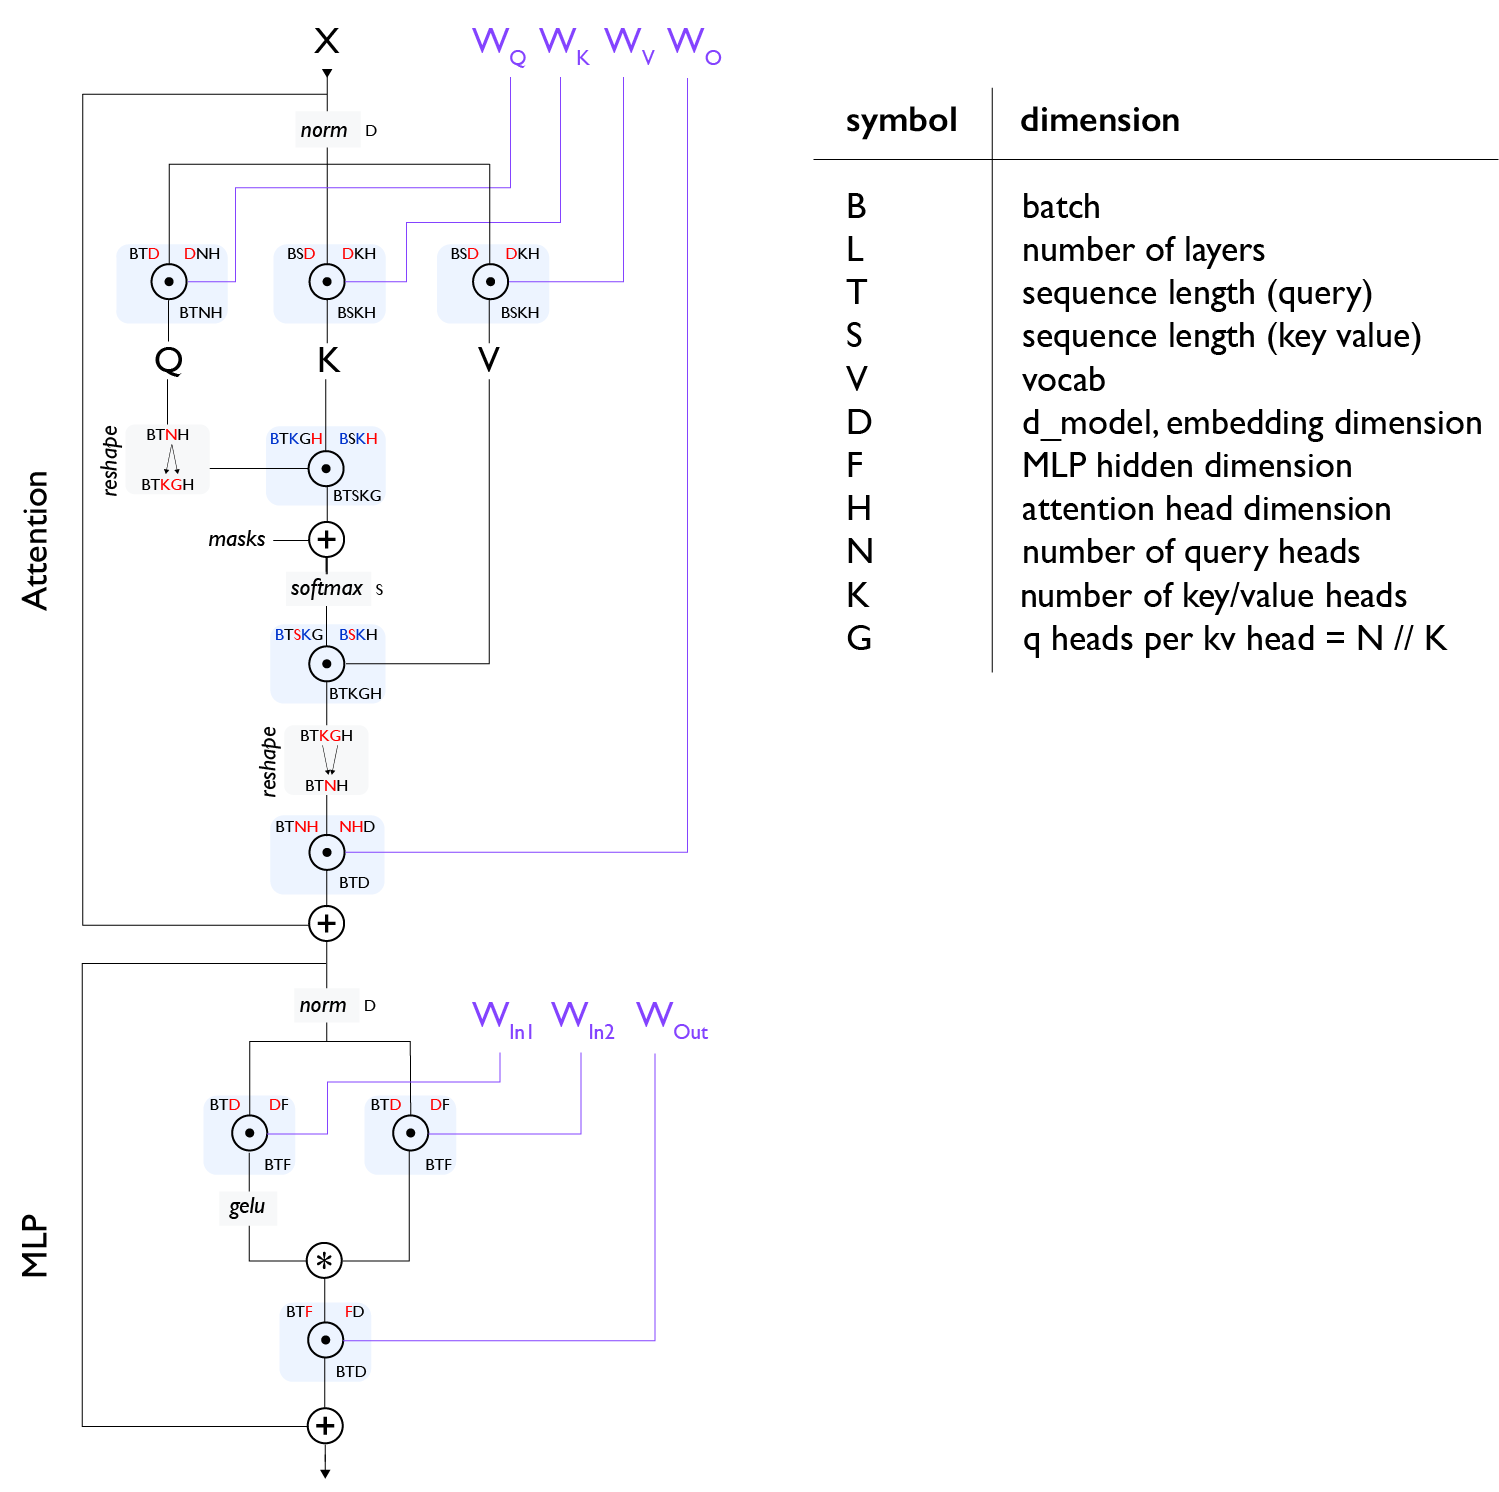
图3: 一个标准 Transformer 层,其中每个矩阵乘法 (matmul) 显示为圆内的点。所有参数(不包括范数)均以紫色显示。 第 4 节 更详细地介绍了此图。
译者补充:图中的 MLP 在做什么? MLP 是多层感知机(Multi-Layer Perceptron),在 Transformer 中通常也称为前馈网络(FFN)。它对每个 token 的特征向量分别进行加工,各个 token 使用同一组权重。注意力模块负责让不同位置的 token 交换信息;MLP 则进一步变换每个 token 自身的特征。
图 3 画的是一种带门控的 MLP:归一化后的输入
h分成两路,分别与W_in1、W_in2做矩阵乘法,都从D维投影到中间的F维;第一路经过 GELU 非线性激活,再与第二路逐元素相乘;最后乘以W_out,从F维投影回D维。用一行表达就是:MLP(h) = (GELU(h @ W_in1) ⊙ (h @ W_in2)) @ W_out。这里@是矩阵乘法,⊙是对应元素相乘;图中的圆点表示前者,圆圈里的星号表示后者。可以把它理解为“扩展特征 → 非线性加工与门控 → 压回原维度”。两条分支相乘,使一路能调节另一路中哪些特征通过。最下方的加号是残差连接:把 MLP 的输出加回该子层的输入;它在上述 MLP 公式之外。
第 5 节:训练 和 第 7 节:推理 是本书的核心,我们在其中讨论基本问题:给定一定大小和一定数量芯片的模型,如何并行化我的模型以保持“强缩放”状态?这是一个简单的问题,但答案却出奇地复杂。在较高层面上,有四种主要并行技术用于在多个芯片上分割模型(数据DP、张量TP、管道PP和专家EP),以及许多其他技术来减少内存需求(重新实现、优化器/模型分片(又名 ZeRO)、主机卸载、梯度累积)。我们将在这里讨论其中的许多内容。
我们希望在读完这些部分后,你应该能够自己选择新的架构或设置。 第 6 节 和第 8 节 是将这些概念应用到流行的开源模型 LLaMA 3 的实用教程。
最后,第 9 节 和第 10 节 了解如何在 JAX 中实现其中一些想法,以及如何在出现问题时分析和调试代码。 第 12 节 是一个新的部分,也深入探讨 GPU。
自始至终,我们都试图给你一些问题,让你自己去工作。请毫无压力地阅读所有部分或按顺序阅读。请留下反馈。目前,这是一个草案,并将继续修改。谢谢你!
我们要感谢 James Bradbury 和 Blake Hechtman,他们提出了本书中的许多想法。
不再多说,现在进入讨论 TPU Roofline 的第 1 章。
章节链接
本系列可能比需要的时间长,但我们希望这不会阻止你。前三章是预备部分,如果你已经熟悉这些材料,可以跳过,尽管它们介绍了稍后使用的符号。最后三个部分可能是最实用的,因为它们解释了如何使用真实模型。
第 1 部分:预备知识
第 1 章:屋顶线分析简介。算法受到三个因素的限制:计算、通信和内存。我们可以使用这些来估计我们的算法的运行速度。
第 2 章:如何思考 TPU。 TPU 是如何工作的?这对我们可以训练和服务的模型有何影响?
第 3 章:分片矩阵及其乘法。在这里,我们通过我们最喜欢的操作(分片)矩阵乘法来解释模型分片和多 TPU 并行性。
第 2 部分:变形金刚
第 4 章:你需要了解的所有 Transformer 数学知识。 Transformer 在前向和反向传播中使用了多少次 FLOP?你能计算出参数的数量吗?它的KV缓存的大小?我们在这里进行数学计算。
第 5 章:如何并行化 Transformer 进行训练。 FSDP。威震天分片。管道并行性。给定一定数量的芯片,如何尽可能有效地训练给定批量大小的给定大小的模型?
第 6 章:在 TPU 上训练 LLaMA 3。我们如何在 TPU 上训练 LLaMA 3?需要多长时间?需要花多少钱?
第 7 章:关于 Transformer 推理的一切。一旦我们训练了模型,我们就必须为它提供服务。推理增加了一个新的考虑因素——延迟——并改变了内存格局。我们将讨论分解服务的工作原理以及如何考虑 KV 缓存。
第 8 章:在 TPU 上提供 LLaMA 3。在 TPU v5e 上提供 LLaMA 3 服务需要多少钱?延迟/吞吐量的权衡是什么?
第 3 部分:实用教程
第 9 章:如何分析 TPU 代码。真正的法学硕士绝不会像上述理论那么简单。在这里,我们解释 JAX + XLA 堆栈以及如何使用 JAX/TensorBoard 分析器来调试和修复实际问题。
第 10 章:在 JAX 中对 TPU 进行编程。 JAX 提供了一堆神奇的 API 用于并行计算,但你需要知道如何使用它们。有趣的例子和有效的问题。
第 4 部分:结论和奖励内容
第 11 章:结论和进一步阅读。关于 TPU 和 LLM 的结束思考和进一步阅读。
第 12 章:如何思考 GPU。关于 GPU、它们如何工作、如何联网以及它们的屋顶线与 TPU 有何不同的额外部分。
译文与许可:本章是基于固定版本
173fb0851d7e654872f0327aff2e17607cf24106的机器辅助中文初译,并非逐句人工精校。原文与配图基于 MIT License 发布。Copyright (c) 2022 Maruan Al-Shedivat;Copyright (c) 2025 Google LLC。完整许可见 MIT License。