原著:Jacob Austin 等,Google DeepMind,《How to Scale Your Model》。本章原文。原文固定版本:
173fb0851d7e,获取日期:2026-10-26,MIT 许可。
本章为完整范围的机器辅助中文初译
简介:算法在硬件上运行时,会受到三方面限制:每秒能够完成多少次运算(OPs/s)、每秒能够搬运多少字节(bytes/s),以及总共能保存多少字节。这些 Roofline 约束可以帮助我们估算一次计算的耗时上下界。
时间都去哪儿了?
让我们从一个非常简单的问题开始:为什么算法需要 50 毫秒而不是 50 秒或 5 毫秒?模型中实际发生了什么需要花费大量时间?我们预计需要多长时间?
计算:深度学习模型实际上是一堆矩阵乘法,每个乘法都由浮点乘法和加法“运算”(FLOP)组成。我们的加速器速度决定了计算所需的时间:
$$\begin{equation}
T_\text{math} = \frac{\text{Computation FLOPs}}{\text{Accelerator FLOPs/s}}
\end{equation}$$
例如,NVIDIA H100 的 bf16 峰值算力约为 9.89e14 FLOPs/s,TPU v6e 约为 9.1e14 FLOPs/s。(原注:bf16 是 bfloat16 的缩写,是机器学习中常用的 16 位浮点格式。)(原注:H100 和 B200 通常只能达到标称峰值算力的约 80%~85%;TPU 正常使用时可以接近 95%。)因此,执行 1e12 次浮点运算,H100 大约需要 1e12 / 9.89e14 = 1.01ms,TPU v6e 大约需要 1e12 / 9.1e14 = 1.1ms。(原注:两类芯片价格不同,这里没有按成本归一化比较。)
芯片内的通信: 在加速器内,张量需要在加速器内存 (HBM) 和计算核心之间传输。你会看到这个链接的带宽被称为“HBM带宽”。(原注:NVIDIA也称之为“内存带宽”。)在H100上,这大约是3.35TB/s,在TPU v6e上这大约是1.6TB/s。
芯片之间的通信:当我们跨多个加速器分发模型时,张量经常需要在它们之间传输。我们的硬件上通常有几个选项(ICI、DCN 和 PCIe),每个选项都有不同的带宽。
无论通信是在芯片内部还是芯片之间,我们都会以字节/秒为单位进行测量,并通过以下方式估计总通信时间:
$$\begin{equation}
T_\text{comms} = \frac{\text{Communication Bytes}}{\text{Network/Memory Bandwidth Bytes/s}}
\end{equation}$$
通常,单芯片计算可以与芯片内、芯片间通信重叠,但并非总能做到。因此,计算时间与通信时间中的较大值可以作为训练或推理时间的下界,两者之和则给出上界。实践中,通常围绕较大值优化:推导更简单,而且通过重叠通信与计算,往往可以接近这个下界。又因为 $T_\text{math} + T_\text{comms} \leq 2 * \max(T_\text{math}, T_\text{comms})$,上下界最多相差两倍。若要进一步提高估算精度,就需要结合具体模型与目标系统的性能记录,计入实际可重叠的区间和额外开销。
$$\begin{equation}
T_\text{lower}=\max(T_\text{math}, T_\text{comms})
\end{equation}$$
$$\begin{equation}
T_\text{upper} = T_\text{math} + T_\text{comms}
\end{equation}$$
假设通信与计算可以完全重叠。当 $T_\text{math} > T_\text{comms}$ 时,计算更慢,硬件算力能够充分利用,称为“计算受限”(compute-bound)。当 $T_\text{comms} > T_\text{math}$ 时,通信更慢,称为“通信受限”(communication-bound);一部分算力会闲置,等待数据传来。(原注:本书会根据上下文交替使用 communication-bound、comms-bound、memory-bound 和 bandwidth-bound。)判断一个操作受计算还是通信受限,可以考察它的算术强度(arithmetic intensity,也称 operational intensity)。
定义: 算法的算术强度由它执行的总 FLOP 与它需要通信的字节数的比率给出 - 无论是在芯片内还是在芯片之间。
$$\begin{equation}
\text{Arithmetic Intensity} = \frac{\text{Computation FLOPs}}{\text{Communication Bytes}}
\end{equation}$$
算术强度表示每搬运一字节数据可以执行多少次浮点运算。粗略地说,算术强度较高时,$T_\text{math}$ 相对于 $T_\text{comms}$ 较大,硬件的大部分算力都能用上。反过来,更多时间花在搬数据上,计算单元就会等待。两种状态的分界是硬件的临界算术强度,也就是峰值 FLOPs/s 除以带宽;原文称它为硬件的“峰值算术强度”。
$$\begin{align*}
T_\text{math} > T_\text{comms} \Leftrightarrow \frac{\text{Computation FLOPs}} {\text{Accelerator FLOPs/s}} > \frac{\text{Communication Bytes}}{\text{Bandwidth Bytes/s}} & \[0.5em]
\Leftrightarrow \frac{\text{Computation FLOPs}}{\text{Communication Bytes}} > \frac{\text{Accelerator FLOPs/s}}{\text{Bandwidth Bytes/s}} & \[0.5em]
\Leftrightarrow \text{Intensity}(\text{Computation}) > \text{Intensity}(\text{Accelerator}) & \
\end{align*}$$
数量 $\text{Intensity}(\text{Accelerator})$ 是我们的加速器达到峰值 FLOPs/s 的算术强度。 对于TPU v5e MXU,这大约是240 FLOPs/byte,因为TPU可以执行1.97e14 FLOPs/s并从HBM加载8.2e11 bytes/s。(原注:MXU是TPU上的矩阵乘法单元。我们在这里指定这一点是因为 TPU 有其他加速器,如 VPU,负责具有不同峰值 FLOPs/s 的元素操作。)这意味着如果算法的算术强度低于 240 FLOPs/字节,它将受到字节加载的限制,因此我们不会充分利用我们的硬件。(原注:只有当算法从 HBM 加载其权重并在 MXU 中运行时,这才是正确的。正如我们将在下一节中讨论的,我们有时可以将参数存储在具有更高带宽的 VMEM 中。许多算法也在 VPU 中运行,它们具有不同的性能特征。)让我们看一个这样的例子:
示例(点积):要计算bfloat16精度的两个向量的点积x • y: bf16[N], bf16[N] → bf16[1],我们需要从内存加载$x$和$y$,每个都有$2 * N = 2N$字节,执行$N$ 乘法和 $N-1$ 加法,并将 $2$ 字节写回 HBM
$$\begin{equation}
\text{Intensity}(\text{dot product}) = \frac{\text{Total FLOPs}}{\text{Total Bytes}} = \frac{N + N - 1}{2N + 2N + 2} = \frac{2N - 1}{4N + 2} \rightarrow \frac{1}{2}
\end{equation}$$
如 $N\rightarrow\infty$。因此,点积的算术强度为 $\frac{1}{2}$,或者换句话说,点积对每个加载的字节进行 0.5 次浮点运算。这意味着我们的算术强度低于我们的硬件,我们将受到通信受限。(原注:上面的 240 数字在这里不是正确的比较,因为正如你将在下一节中看到的,点积是在 VPU 而不是 MXU 上执行的。 TPU v5p VPU 每个核心每秒可以执行大约 7e12 FLOPs,因此其临界强度约为 3,这意味着我们在这里仍然受到一定程度的通信受限。不管怎样,我们的强度低且恒定的事实意味着在大多数硬件上很难受到计算受限。)
可视化屋顶线
我们可以使用屋顶线图来可视化内存和计算之间的权衡,该图绘制了硬件上算法可达到的峰值 FLOPs/s(吞吐量)(y 轴)与算法的算术强度(x 轴)的关系。这是一个双对数图示例:
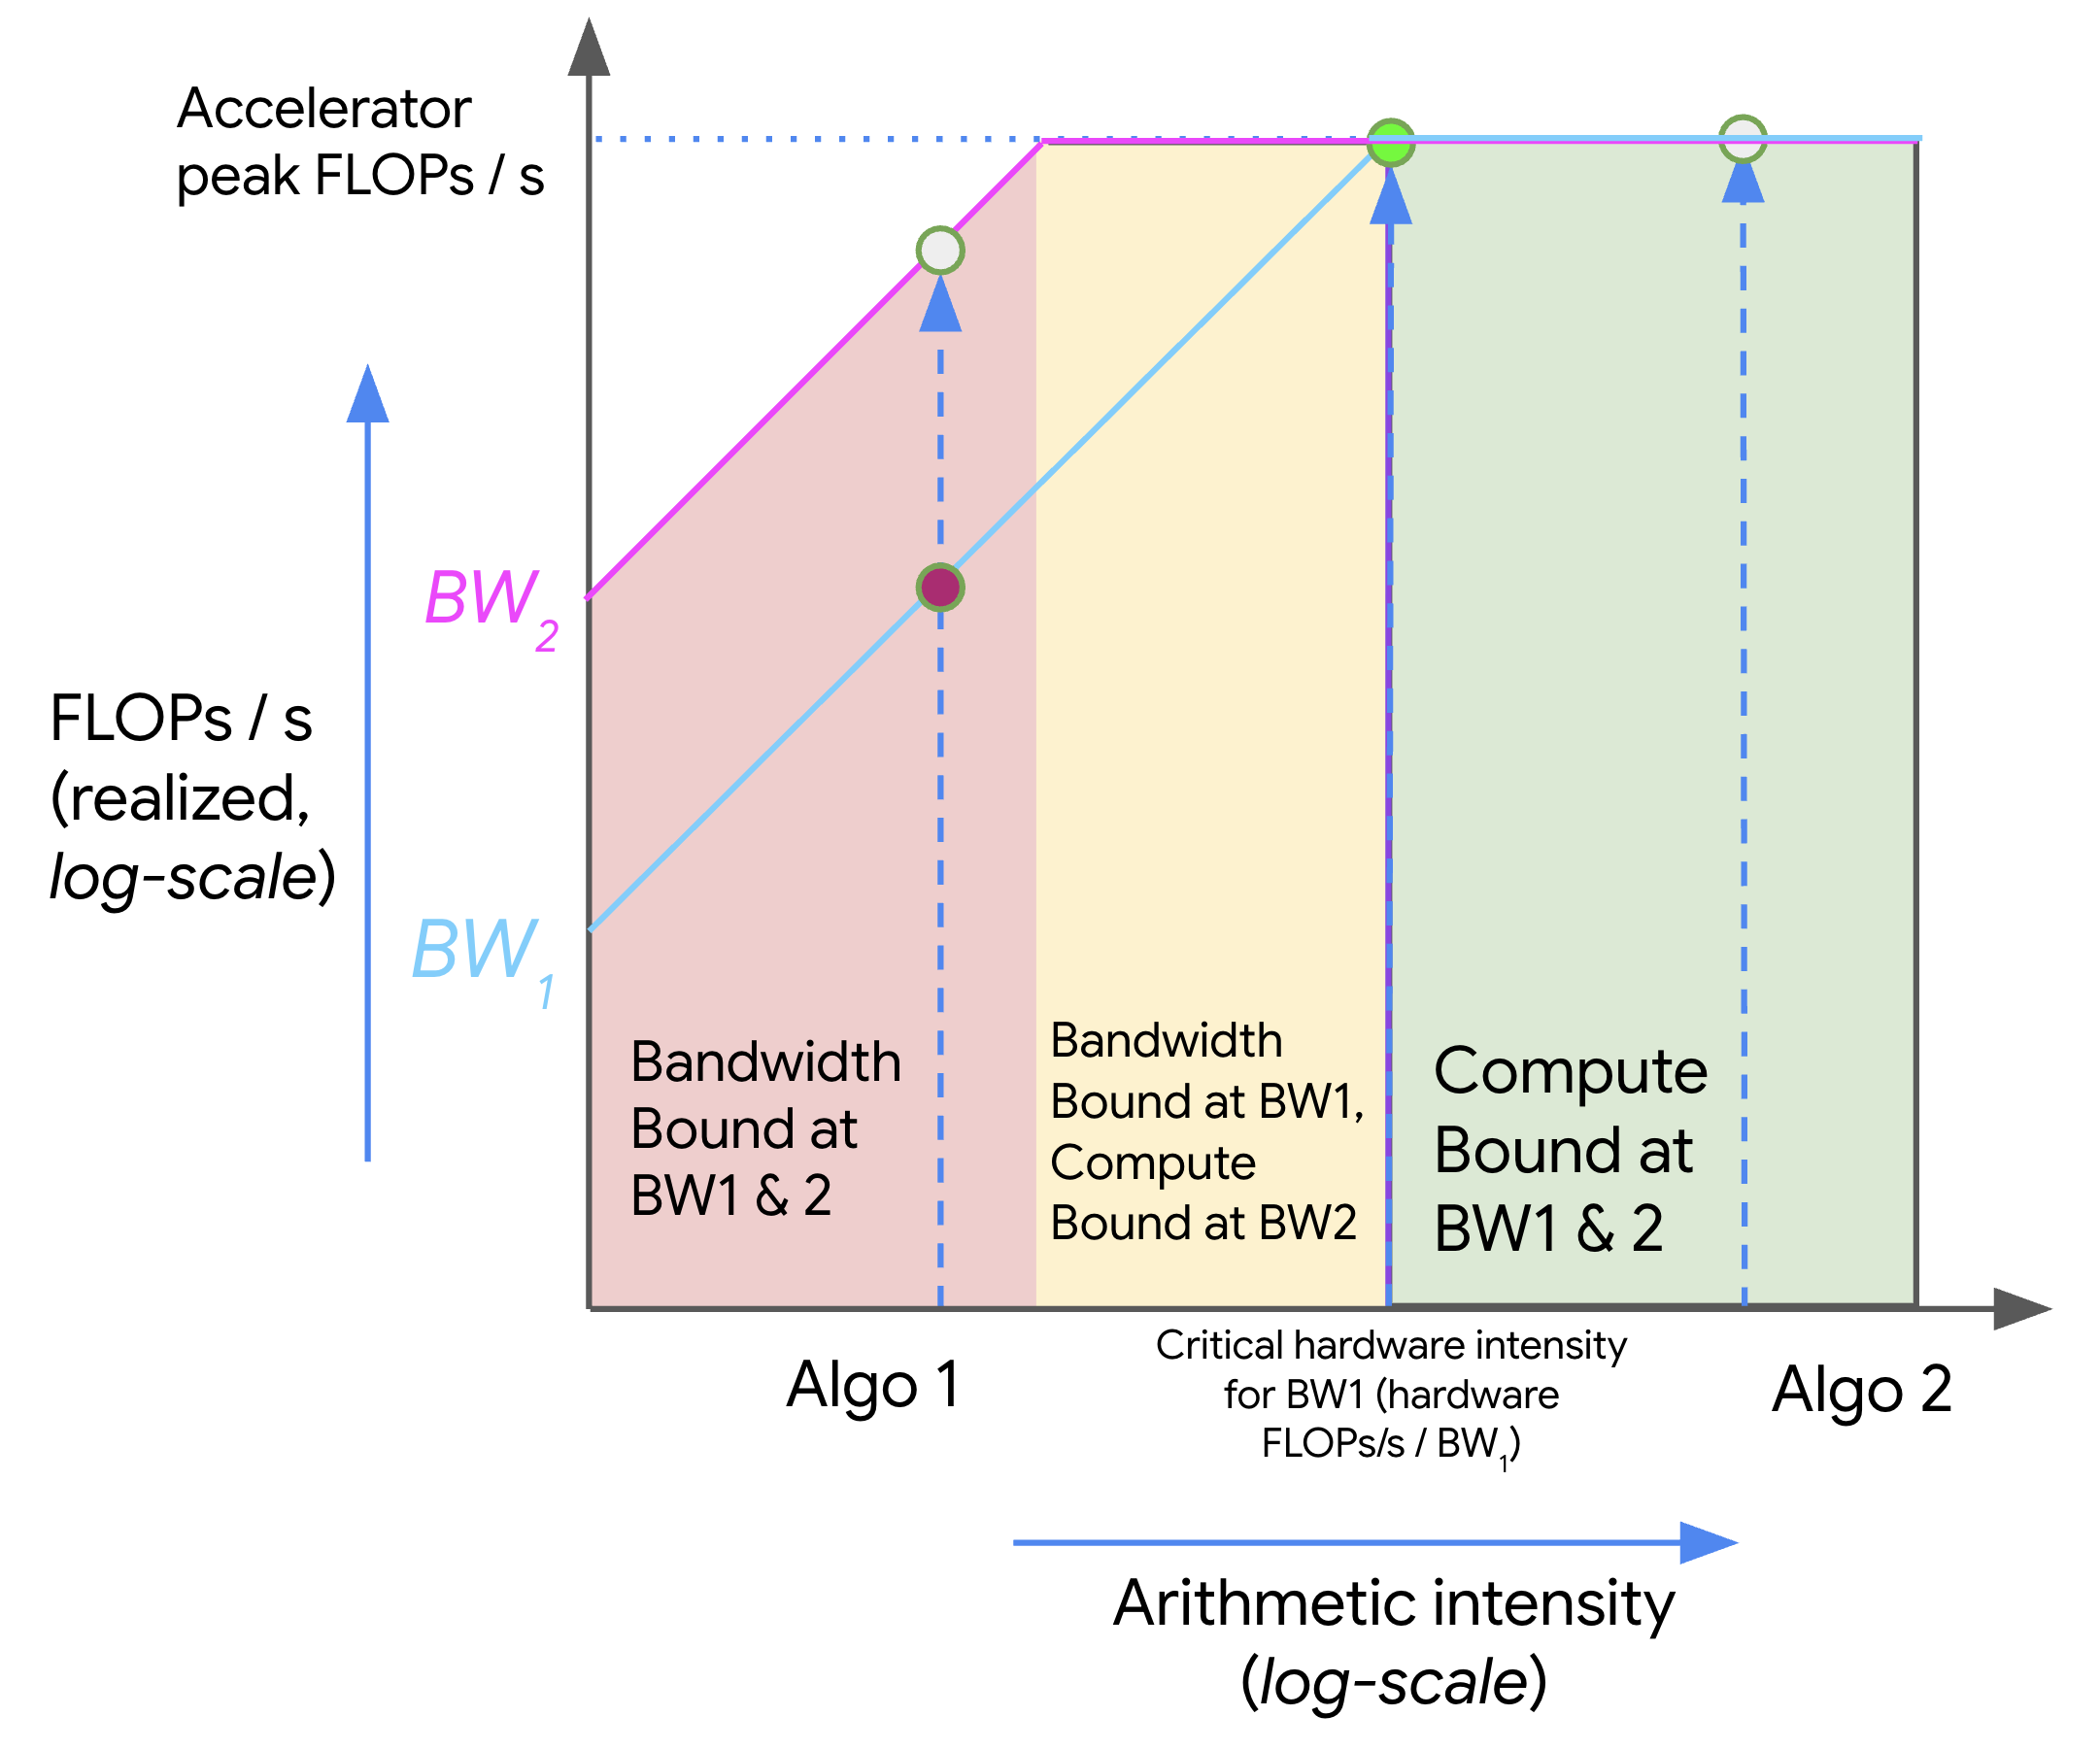
图: 屋顶线图示例,显示具有不同算术强度的两种算法(算法 1 和算法 2)以及不同带宽(BW1 和 BW2)下相应的理论峰值吞吐量。在红色区域中,算法在两个带宽上都受到带宽受限,并且浪费了硬件峰值 FLOPs/s 的一部分。黄色区域仅在较低带宽 (BW1) 处受带宽受限。绿色区域在所有带宽上都受计算受限。在这里,我们使用加速器的峰值 FLOPs/s,增加带宽或提高强度没有任何好处。
上面,随着强度的增加(从左到右),我们最初看到算法的性能(以 FLOPs/s 为单位)线性增加,直到我们达到硬件的关键算术强度,在 TPU v5e 的情况下为 240。任何强度较低的算法都会受到带宽 (BW) 的限制,并受到峰值内存带宽(以红色显示)的限制。右侧的任何算法都将充分利用我们的 FLOP(以绿色显示)。此处,算法 1 受通信受限,仅使用总硬件 FLOPs/s 的一小部分。算法 2 受计算受限。我们通常可以通过增加算法的算术强度或增加可用的内存带宽(从 BW1 移动到 BW2)来提高算法的性能。
矩阵乘法
让我们看看矩阵乘法(又名 matmul)。给定两个矩阵 $X$ 和 $Y$,我们可以写成 $X * Y \rightarrow Z$,其中 $X$ 的形状为 $\text{bf16}[B, D]$,$Y$ 的形状为 $\text{bf16}[D, F]$,$Z$ 的形状为$\text{bf16}[B, F]$。为了进行 matmul,我们需要加载 $2DF + 2BD$ 字节,执行 $2BDF$ FLOP,然后写回 $2BF$ 字节。(原注:从技术上讲,我们执行 $BF \times (2D - 1)$ FLOP,但这已经足够接近了。这来自 $BDF$ 乘法和 $BF * (D-1)$ 加法。第 4 节有更多细节。) (原注:虽然 matmul 的输出在技术上是 float32,但我们通常在复制回 HBM 之前将其转换为 bfloat16。) 因此:
$$\begin{equation}
\text{Intensity}(\text{matmul}) = \frac{2BDF}{2BD + 2DF + 2BF} = \frac{BDF}{BD + DF + BF}
\end{equation}$$
如果我们假设我们的“批量大小”$B$ 相对于 $D$ 和 $F$ 较小,我们可以得到一个很好的简化。然后我们得到
$$\begin{equation}
\frac{BDF}{BD + DF + BF} \approx \frac{BDF}{DF} = B
\end{equation}$$
$$\begin{equation}
\text{Intensity}(\text{matmul}) > \text{Intensity}(\text{TPU}) \implies B > \frac{1.97e14}{8.20e11} = 240
\end{equation}$$
对于这里讨论的 Transformer 矩阵乘法,这个近似通常是合理的:每个模型副本一次处理的 token 数往往满足 $B < 1024$(注意,这里数的是 token,不是序列条数),而特征维度通常满足 $D$ 和 $F > 8000$。因此,在上述硬件和精度假设下,每个模型副本一次处理的 token 数超过约 240 时,矩阵乘法通常就会从 HBM 带宽受限转为计算受限。
(原注:这里强调“每个模型副本”,是因为一份模型权重也可以分片存放在多块芯片上。在这里采用的理想化模型中,增加参与矩阵乘法的芯片,会按相同比例增加可用算力和 HBM 带宽,因此两者的比值不变,临界 token 数仍应按每份独立的模型权重副本计算。)
译者补充:“一个副本”是一份逻辑上完整的模型权重,不一定只占一块芯片。例如,8 块 GPU 共同保存并计算一份分片模型,它们合起来才是一个副本。这里的 240 是相对于 HBM 带宽的估算,尚未考虑芯片之间的通信;不能据此断言整个分布式模型一定计算受限。
要点:在本节的近似条件下,要让 bf16 矩阵乘法在多数 TPU 上进入计算受限状态,每个模型副本的批量需要超过约 240 个 token。
(原注:这里的批量按 token 数计算,不是通常所说的“一个批次包含多少条序列”。许多 Roofline 估算主要取决于参与计算的 token 总数,而不在于这些 token 来自同一条序列还是不同序列。例如,一个批次有 512 条序列,每条长 4096 个 token,则全局批量为 512 * 4096 = 2,097,152 个 token,约为 2M。如果把这些 token 的工作量均匀分配到 2048 块 GPU 上,平均每块 GPU 对应 2,097,152 / 2048 = 1024 个 token,即约 1k token。)
译者补充:序列、长度与批量的区别
一条序列(sequence)是一串有顺序的 token,例如一段分词后的文本。序列长度(sequence length)是这串 token 的数量;按序列计量的批量大小(batch size)则是一个批次包含多少条这样的序列。
对这里逐 token 应用同一权重矩阵的运算,可以把“序列条数 × 序列长度”合并成矩阵的行数,所以推导中的
B按 token 数计量。注意力还要考虑序列内部 token 之间的关系,不能一概只看 token 总数。原例的 1k 是按 GPU 数均分得到的工作量估算,不代表任意并行方案下,每个模型副本的批量也一定是 1k。若多块 GPU 共同组成一个模型副本,就要按副本数另算。并且,只做数据并行、每个副本处理完整序列时,不能把 512 条序列直接分给 2048 个副本;上述均分还需要相应的分片方式支持。
不过,这条经验规则有适用条件,下面的习题会进一步讨论,尤其是量化带来的变化。例如,激活值可以用较低精度存储,而实际运算仍采用原来的较高精度;此时,数据搬运量与计算吞吐量不一定按相同比例变化,临界批量也需要重新计算。尽管如此,“需要足够多的 token 才能充分利用矩阵计算单元”仍是值得记住的结论。对于原文这里讨论的 GPU 配置,临界值略高,接近 300 个 token,但基本思路相同。
此外,实际执行时通常会把一次大矩阵乘法拆成多次小矩阵乘法,因此分块(tile)的尺寸也会影响性能。
(原注:大型矩阵乘法需要分成能够放进高速片上存储器 VMEM/SMEM/TMEM 的小块。不同小块的计算可能重复读取同一份数据,因此,前面假设只需搬运 $O(N^2)$ 字节的估算并不总是成立。考虑一个 $(m, k) \cdot (k, n)$ 矩阵乘法,分块尺寸为 $bm$、$bk$、$bn$。令 $tm = m / bm$,其余分块数量同理。总 FLOPs 为 $2 \cdot tm \cdot tn \cdot tk \cdot bm \cdot bn \cdot bk$,总搬运字节数为 $2 \cdot tm \cdot tn \cdot (tk \cdot (bm \cdot bk + bk \cdot bn) + bm \cdot bn)$。忽略最后一项后,算术强度为 $bm \cdot bn / (bm + bn)$,形式与上面的推导类似。)
我们将在下一章进一步讨论 GPU 和 TPU 的底层实现细节。
网络通信屋顶线
到目前为止,我们讨论的所有屋顶线都是内存带宽屋顶线,_全部在单个芯片内_。这不应该被视为规则。事实上,我们在本书中关注的大部分内容都涉及芯片之间的通信:通常是矩阵乘法,涉及跨多个 TPU 分片的矩阵。
举一个有点人为的例子,假设我们想要将两个大矩阵 $X\sim \text{bf16}[B, D]$ 和 $Y \sim \text{bf16}[D, F]$ 相乘,它们均匀地分布在 2 个 TPU/GPU 上(沿着 $D$ 维度)。为了进行此乘法(正如我们将在第 3 节 中看到的),我们可以将每个 TPU 上每个矩阵的一半(TPU 0 上的 Z0 = X[:, :D // 2] @ Y[:D // 2, :] 和 TPU 1 上的 Z1 = X[:, D // 2:] @ Y[D // 2:, :])相乘,然后将所得的“部分和”复制到另一个 TPU 并将它们相加。假设我们可以在每个方向复制 4.5e10 字节/秒,并在每个芯片上执行 1.97e14 FLOP/秒。什么是 $T_\text{math}$ 和 $T_\text{comms}$?
$T_\text{math}$ 显然是以前的一半,因为每个 TPU 都做了一半的工作,即(原注:我们忽略了将两个部分和加在一起所需的 FLOP(另一个 BF 加法),但这基本上可以忽略不计。)
$$T_\text{math} = \frac{2BDF}{2 \cdot \text{Accelerator FLOPs/s}} = \frac{BDF}{1.97e14}$$
那么 $T_\text{comms}$ 呢?现在指的是芯片之间的通信时间!这只是发送的总字节数除以网络带宽,即
$$T_\text{comms} = \frac{2BF}{\text{Network Bandwidth}} = \frac{2BF}{4.5e10}$$
因此,当 $$\text{Intensity}(\text{matmul (2-chips)}) > \text{Intensity}(\text{TPU w.r.t. inter-chip network})$$ 或同等地当 $\frac{BDF}{2BF} = \frac{D}{2} > \frac{1.97e14}{4.5e10} = 4377$ 或 $D > 8755$ 时,我们会受到计算受限(现在相对于芯片间网络)。请注意,与以前不同,临界阈值现在取决于 $D$ 而不是 $B$!试着想想为什么会这样。这只是一个这样的例子,但我们强调,这种屋顶线对于了解何时可以跨多个 TPU 并行操作至关重要。
工作中的一些问题
问题 1 [int8 matmul]: 假设我们想要进行 matmul $X[B, D] \cdot_D Y[D, F] \rightarrow Z[B, F]$(原注:在这里和全文中,我们将使用符号 $A \cdot_D B$ 来指示乘法正在 D 维度上执行收缩。采用 int8 精度(每个参数 1 个字节)而不是 bfloat16(每个参数 2 个字节),因为 TPU/GPU 可以在较低精度下更快地进行 matmuls。
- 需要从内存加载多少字节?有多少需要写回内存?
- 总共执行了多少次 OP?
- 算术强度是多少?
- $T_\text{math}$ 和 $T_\text{comms}$ 的屋顶线估计是多少?整个操作的运行时间的合理上限和下限是多少?
假设我们的 HBM 带宽是 8.2e11 字节/秒,int8 峰值 OPs/秒是 3.94e14(大约是 bfloat16 的 2 倍)。
答案:
- 因为我们将参数存储在 int8 中,所以每个参数有 1 个字节,因此我们有从 HBM 加载的 $$BD + DF$$ 字节和写回的 $$BF$$ 字节。
- 这与 bfloat16 中的相同,但理论上 int8 OPs/s 应该更快。所以这仍然是 $2BDF$ OP。
- 算术强度为$$2BDF / (BD + DF + BF)$$。如果我们对 $$B \ll D$$ 和 $$B \ll F$$ 做出与上面相同的假设,我们得到的算术强度为 $$2B$$,这意味着我们的规则变为 $B > \text{HBM int8 arithmetic intensity} / 2$。使用给定的数字,该 int8 强度为
3.94e14 / 8.2e11 = 480,因此规则为 $B > 480 / 2 = 240$。请注意,这基本上没有改变! - $$T_\text{math} = 2BDF / 3.94e14$$ 和 $$T_\text{comms} = (BD + DF + BF) / 8.2e11$$,因此合理的下限是 $$\max(T_\text{math}, T_\text{comms})$$,上限是 $$T_\text{math} + T_\text{comms}$$。
问题 2 [int8 + bf16 matmul]: 在实践中,我们经常进行不同的权重与激活量化,因此我们可能以非常低的精度存储权重,但以更高的精度保持激活(和计算)。假设我们想要在 int8 中量化权重,但将激活(和计算)保留在 bfloat16 中。在多大的批量大小下,我们会受到计算受限?假设 1.97e14 bfloat16 FLOPs/s。
提示:这具体意味着 bf16[B, D] * int8[D, F] -> bf16[B, F],其中 $B$ 是“批量大小”。
答案:
再次假设 B 很小,我们有 2BDF bfloat16 FLOP,但只有 DF 权重(而不是 bfloat16 中的 2DF)。这意味着当 $$2B > 240$$ 或 $$B > 120$$ 时我们将受到计算受限。这个值要低得多,这意味着如果我们可以进行 int8 权重量化(这相当容易做到),但仍然执行 bfloat16 FLOP,那么我们将在效率方面获得有意义的胜利(尽管 int8 OP 会更好)。
问题 3: 采用问题 2 中的设置,为 $F = D = 4096$ 和 $F = D = 1024$ 制作峰值 FLOPs/s 与 $B$ 的屋顶线图。 使用加载的确切字节数,而不是近似值。
答案:
这是有问题的情节:
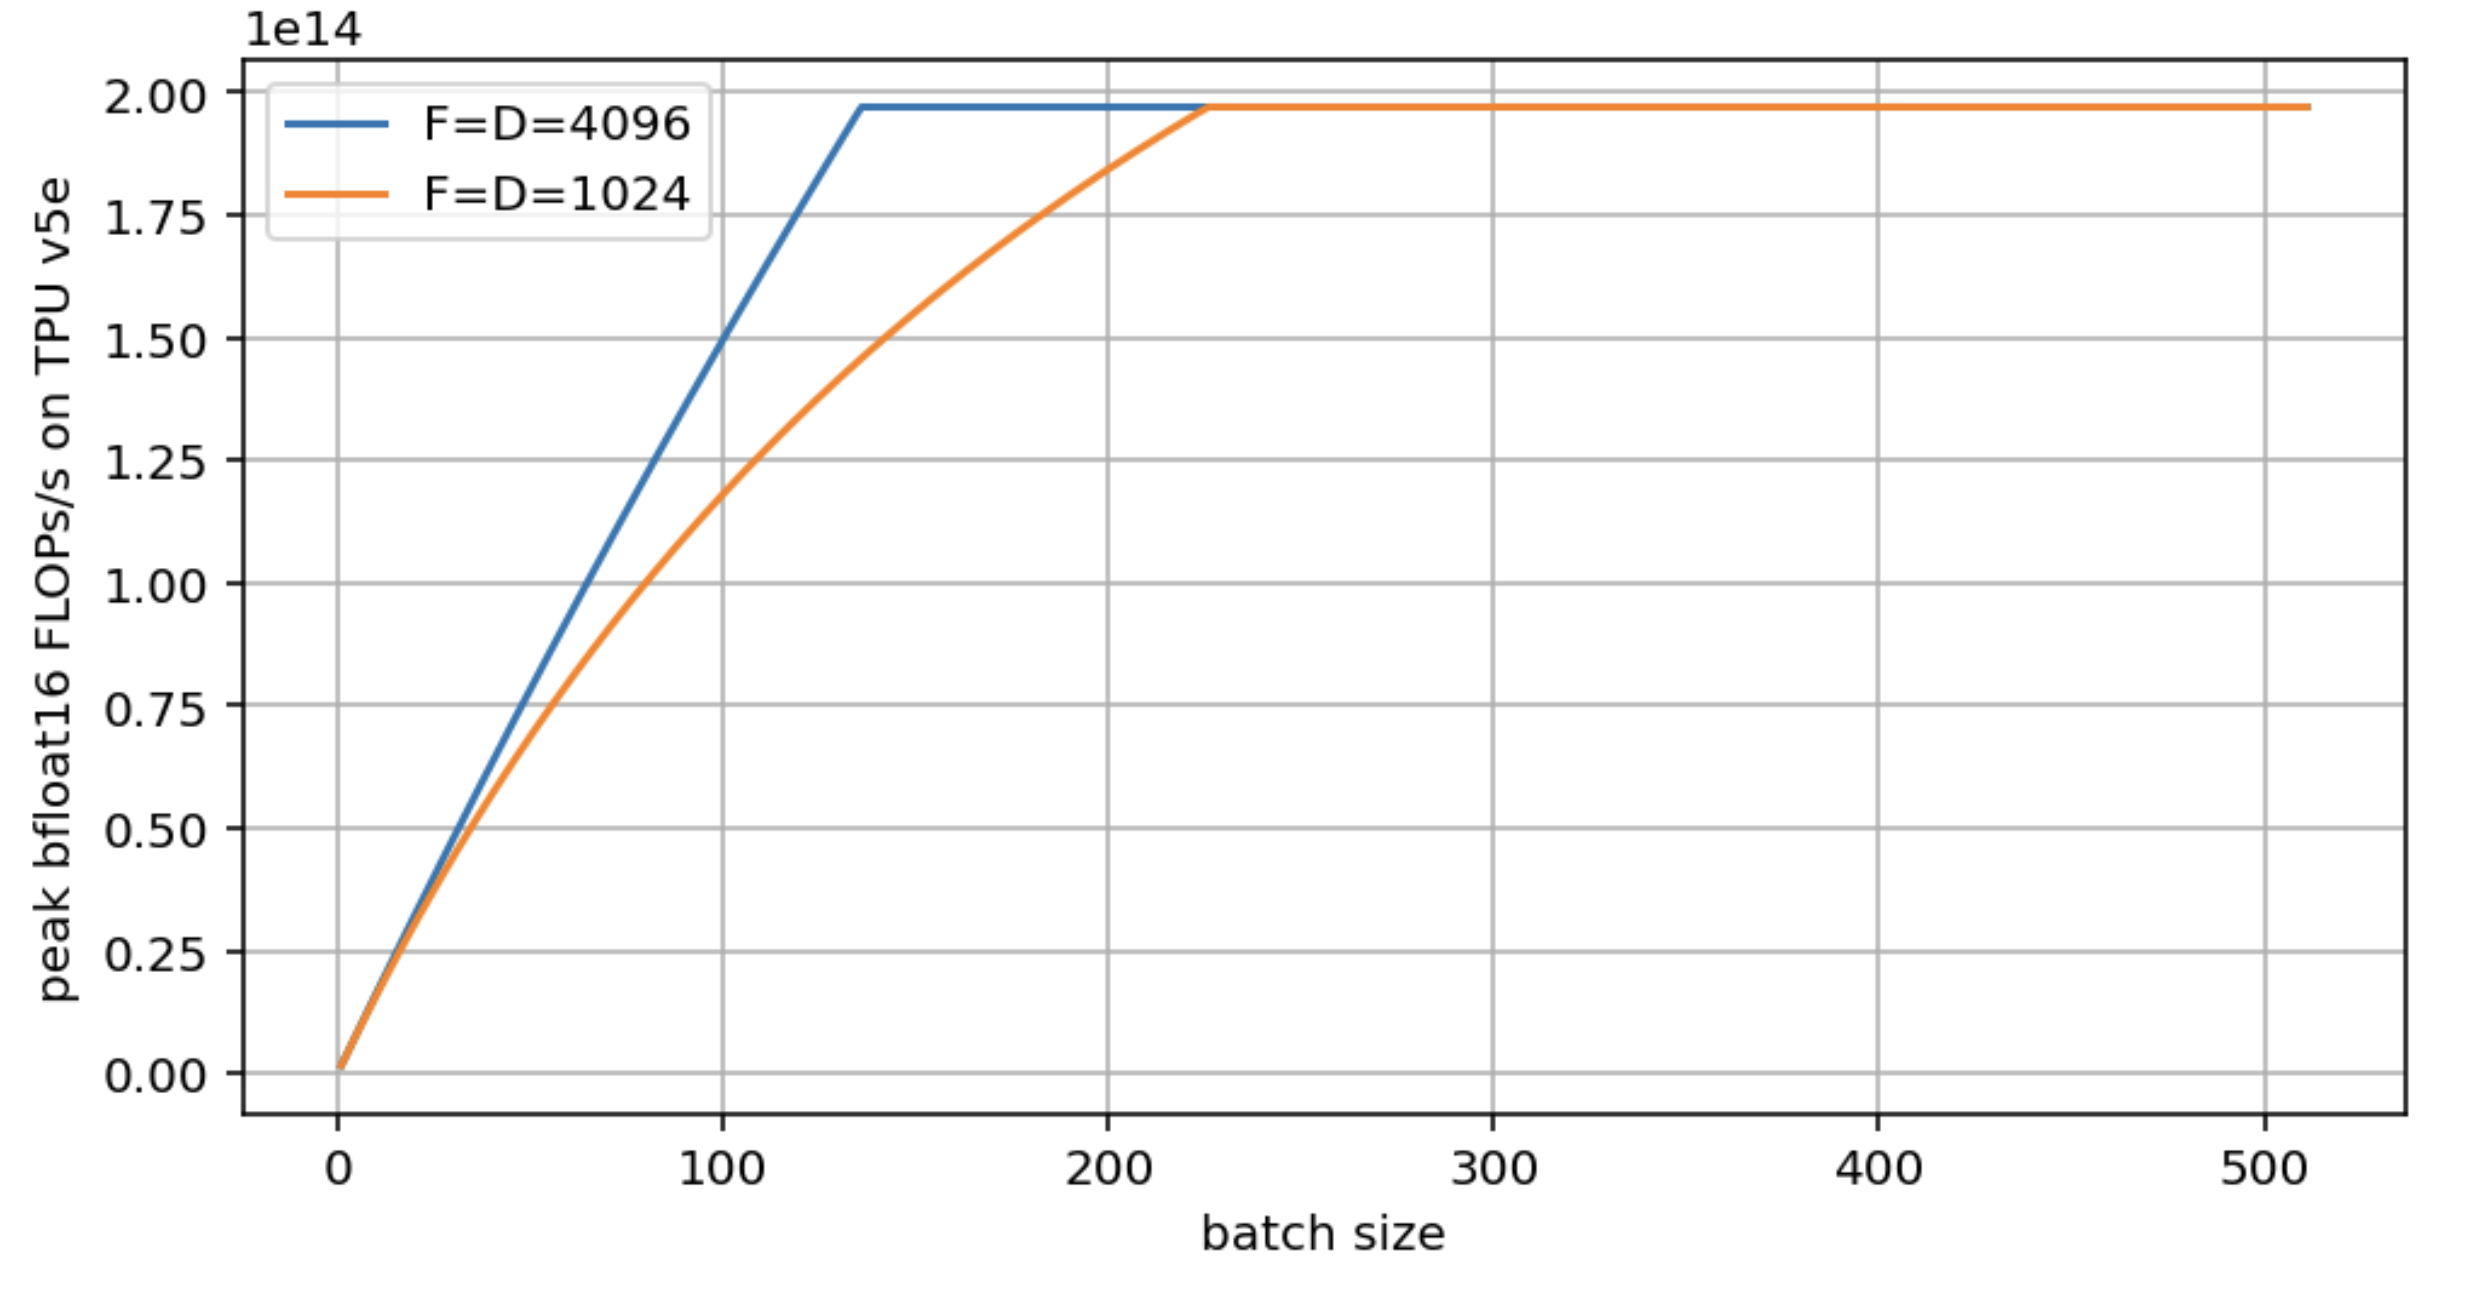
请注意,两种模型最终都达到了峰值硬件 FLOPs/s,但较大的 D/F 更快地达到了这一目标。 D=F=1024 几乎使临界批量大小增加了一倍。生成该图的代码在这里:
import matplotlib.pyplot as plt
import numpy as np

bs = np.arange(1, 512)

def roofline(B, D, F):
  total_flops = 2*B*D*F
  flops_time = total_flops / 1.97e14
  comms_time = (2*B*D + D*F + 2*B*F) / 8.2e11
  total_time = np.maximum(flops_time, comms_time)
  return total_flops / total_time

roofline_big = roofline(bs, 4096, 4096)
roofline_small = roofline(bs, 1024, 1024)

plt.figure(figsize=(8, 4))
plt.plot(bs, roofline_big, label='F=D=4096')
plt.plot(bs, roofline_small, label='F=D=1024')
plt.legend()
plt.xlabel('batch size')
plt.ylabel('peak bfloat16 FLOPs/s on TPU v5e')
plt.grid()
问题 4: 如果我们想要执行 $\text{int8}[B, D] \cdot_D \text{int8}[B, D, F] \rightarrow \text{int8}[B, F]$,我们假设每个批次元素都有不同的矩阵,该怎么办?该操作的算术强度是多少?
答案:
让我们首先查看总的算力和通讯次数。
- 总 FLOP 数:FLOP 数基本相同,因为我们正在做 $$B$$ 独立的 $$[D] \times [D, F]$$ 产品,因此总工作量与单个 $$[B, D] \times [D, F]$$ matmul 相同(这将在第 4 节中详细讨论)。所以这就是 $$2BDF$$。
- 通讯总数:我们这里还有更多通讯:$$BD + BDF + BF$$。
- 因此,我们现在的算术强度实际上是$$2BDF / (BD + BDF + BF)$$。由于分母为 $$BDF$$,因此大致为 $$2$$。因此,这基本上是恒定的,而不是取决于批量大小。这很糟糕,因为这意味着无论如何我们基本上都会受到通信的束缚。
问题 5 [GPU 的内存屋顶线]: 使用 NVIDIA 为 H100 SXM 提供的规格表,计算 bfloat16 矩阵乘法将受到计算受限的批量大小。 请注意,Tensor Core FLOPs 数量是真实值的两倍,因为它们只能通过结构化稀疏性来实现。
答案:
从规格表中,我们看到报告的 bfloat16 FLOPs 值为 1.979e15 FLOPs/s,并带有星号,表示“稀疏”。真实值是没有稀疏性的一半,即 9.89e14 FLOPs/s。内存带宽为3.35TB/s,即3.35e12字节/秒。因此,$B_\text{crit}$ 是 9.89e14 / 3.35e12 = 295,与 TPU 非常相似。
第 1 章到此结束!第 2 章将介绍真实 TPU 如何完成运算和通信。
译文与许可:本章是基于固定版本
173fb0851d7e654872f0327aff2e17607cf24106的机器辅助中文初译,并非逐句人工精校。原文与配图基于 MIT License 发布。Copyright (c) 2022 Maruan Al-Shedivat;Copyright (c) 2025 Google LLC。完整许可见 MIT License。