对应官方原文:Convolutions,JAX Authors。本文覆盖原文的二维卷积、stride、dilation、转置卷积、一维卷积和三维卷积。
卷积可以理解为:用一个小窗口在数据上滑动,每到一个位置,就按同一套权重汇总窗口里的局部信息。 对图像来说,这套权重可以提取边缘、纹理等特征;对声音或时间序列来说,可以捕捉短时间内的变化模式。神经网络中的卷积核通常通过训练学习,下面先用手工设置的核,把计算效果直接画出来。
本文涉及的几个名词,实际上在回答不同的问题:
| 概念 | 调整什么 | 直观效果 |
|---|---|---|
| padding | 输入边界如何补齐 | 控制边缘参与计算的方式与输出尺寸 |
| stride(步幅) | 窗口每次移动多远 | 步幅增大,输出位置变少,分辨率降低 |
| kernel dilation(核膨胀率) | 核内采样点相隔多远 | 用相同数量的权重覆盖更大的输入范围 |
| 转置卷积 | 将输入的贡献分配并累加到输出位置 | 配合合适的步幅和 padding,可以放大空间尺寸 |
| 一维、二维、三维卷积 | 沿几个空间或序列轴滑动 | 分别适合序列、图像、体数据或时空数据 |
这些设置可以组合使用。一维卷积也可以有 stride 和 dilation,二维卷积也可以在保持尺寸的同时扩大采样范围。JAX 的 lax.conv_general_dilated 就是把这些规则统一表达出来的底层接口。
1. 卷积怎样从图像中提取特征
先看单通道的情况。一个 3×3 卷积核有 9 个权重,覆盖输入中的一块 3×3 区域后,把对应位置的数值逐项相乘,再将结果相加,得到输出中的一个数。窗口滑到其他位置时,使用的仍然是这 9 个权重,这就是参数共享。
例如,用下面这个核处理亮度图像:
1   1   0
1   0  -1
0  -1  -1
如果窗口内都是相同亮度,正负权重相互抵消,输出就是 0;如果窗口的一侧亮、另一侧暗,抵消被打破,就会得到正值或负值。这样,均匀区域被弱化,某些方向的亮暗边界更突出。正负号表示边界变化的方向,绝对值反映响应强弱。
深度学习接口中,这类不翻转卷积核的滑动乘加,严格说属于互相关,工程上通常直接称为卷积。本文沿用这一惯例。普通二维卷积常用于图像分类、检测、分割网络中的局部特征提取;训练后的核会形成不同的响应,不局限于这里的边缘检测。
下面准备三个彩色方块作为输入,方便对比边界附近发生了什么:
import matplotlib.pyplot as plt
import numpy as np

import jax.numpy as jnp
from jax import lax

# 二维卷积核:HWIO 布局。
kernel = jnp.zeros((3, 3, 3, 3), dtype=jnp.float32)
kernel += jnp.array([
    [1,  1,  0],
    [1,  0, -1],
    [0, -1, -1],
])[:, :, jnp.newaxis, jnp.newaxis]

# 图像:NHWC 布局。
img = jnp.zeros((1, 200, 198, 3), dtype=jnp.float32)
for k in range(3):
    x = 30 + 60 * k
    y = 20 + 60 * k
    img = img.at[0, x:x + 10, y:y + 10, k].set(1.0)

fig, ax = plt.subplots(1, 2, figsize=(10, 5))
ax[0].imshow(kernel[:, :, 0, 0])
ax[0].set_title("edge conv kernel")
ax[1].imshow(img[0])
ax[1].set_title("original image")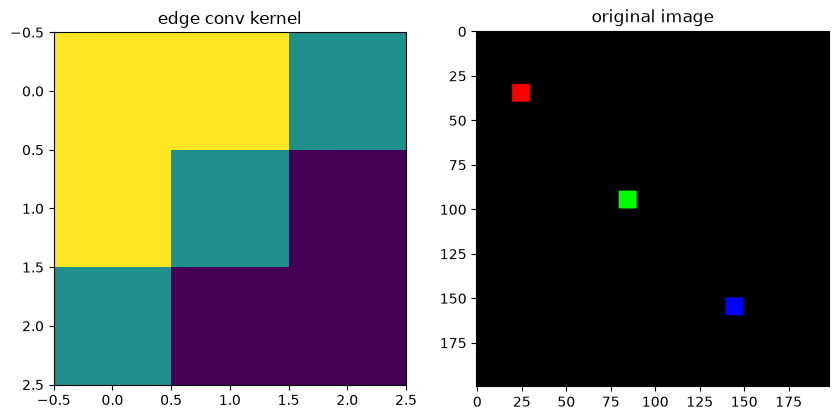
图 1:对角边缘检测核与 NHWC 合成输入图像。图片来自 JAX 官方卷积教程。
这里 img 的 shape 是 [1,200,198,3],表示 1 张高 200、宽 198、含 3 个颜色通道的图像。kernel 的 shape 是 [3,3,3,3]:前两个 3 是窗口高宽,后两个分别是输入通道数和输出通道数。
普通卷积会同时汇总窗口位置和输入通道,每个输出通道各有一套权重。本例为了让图形容易对照,把同一个二维核复制到了所有输入、输出通道组合,所以三个输出通道的结果相同。它会汇总三个颜色通道的边缘响应,不会保留原来的红、绿、蓝颜色。
2. dimension_numbers 定义布局
conv_general_dilated() 的关键参数是 (输入布局, 卷积核布局, 输出布局):
数组的 shape 只给出各维大小,还需要告诉接口哪一维是 batch、哪一维是空间、哪一维是通道。同一个四维数组,可以按 NHWC 存放,也可以按 NCHW 存放;如果布局声明错了,代码解释的数据含义就会改变。
| 字符 | 含义 |
|---|---|
N |
batch |
H、W |
空间高度、宽度 |
C |
通道 |
I、O |
卷积核输入、输出通道 |
dn = lax.conv_dimension_numbers(
    img.shape,       # 只使用 ndim,不使用具体大小
    kernel.shape,
    ("NHWC", "HWIO", "NHWC"),
)
print(dn)
ConvDimensionNumbers(lhs_spec=(0, 3, 1, 2),
rhs_spec=(3, 2, 0, 1), out_spec=(0, 3, 1, 2))("NHWC", "HWIO", "NHWC") 表示输入和输出都把通道放在最后,卷积核则按“高、宽、输入通道、输出通道”排列。打印结果中的 (0,3,1,2) 记录的是 batch、通道和空间维的轴位置,并没有真的执行一次转置。
从 AI Infra 的角度,布局还影响数据访问和底层实现选择。迁移模型或替换算子时,应该同时核对数据实际排列、卷积核排列和布局声明,再比较输出与梯度。仅仅看到 shape 中的数字相同,不能说明两个实现的轴含义相同。
3. 基本二维卷积与 padding
3.1 为什么边界需要 padding
一个 3×3 窗口在图像中央容易放下,移动到边界时,就会有一部分超出输入范围。padding 规定如何处理这部分区域。本例的零填充相当于在图像周围补一圈 0,让窗口也能围绕边缘位置计算。
VALID 不补边,只保留窗口完整落在输入内的位置。对于高宽为 200×198、核为 3×3、stride 为 1 且没有 dilation 的情况,输出会缩小到 198×196。SAME 则自动计算所需补边,在 stride 为 1 时保持输出高宽为 200×198。
保持尺寸常用于需要逐像素对齐的特征处理,也方便残差分支相加。补边值也会参与计算,因此图像边缘的响应可能受到边界假设影响;SAME 表示尺寸规则,不表示输出数值或图像内容不变。
out = lax.conv_general_dilated(
    img, kernel,
    (1, 1),    # window strides
    "SAME",    # padding
    (1, 1),    # lhs/image dilation
    (1, 1),    # rhs/kernel dilation
    dn,
)
print("out shape:", out.shape)  # (1, 200, 198, 3)
plt.imshow(np.array(out)[0, :, :, 0])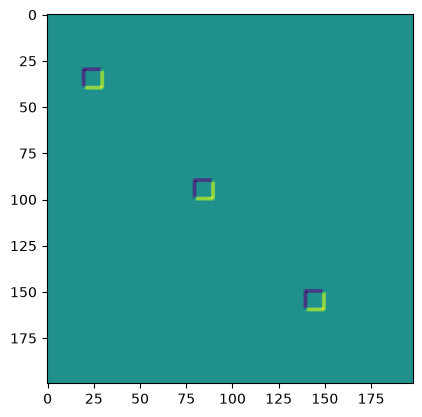
图 2:
SAMEpadding、stride 1 的二维卷积输出。VALID不添加 padding,因此会进一步缩小空间尺寸。
3.2 图里为什么只剩方块边缘
图 2 中,大面积背景与方块内部的亮度没有变化,正负权重相互抵消;窗口跨过方块边缘时,才出现明显的正负响应。因此图里看见的是方块轮廓附近的亮带和暗带。
代码只画了输出通道 0。它是一张二维特征图,颜色由 Matplotlib 的色图表示数值大小,紫色和黄色对应较低与较高的响应,不能按原图的物体颜色理解。后面的二维结果也沿用这种显示方式。
4. stride:对输出降采样
stride 是卷积窗口每次移动的距离。 stride 为 1 时,窗口每次移动一个位置,输出比较密;stride 为 2 时,每次移动两个位置,输出采样点减少。二维图像的两个方向都设为 2,输出高宽大致各减半。
这种做法常用于图像网络的下采样阶段:降低后续特征图的空间大小,减少计算与激活内存,并逐步提取更大尺度的特征。代价是空间细节减少,小物体或很窄的边缘可能更难保留,所以需要精细定位的任务往往还会保留高分辨率分支或跳跃连接。
SAME 配合 stride s 时,每个空间维的输出长度是 ceil(输入长度 / s)。这里的 ceil 表示向上取整,因此 SAME 只有在 stride 为 1 时才保持原尺寸。下面的 200×198 会得到 100×99:
out = lax.conv_general_dilated(
    img, kernel, (2, 2), "SAME", (1, 1), (1, 1), dn
)
print("out shape:", out.shape)  # (1, 100, 99, 3)
plt.imshow(np.array(out)[0, :, :, 0])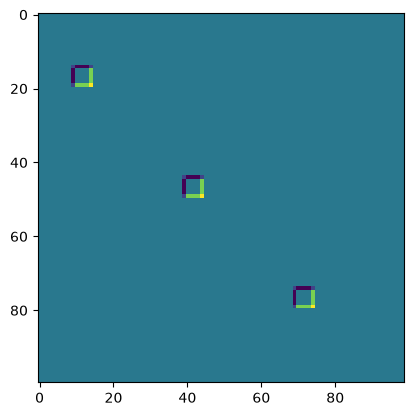
图 3:两个空间方向的 stride 均为 2,输出分辨率减半。
图 3 仍然能看出三个方块的边缘,但数值网格已经更小。绘图库会把小网格铺到相近大小的显示区域,所以肉眼看图片宽度不一定能发现下采样,坐标范围和打印的 shape 才能说明实际分辨率。
stride 卷积是在较稀疏的位置计算卷积响应,并非先把图像缩小再做同一运算。它也不自动保证下采样前完成理想的抗混叠处理,实际效果取决于卷积核和网络设计。
5. rhs dilation:空洞卷积
空洞卷积(dilated convolution)让核内的采样点拉开间距。 普通 3×3 核读取相邻的 9 个位置;dilation 为 2 时,采样点之间隔一个位置,9 个权重覆盖的范围就变成 5×5。权重数量仍然是 9,扩大的是覆盖范围。
一个输出位置能依赖的输入范围称为感受野。对单个卷积层,核大小为 K、dilation 为 d 时,每个方向的有效覆盖长度是 (K-1)×d+1。本例刻意使用 dilation 12,3×3 核就在每个方向覆盖 25 个位置,但仍然只在其中 3 个位置取样。
stride 调整相邻输出窗口的距离,dilation 调整同一个窗口内部的采样间隔。两者可以独立设置。空洞卷积常用于语义分割等需要兼顾上下文范围和空间分辨率的场景:在合适 padding 下,扩大感受野而不降低输出尺寸。多尺度空洞卷积论文讨论了这类上下文聚合方式。
下面仍用 stride 1,但改成 VALID,所以输出因有效核覆盖变大而缩小到 176×174:
out = lax.conv_general_dilated(
    img, kernel, (1, 1), "VALID",
    (1, 1), (12, 12), dn,
)
print("out shape:", out.shape)  # (1, 176, 174, 3)
plt.imshow(np.array(out)[0, :, :, 0])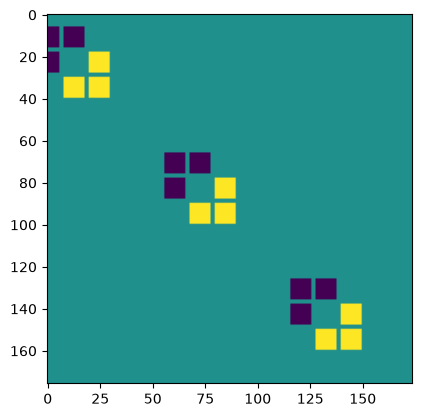
图 4:原文用较大的 dilation 让采样点间隔更明显。
图 4 中,每个方块附近出现了间隔明显的正负响应块:采样点被拉远后,窗口中心移动到不同位置时,会由核的不同采样点碰到同一个方块。这些图案是稀疏采样与当前边缘核共同作用的结果,不表示把输入方块放大了。
较大的 dilation 也会跳过许多相邻位置,连续堆叠不合适的膨胀率可能产生采样空隙。实际网络往往结合不同 dilation 或普通卷积,在覆盖范围和局部连续性之间取舍。
JAX 还提供 lax.conv 和 lax.conv_with_general_padding。它们固定假设图像为 NCHW、卷积核为 OIHW,因此不接收 dimension numbers。
6. 转置卷积
6.1 从提取局部信息到向输出分配贡献
普通卷积可以理解为:从输入的一个局部窗口中汇总出一个输出值。转置卷积则可以从另一个方向理解:让每个输入值按核权重向一片输出位置贡献数值,多个输入贡献重叠时再相加。 配合 stride 大于 1 和合适 padding,输出网格可以变得更大。
它常见于分割网络的解码器、生成网络和一些图像重建网络,把较低分辨率的特征逐步映射到较高分辨率。网络中的核可以学习如何分配这些贡献;本文仍用固定核,只观察运算结构。
“转置”来自线性代数:固定权重后,普通卷积可以写成 y = A x,相应的转置运算使用 Aᵀ。普通卷积反向传播中,对输入求梯度会用到这类转置映射。**Aᵀ 一般不是 A 的逆矩阵,因此转置卷积不能保证恢复卷积前的原图。** 它也常被叫作 deconvolution,但这个名字容易让人误以为是在精确还原被丢失的信息。
下面的 stride 为 2,在当前 kernel、padding 与接口设置下,输出高宽为 400×396:
out = lax.conv_transpose(
    img, kernel,
    (2, 2),
    "SAME",
    dimension_numbers=dn,
    transpose_kernel=True,
)
print("out shape:", out.shape)  # (1, 400, 396, 3)
plt.imshow(np.array(out)[0, :, :, 0])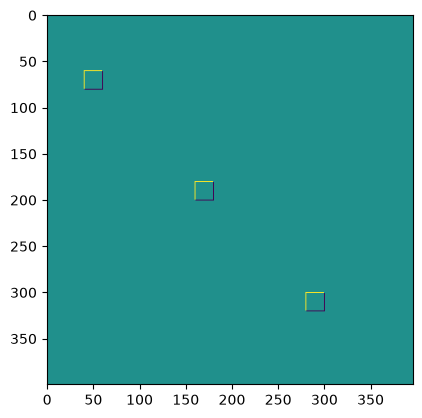
图 5:转置卷积把空间尺寸扩大到输入的两倍。
放大的是输出网格,而不是凭空恢复真实细节。图 5 中的响应来自固定边缘核向较密网格分配贡献;如果用于实际图像生成,权重需要通过对应任务训练。输出尺寸应根据核、stride 和 padding 一起核对,并非所有转置卷积都会恰好放大两倍。
6.2 为什么会涉及输入 dilation
在这个通道权重对称的例子里,可以用旋转 180° 的卷积核、适当 padding 和 lhs/input dilation 表示同一运算:
kernel_rot = jnp.rot90(
    jnp.rot90(kernel, axes=(0, 1)), axes=(0, 1)
)
manual = lax.conv_general_dilated(
    img, kernel_rot,
    (1, 1),
    ((2, 1), (2, 1)),  # 自定义输出 padding
    (2, 2),             # lhs/image dilation
    (1, 1), dn,
)
print("same as conv_transpose:", jnp.allclose(out, manual))
# True
lhs 指输入,rhs 指卷积核。lhs dilation 为 2,可以理解为在相邻输入位置之间插入 0,再做带指定补边的卷积;这是运算的等价解释,底层实现未必真的生成一个插满 0 的大数组。上一节的 rhs dilation 则是在核的采样点之间拉开距离,两者作用的对象不同。
这里手工写了上下、左右各不对称的 (2,1) padding,以匹配当前输出大小和位置对齐。transpose_kernel=True 还涉及空间翻转和输入输出通道的交换;当前例子的各通道组合权重相同,手工表达式才可写得如此简洁。迁移到一般权重时,应按 JAX conv_transpose 接口核对通道含义,不能只旋转二维核就认为完成了全部转换。
工程上还会关注重叠贡献是否均匀,不合适的核与 stride 组合可能带来棋盘格状伪影。另一种常用设计是先用最近邻或双线性插值放大,再接普通卷积;两种方案在参数、计算和生成效果上都有取舍。
7. 一维卷积
一维卷积沿一个序列轴滑动。 它不是说输入只能有一个通道,而是说窗口只沿一个空间或时间方向移动。例如 [N,W,C] 中,W 可以代表音频采样点或时间步,C 可以代表多路传感器、声道或每步特征。
一个长度为 3 的核会汇总相邻 3 个位置及其输入通道,输出一组新特征。常见用途包括音频局部特征提取、时序信号处理和序列模型中的局部模式建模。普通一维卷积只关注窗口内的上下文;对于必须在线预测的任务,还需要合适的因果 padding,避免使用未来采样点。
本例构造两路阶梯状信号,输入 shape 是 [1,200,2],核为 [3,2,2],输出仍有两个通道。它们分别展示变化点与局部通道差异:
# 卷积核:WIO;数据:NWC。
kernel = jnp.array([
    [[1, 0, -1], [-1,  0,  1]],
    [[1, 1,  1], [-1, -1, -1]],
], dtype=jnp.float32).transpose([2, 1, 0])

data = np.zeros((1, 200, 2), dtype=np.float32)
for i in range(2):
    for k in range(2):
        x = 35 * i + 30 + 60 * k
        data[0, x:x + 30, k] = 1.0

plt.figure(figsize=(10, 5))
plt.plot(data[0])
dn = lax.conv_dimension_numbers(
    data.shape, kernel.shape, ("NWC", "WIO", "NWC")
)
out = lax.conv_general_dilated(
    data, kernel, (1,), "SAME", (1,), (1,), dn
)
print("in shapes:", data.shape, kernel.shape)
print(dn)
print("out shape:", out.shape)
plt.figure(figsize=(10, 5))
plt.plot(out[0])
in shapes: (1, 200, 2) (3, 2, 2)
ConvDimensionNumbers(lhs_spec=(0, 2, 1),
rhs_spec=(2, 1, 0), out_spec=(0, 2, 1))
out shape: (1, 200, 2)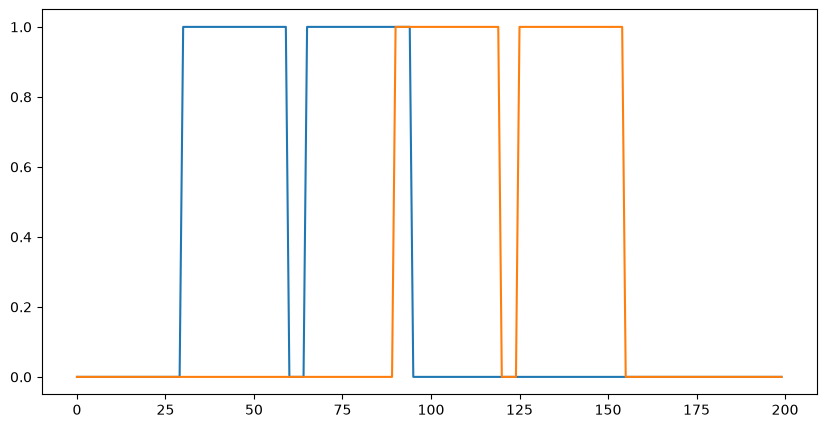
图 6:一维卷积输入。
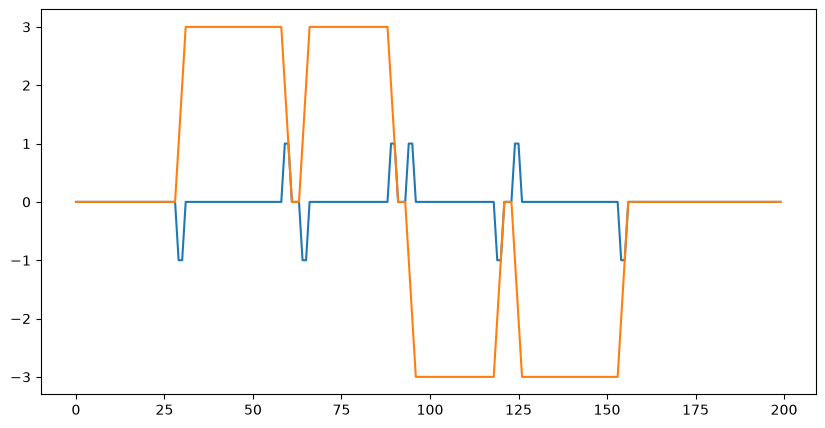
图 7:一维卷积输出。
图 6 的两个输入通道在若干区间从 0 跳到 1,又回到 0。图 7 中,一个输出通道主要在跳变附近出现正负脉冲;另一个输出通道在部分区间形成正负平台。这来自核的具体设置:第一套权重比较窗口两端,第二套权重汇总窗口内两个输入通道的差异。
因此,卷积输出不一定长得像原信号,它是在回答核所定义的局部模式是否存在。核换成平滑权重时,也可以减弱快速波动;换成训练得到的权重,则可以提取适合下游任务的序列特征。
8. 三维卷积
三维卷积沿三个空间或时空轴滑动。 对 CT、MRI 等体数据,三个轴可以是高、宽、深度;对视频,三个轴可以是时间、高、宽。一个 3×3×3 核能够同时汇总这三个方向的局部邻域,而二维卷积只在两个空间方向滑动。
这里的“第三维”不是 RGB 通道。RGB 是每个位置携带的特征,输入、输出通道仍然单独存在。下面的数据布局是 [N,H,W,D,C]:D 表示空间深度,C 才是通道。代码中的 [1,30,30,30,1] 是一份单通道体数据。
三维卷积常用于医学体数据分割、三维场的局部特征处理,以及视频动作识别。视频场景中,它能把相邻帧的变化一起纳入计算,例如 C3D 论文中的时空特征提取。相应的代价是额外一个滑动维度带来的参数、计算和激活内存开销。
下面用三角函数生成连续变化的三维数值场,再应用一个固定的 3×3×3 核:
import matplotlib as mpl

# 卷积核:HWDIO。
kernel = jnp.array([
    [[0, 0, 0], [0, 1, 0], [0, 0, 0]],
    [[0,-1, 0], [-1,0,-1], [0,-1,0]],
    [[0, 0, 0], [0, 1, 0], [0, 0, 0]],
], dtype=jnp.float32)[:, :, :, jnp.newaxis, jnp.newaxis]

# 数据:NHWDC。
data = jnp.zeros((1, 30, 30, 30, 1), dtype=jnp.float32)
x, y, z = np.mgrid[0:1:30j, 0:1:30j, 0:1:30j]
data += (
    jnp.sin(2*x*jnp.pi)
    * jnp.cos(2*y*jnp.pi)
    * jnp.cos(2*z*jnp.pi)
)[None, :, :, :, None]

dn = lax.conv_dimension_numbers(
    data.shape, kernel.shape, ("NHWDC", "HWDIO", "NHWDC")
)
out = lax.conv_general_dilated(
    data, kernel, (1,1,1), "SAME",
    (1,1,1), (1,1,1), dn,
)

def make_alpha(cmap):
    my_cmap = cmap(jnp.arange(cmap.N))
    my_cmap[:, -1] = jnp.linspace(0, 1, cmap.N) ** 3
    return mpl.colors.ListedColormap(my_cmap)

my_cmap = make_alpha(plt.cm.viridis)
for title, values in (("input", data), ("3D conv output", out)):
    fig = plt.figure()
    ax = fig.add_subplot(projection="3d")
    ax.scatter(x.ravel(), y.ravel(), z.ravel(),
               c=values.ravel(), cmap=my_cmap)
    ax.axis("off")
    ax.set_title(title)

print("in shapes:", data.shape, kernel.shape)
print(dn)
print("out shape:", out.shape)
in shapes: (1, 30, 30, 30, 1) (3, 3, 3, 1, 1)
ConvDimensionNumbers(lhs_spec=(0, 4, 1, 2, 3),
rhs_spec=(4, 3, 0, 1, 2), out_spec=(0, 4, 1, 2, 3))
out shape: (1, 30, 30, 30, 1)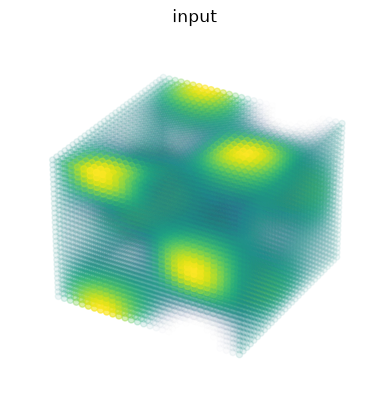
图 8:三维卷积输入体数据。
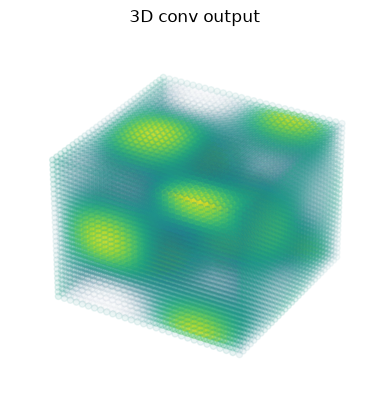
图 9:三维卷积输出体数据。
图 8、图 9 的散点坐标仍然是原来的三维网格,颜色和透明度则由各位置数值映射得到。卷积后变化的是体数据的数值分布,并没有移动这些点;输出 shape 仍为 [1,30,30,30,1],原因是 stride 为 1 并采用 SAME padding。
这个固定核包含不同方向上的正负权重,会改变邻域变化在输出中的响应。它不是对所有方向对称的平滑核,所以不应把图 9 简单理解为“更平滑”或“更清晰”。实际用途取决于核的权重和训练目标。
9. 从形状变化理解这些设置
对一个普通卷积空间轴,先算有效核大小 K_eff = (K-1)×dilation+1。在没有输入 dilation 的情况下,显式补边后的输出长度为:
输出长度 = floor((输入长度 + 前侧 padding + 后侧 padding - K_eff) / stride) + 1floor 表示向下取整。本文的几个二维例子可以直接代入:
- 普通
3×3、stride 1、SAME:输入200×198,输出200×198。 - 普通
3×3、stride 2、SAME:输出100×99,降低输出采样密度。 3×3、dilation 12、stride 1、VALID:有效核为25×25,输出176×174,单个输出覆盖的输入范围更大。- 本文的 stride 2 转置卷积:输出
400×396,在更大的网格上累加输入贡献。
阅读或替换卷积算子时,可以先明确输入轴含义和通道数,再看核大小、padding、stride 与 dilation,最后核对输出 shape 和边界响应。涉及数值对齐时,还要比较权重方向、通道布局和输出位置是否一致;只对齐 shape,可能漏掉空间偏移或错误的通道解释。完整参数定义见 JAX 通用卷积 API。